
Diffusers documentation
OmniGen
OmniGen
OmniGen: Unified Image Generation da BAAI, por Shitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu.
O resumo do artigo é:
O surgimento dos Large Language Models (LLMs) unificou as tarefas de geração de linguagem e revolucionou a interação humano-máquina. No entanto, no âmbito da geração de imagens, um modelo unificado capaz de lidar com diversas tarefas em um único framework permanece em grande parte inexplorado. Neste trabalho, apresentamos o OmniGen, um novo modelo de difusão para geração unificada de imagens. O OmniGen é caracterizado pelas seguintes funcionalidades: 1) Unificação: o OmniGen não apenas demonstra capacidades de geração de texto para imagem, mas também suporta intrinsicamente diversas tarefas downstream, como edição de imagem, geração dirigida por sujeito e geração condicional visual. 2) Simplicidade: a arquitetura do OmniGen é altamente simplificada, eliminando a necessidade de plugins adicionais. Além disso, em comparação com modelos de difusão existentes, ele é mais amigável ao usuário e pode concluir tarefas complexas de ponta a ponta por meio de instruções, sem a necessidade de etapas intermediárias extras, simplificando enormemente o fluxo de trabalho de geração de imagens. 3) Transferência de conhecimento: beneficiando-se do aprendizado em um formato unificado, o OmniGen transfere conhecimento de forma eficaz entre diferentes tarefas, gerencia tarefas e domínios não vistos e exibe capacidades novas. Também exploramos as capacidades de raciocínio do modelo e as aplicações potenciais do mecanismo de chain-of-thought. Este trabalho representa a primeira tentativa de um modelo de geração de imagens de uso geral, e disponibilizaremos nossos recursos em https://github.com/VectorSpaceLab/OmniGen para fomentar avanços futuros.
Certifique-se de consultar o guia de Schedulers para aprender a explorar o compromisso entre a velocidade e a qualidade do scheduler, e veja a seção reutilização de componentes entre pipelines para aprender a carregar eficientemente os mesmos componentes em vários pipelines.
Este pipeline foi contribuído por staoxiao. A base de código original pode ser encontrada aqui. Os pesos originais podem ser encontrados em hf.co/shitao.
Carregar checkpoints de modelos
Os pesos do modelo podem estar armazenados em subpastas separadas no Hub ou localmente, caso em que você deve usar o método from_pretrained().
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", dtype=torch.bfloat16)
Texto para imagem
Para texto-para-imagem, passe um prompt de texto. Por padrão, o OmniGen gera uma imagem de 1024x1024.
Você pode tentar definir os parâmetros height e width para gerar imagens com tamanhos diferentes.
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Realistic photo. A young woman sits on a sofa, holding a book and facing the camera. She wears delicate silver hoop earrings adorned with tiny, sparkling diamonds that catch the light, with her long chestnut hair cascading over her shoulders. Her eyes are focused and gentle, framed by long, dark lashes. She is dressed in a cozy cream sweater, which complements her warm, inviting smile. Behind her, there is a table with a cup of water in a sleek, minimalist blue mug. The background is a serene indoor setting with soft natural light filtering through a window, adorned with tasteful art and flowers, creating a cozy and peaceful ambiance. 4K, HD."
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=3,
    generator=torch.Generator(device="cpu").manual_seed(111),
).images[0]
image.save("output.png")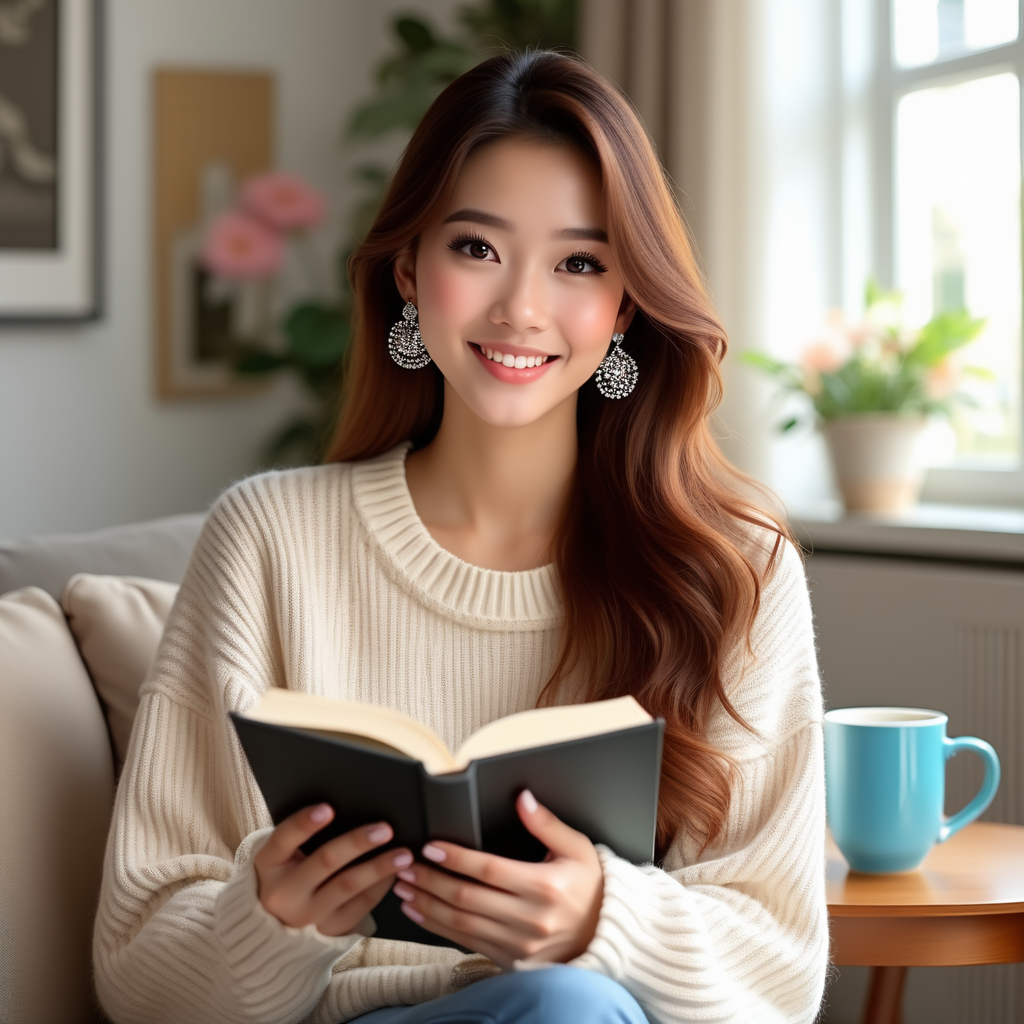
Edição de imagem
OmniGen suporta entradas multimodais.
Quando a entrada inclui uma imagem, é necessário adicionar um marcador <img><|image_1|></img> no prompt de texto para representar a imagem.
Recomenda-se habilitar use_input_image_size_as_output para manter a imagem editada com o mesmo tamanho da imagem original.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="<img><|image_1|></img> Remove the woman's earrings. Replace the mug with a clear glass filled with sparkling iced cola."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/t2i_woman_with_book.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(222)
).images[0]
image.save("output.png") 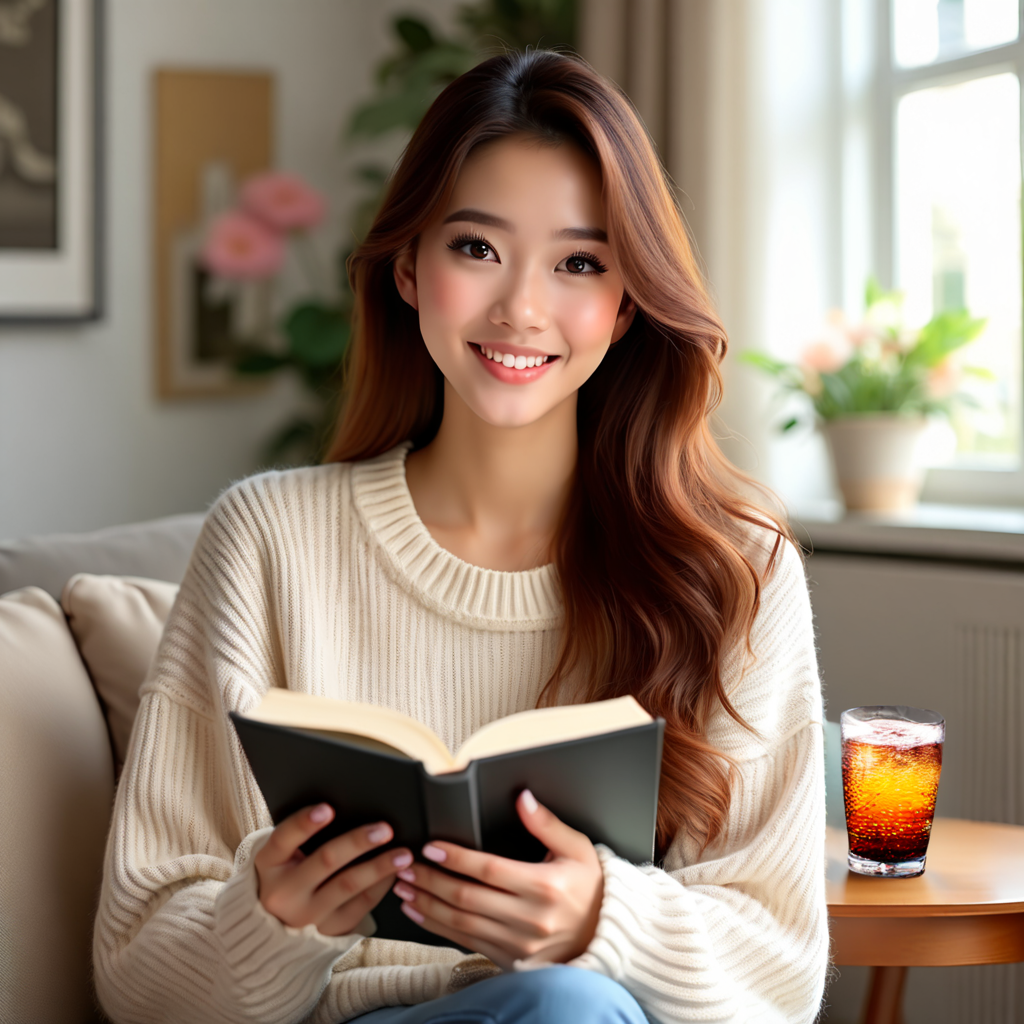
O OmniGen possui algumas funcionalidades interessantes, como o raciocínio visual, conforme mostrado no exemplo abaixo.
prompt="If the woman is thirsty, what should she take? Find it in the image and highlight it in blue. <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")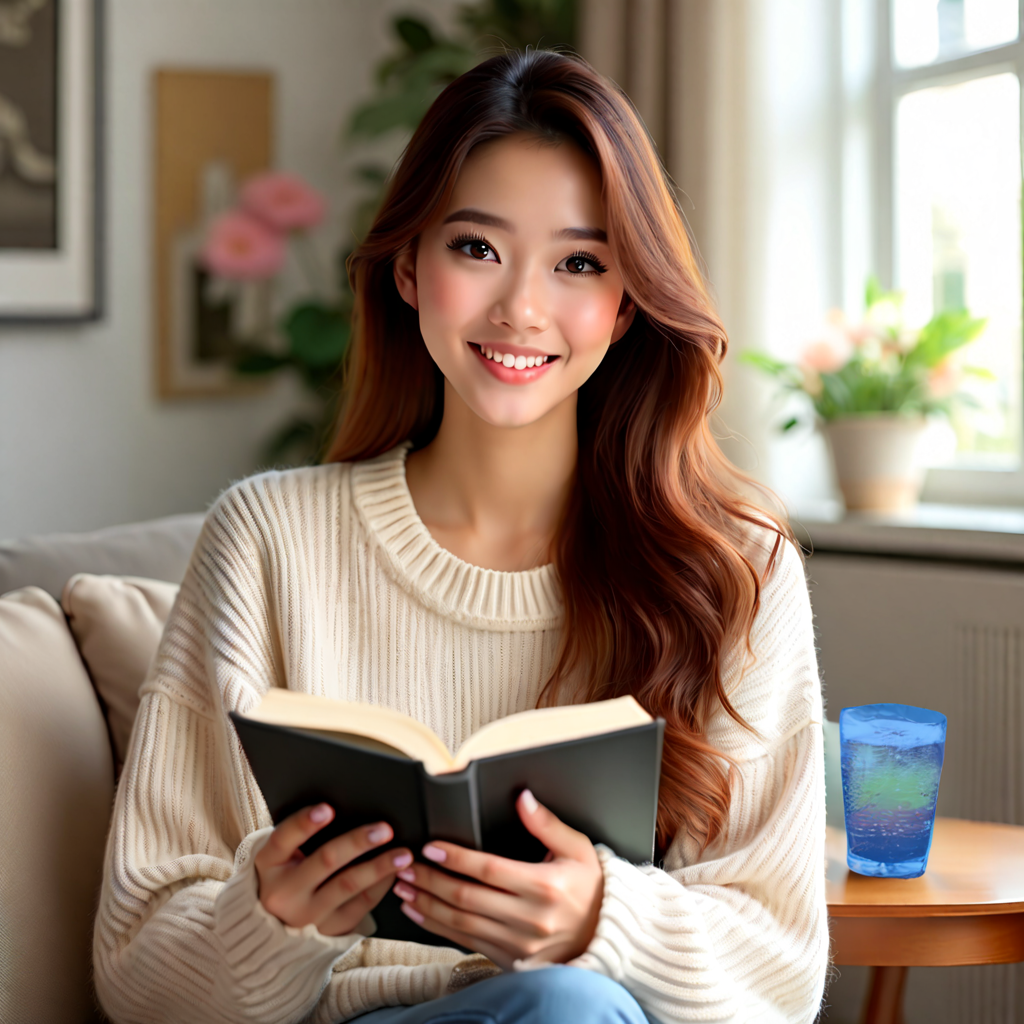
Geração controlável
OmniGen pode lidar com várias tarefas clássicas de visão computacional. Como mostrado abaixo, o OmniGen pode detectar esqueletos humanos em imagens de entrada, que podem ser usados como condições de controle para gerar novas imagens.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Detect the skeleton of human in this image: <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image1 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image1.save("image1.png")

prompt="Generate a new photo using the following picture and text as conditions: <img><|image_1|></img>\n A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/skeletal.png")]
image2 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image2.save("image2.png") 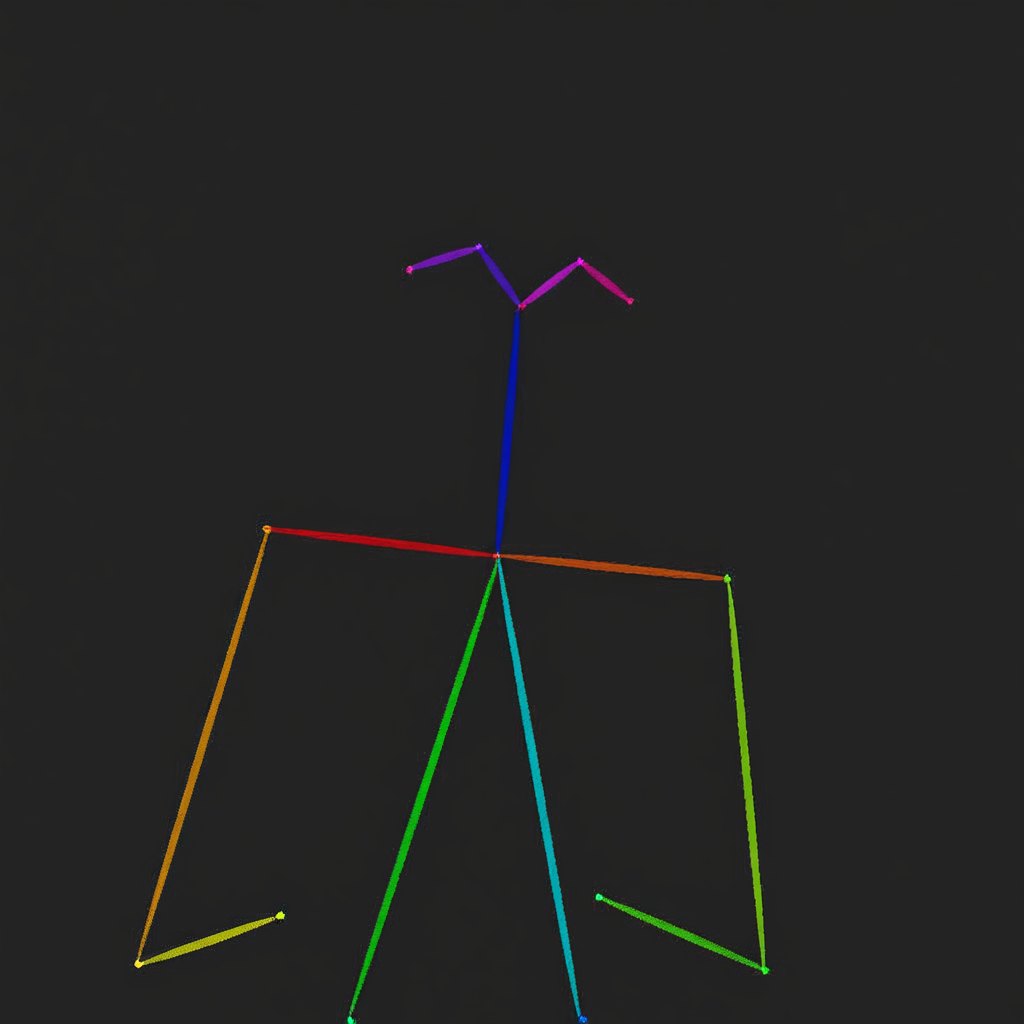
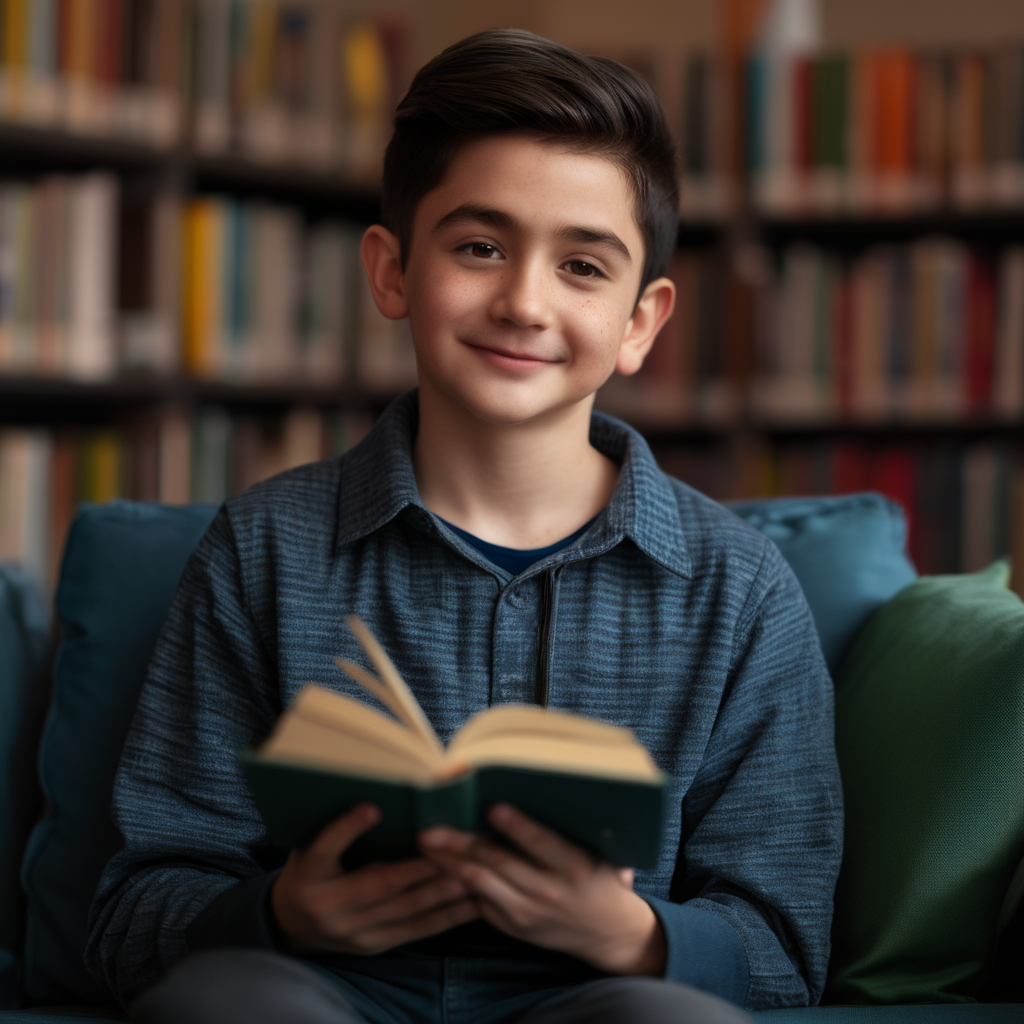
O OmniGen também pode usar diretamente informações relevantes de imagens de entrada para gerar novas imagens.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Following the pose of this image <img><|image_1|></img>, generate a new photo: A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")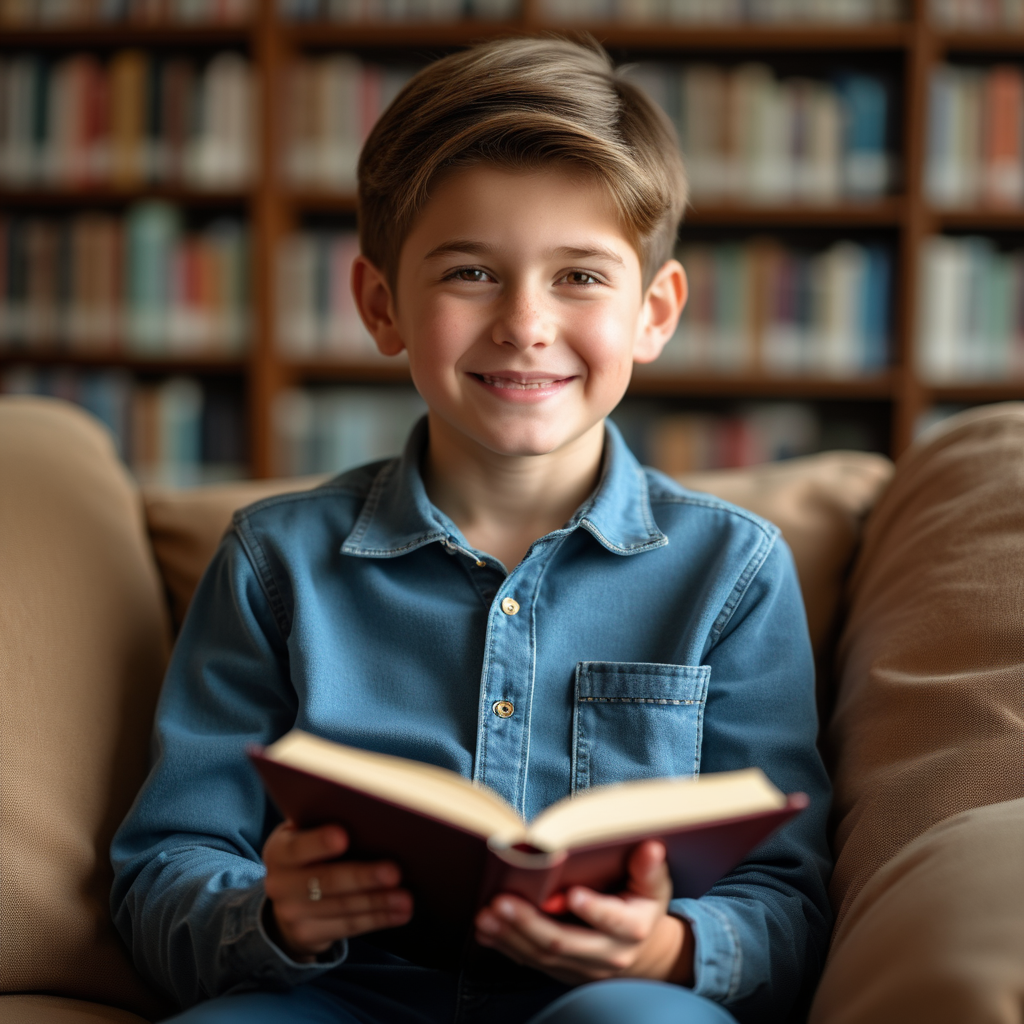
Preservação de ID e objeto
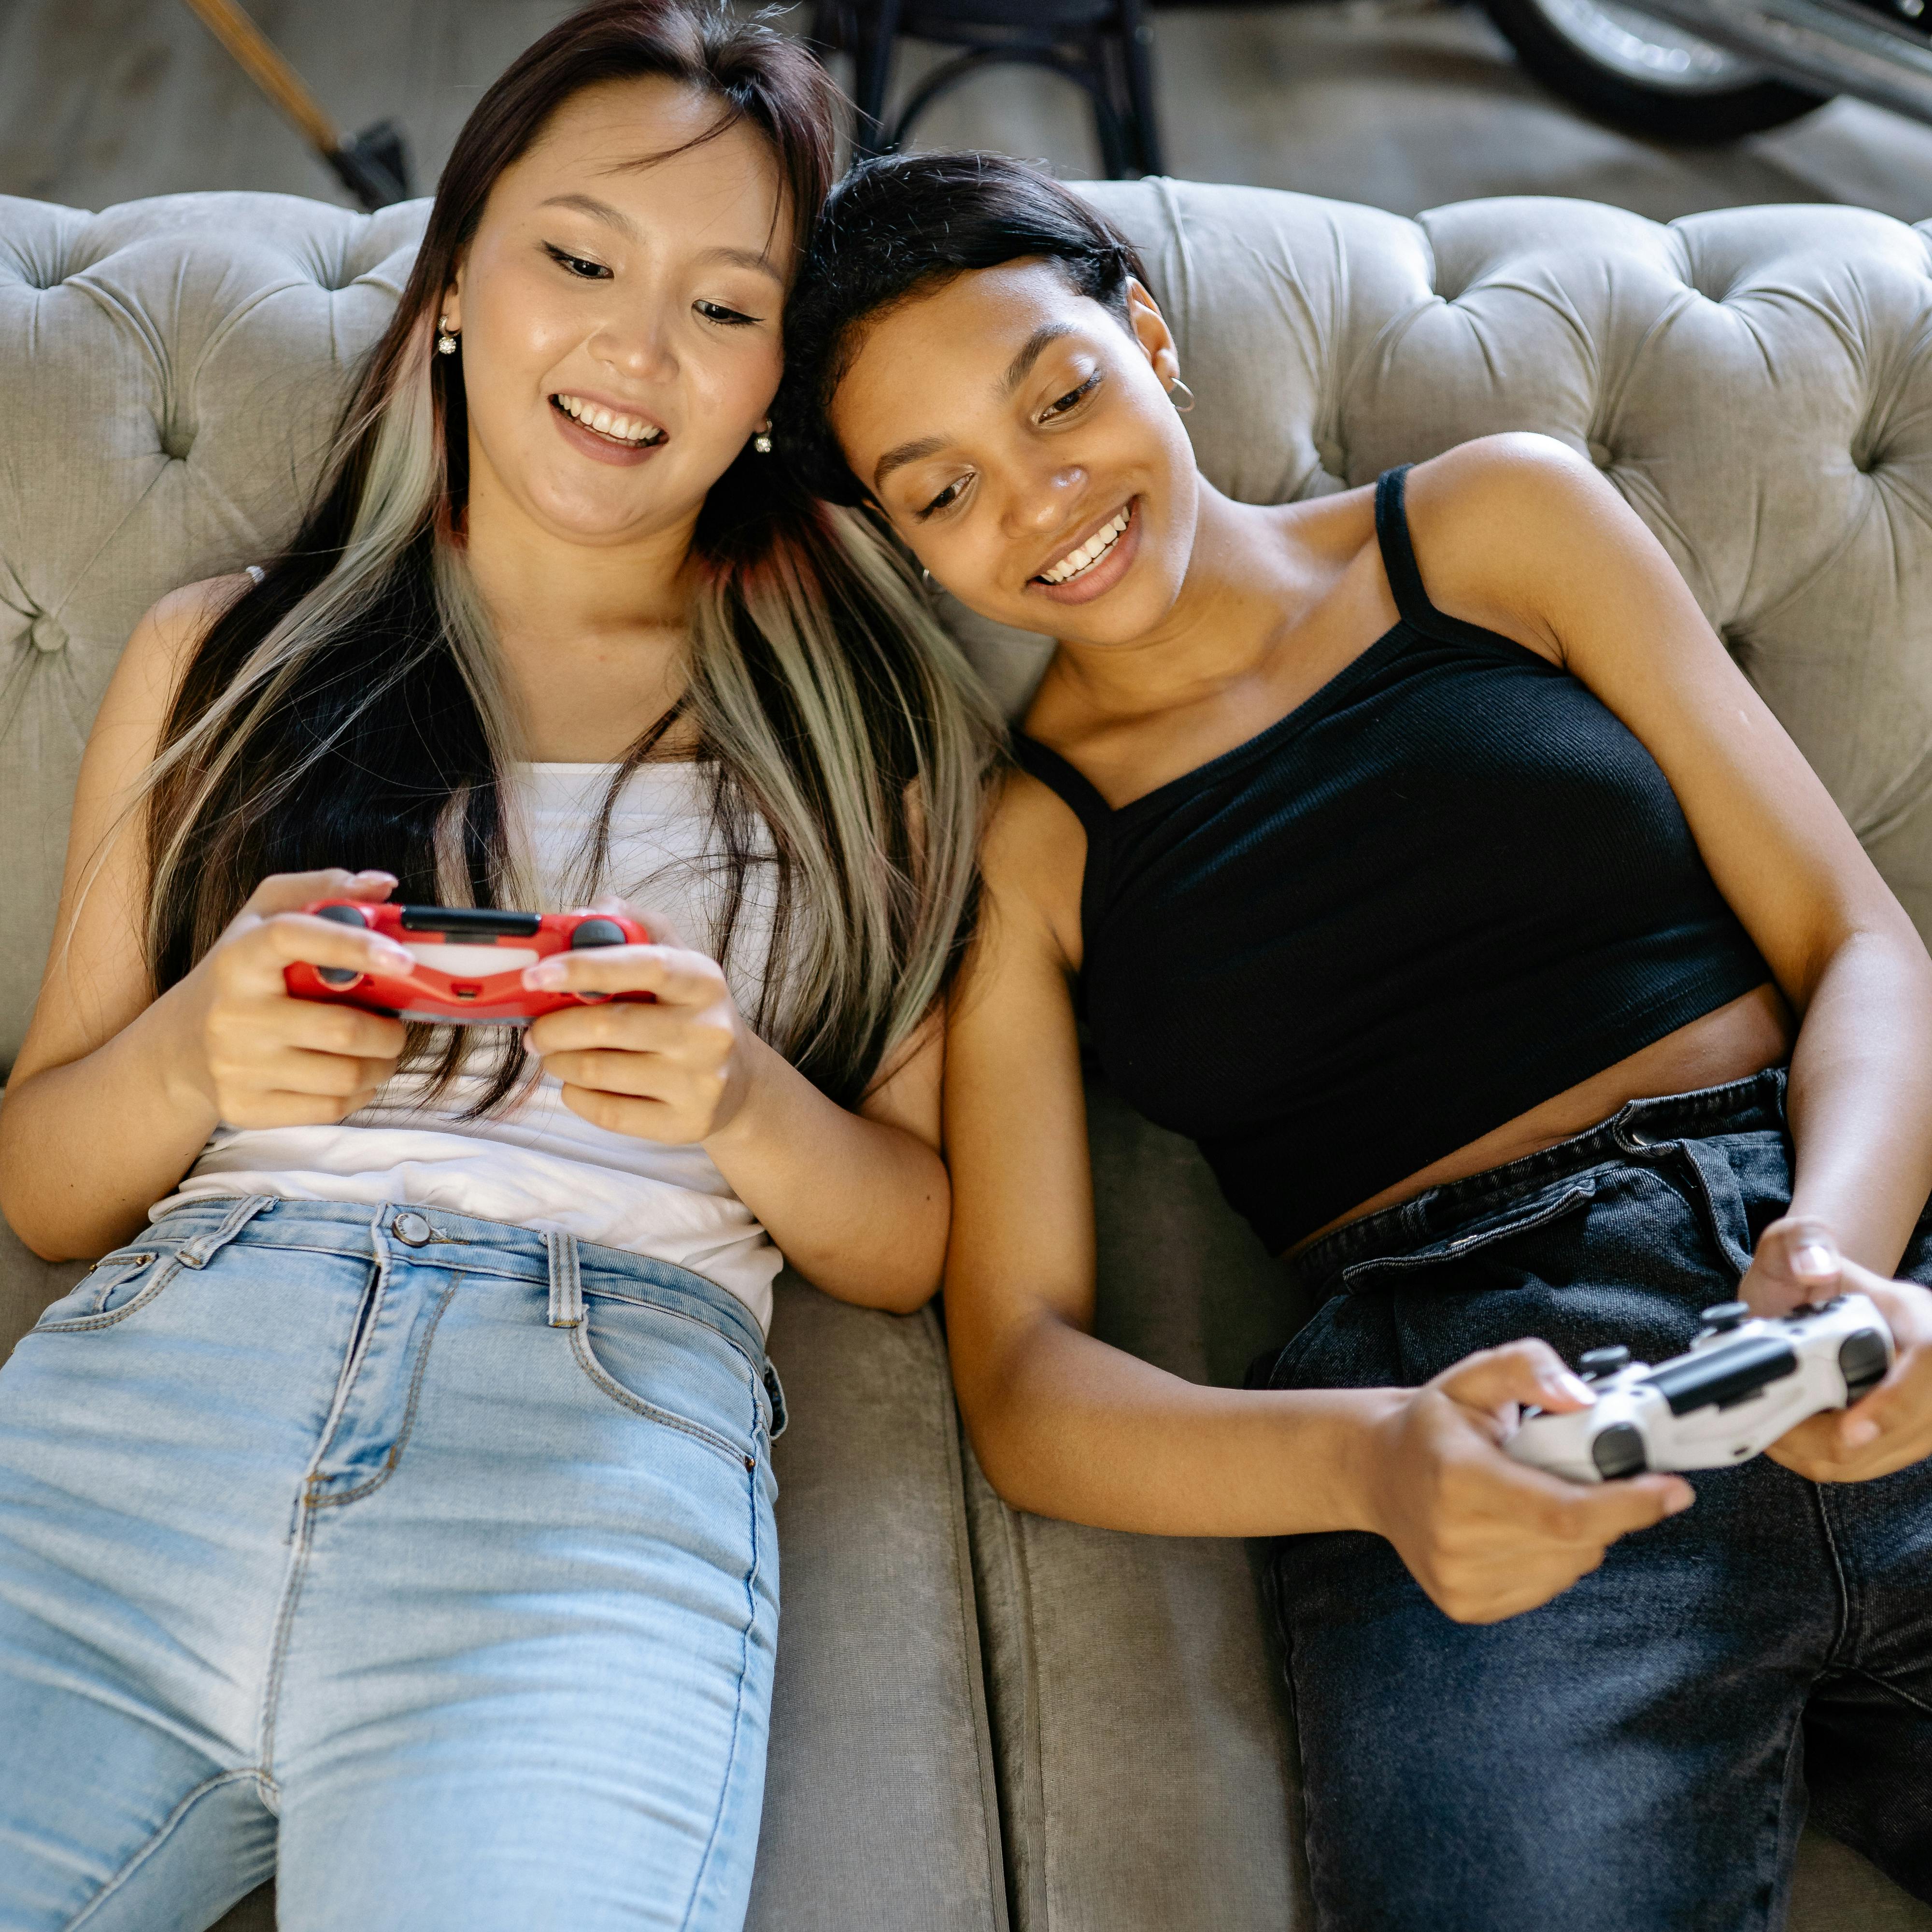
OmniGen pode gerar múltiplas imagens com base nas pessoas e objetos da imagem de entrada e suporta a entrada de múltiplas imagens simultaneamente. Além disso, OmniGen pode extrair objetos desejados de uma imagem contendo múltiplos objetos com base em instruções.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>"
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/3.png")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/4.png")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")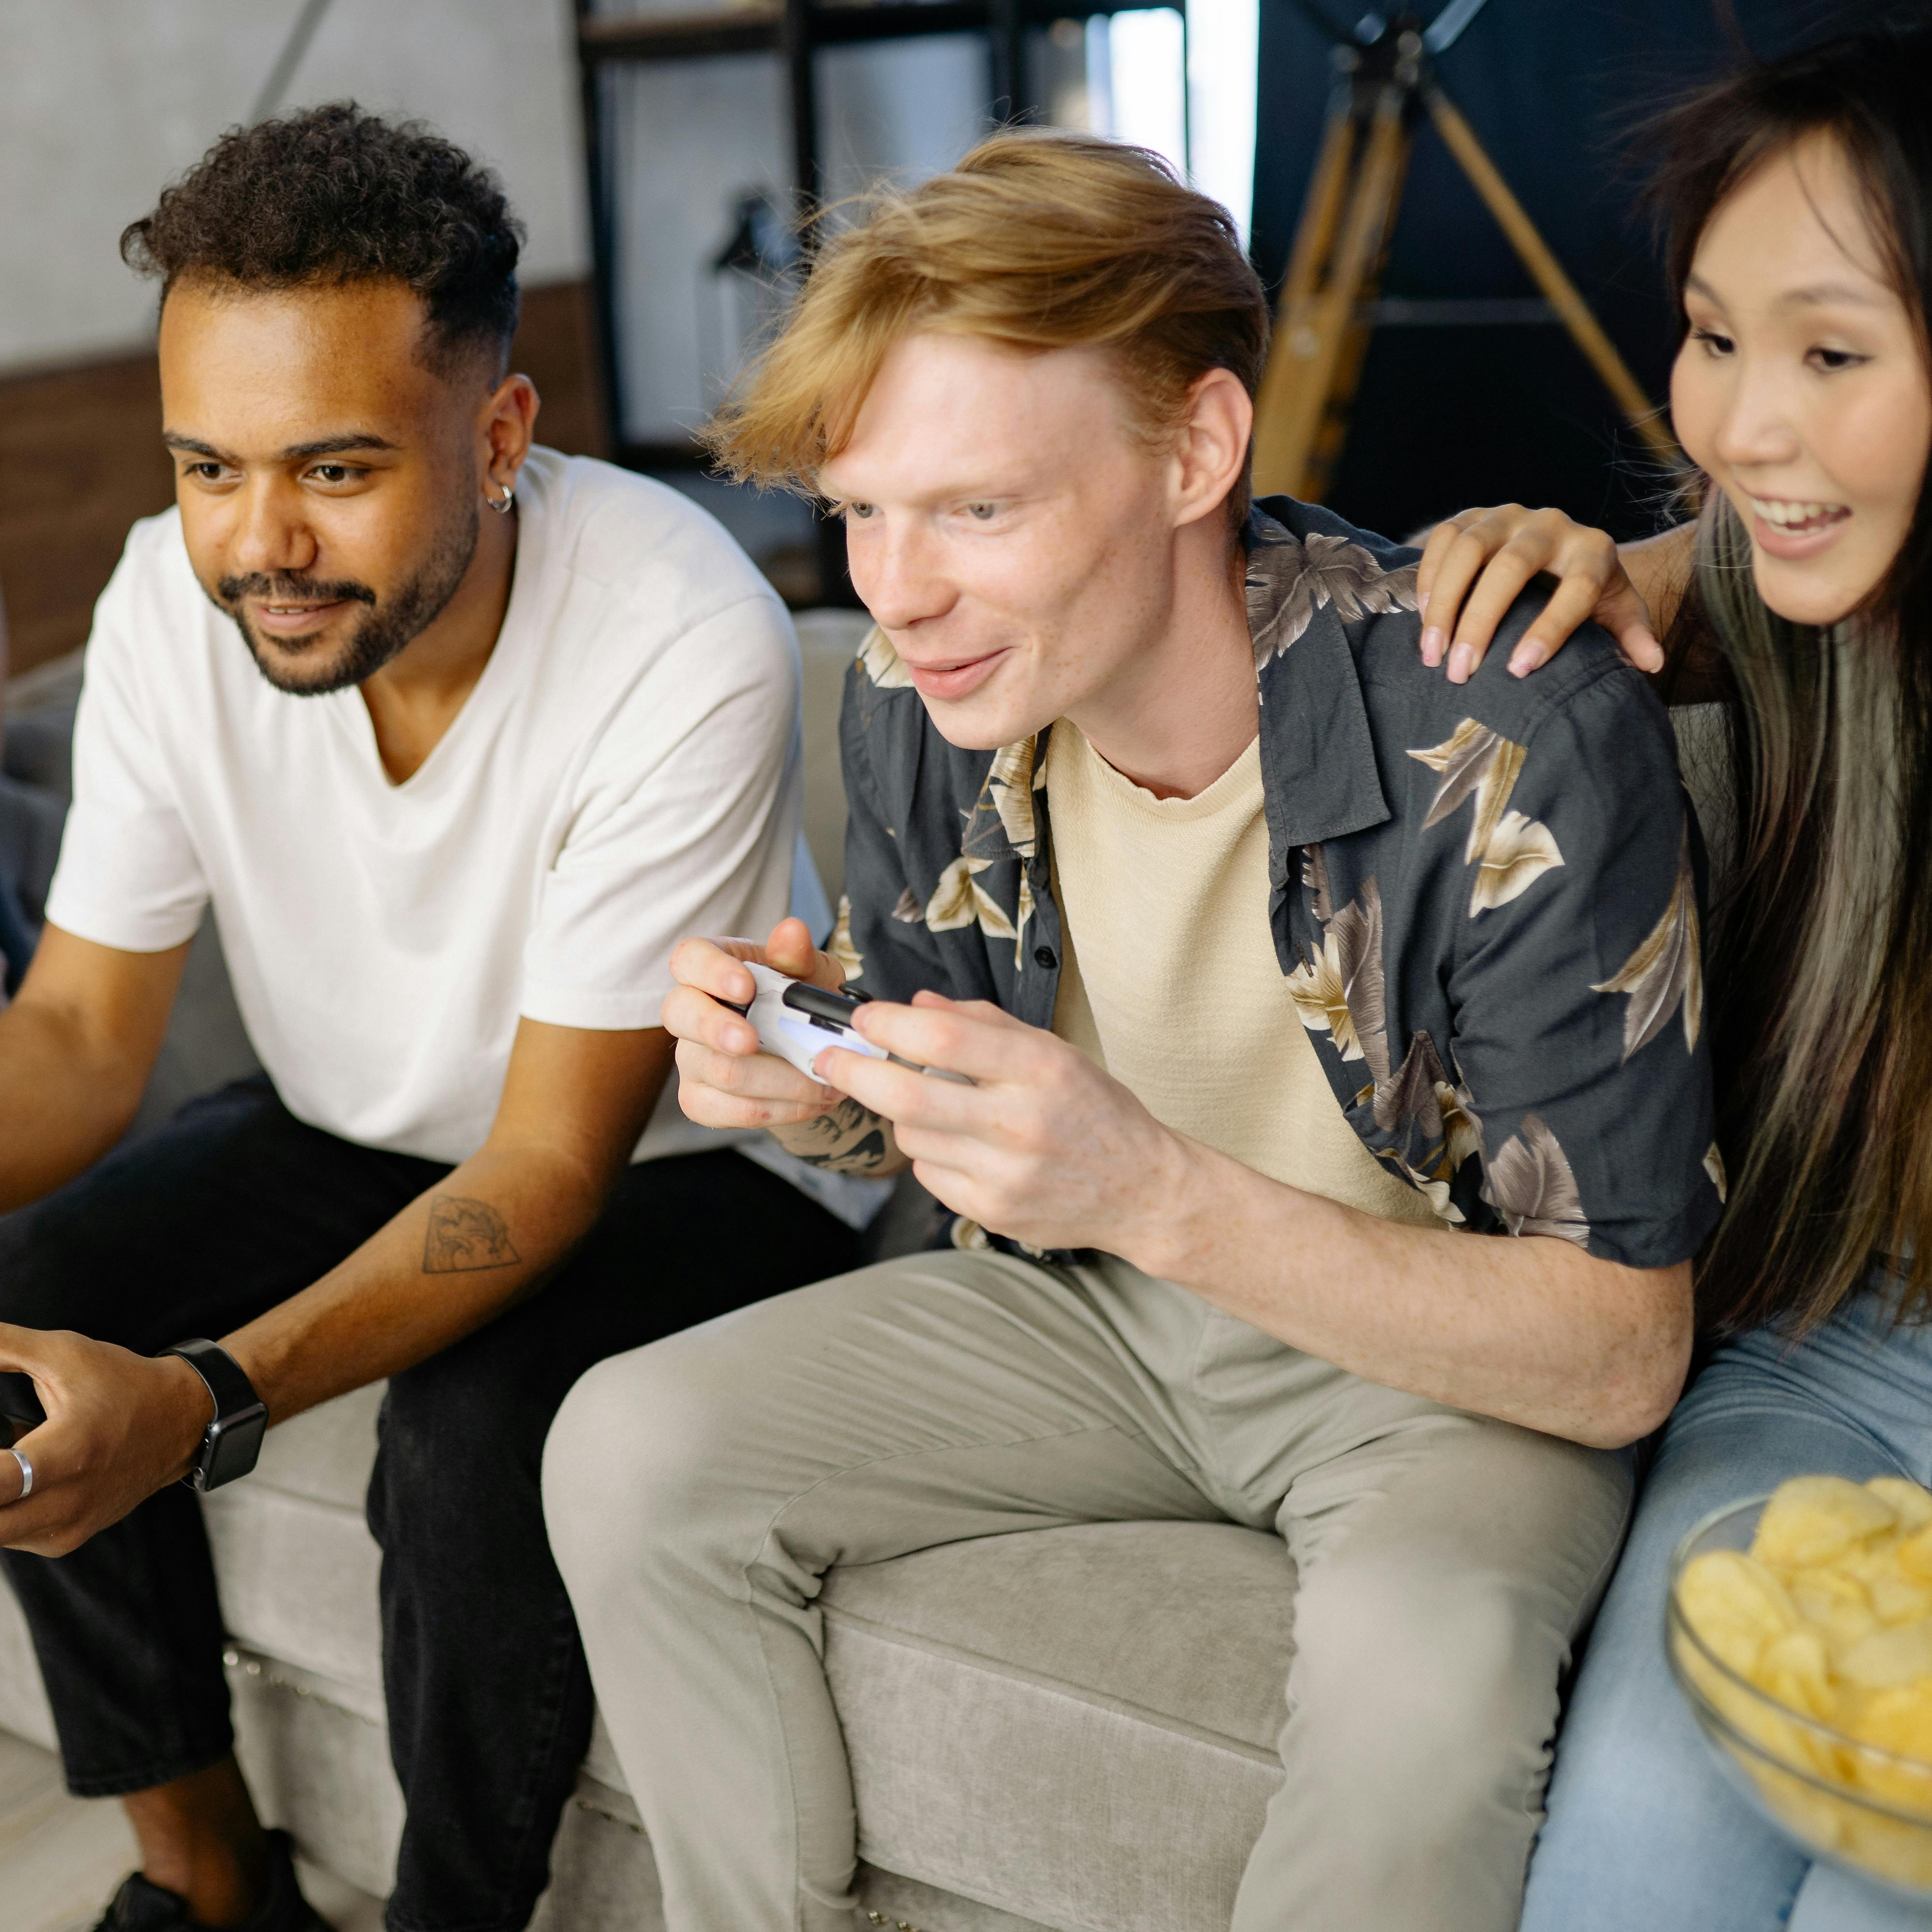
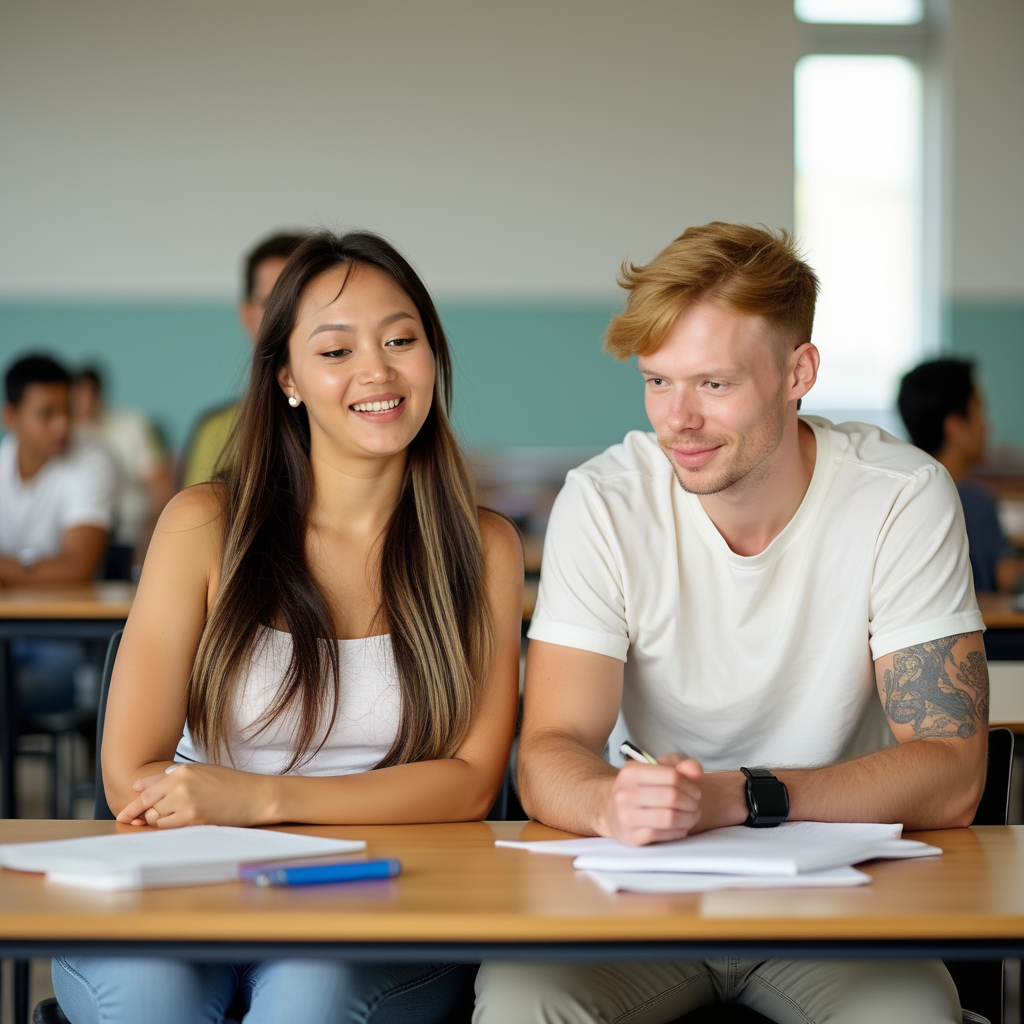
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

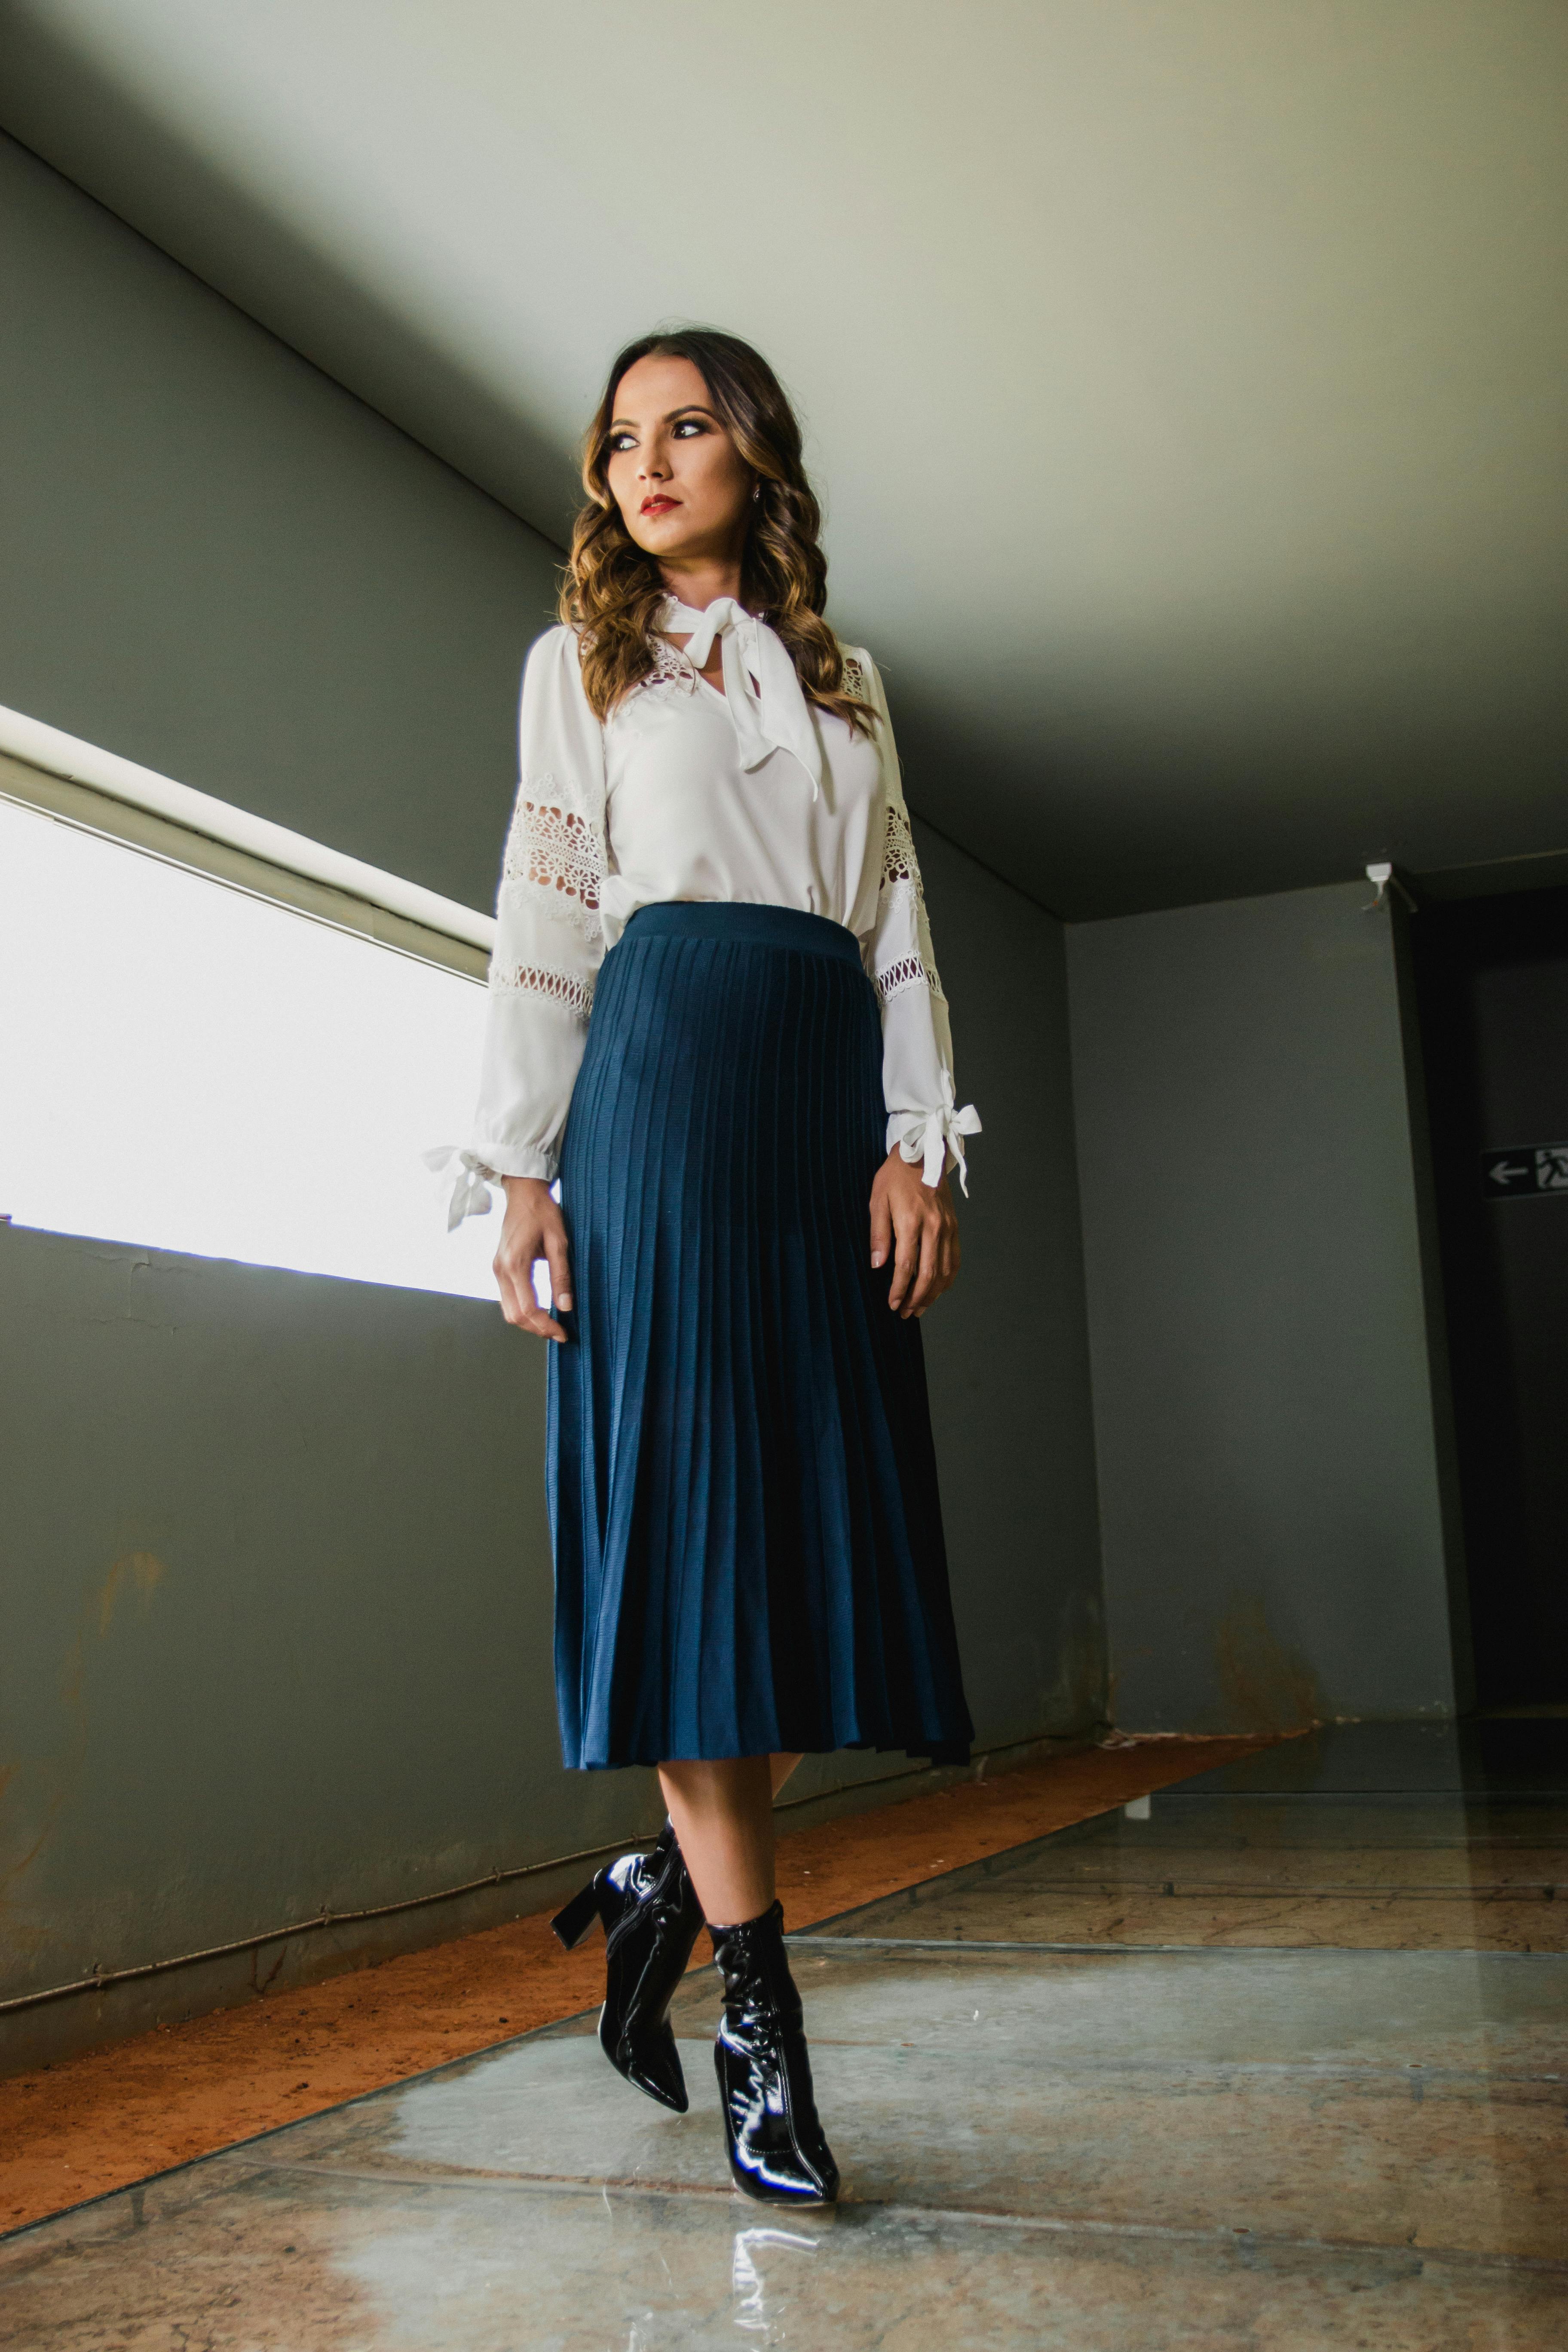
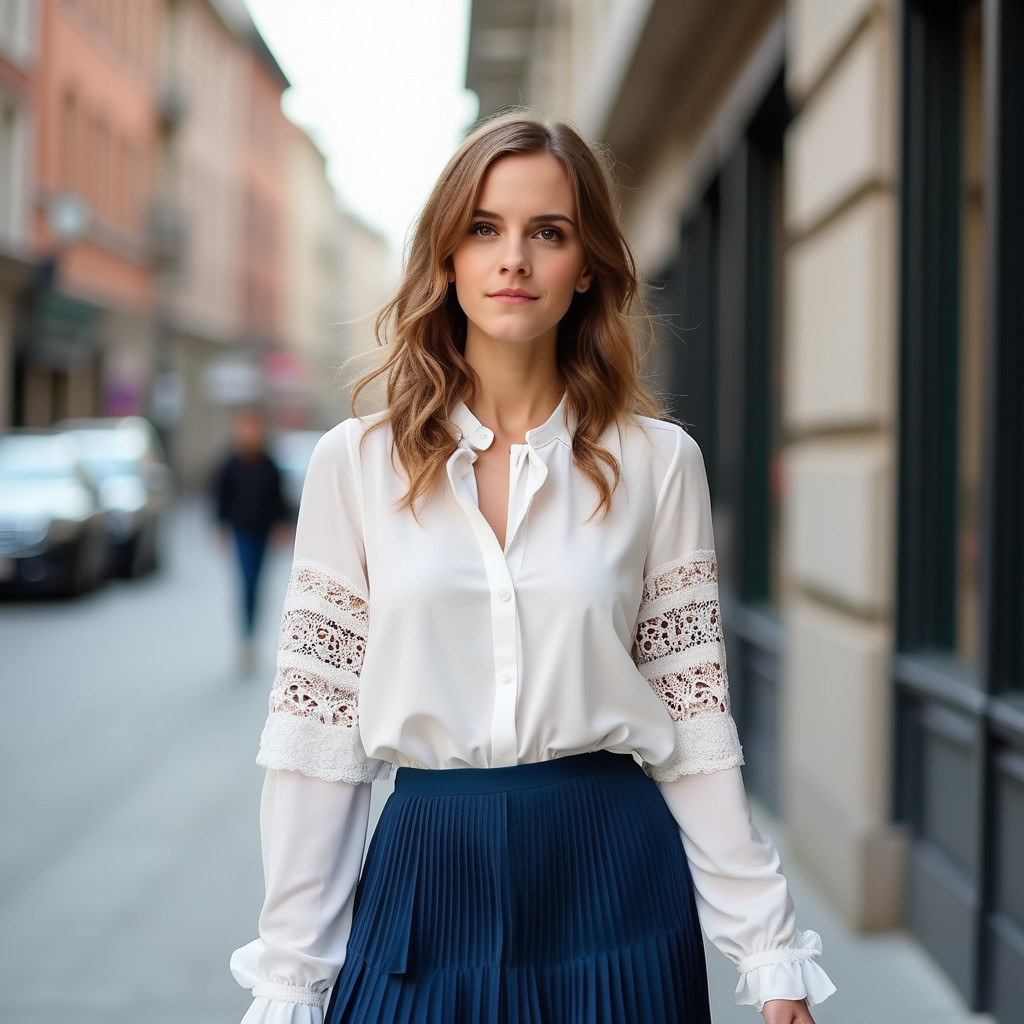
prompt="A woman is walking down the street, wearing a white long-sleeve blouse with lace details on the sleeves, paired with a blue pleated skirt. The woman is <img><|image_1|></img>. The long-sleeve blouse and a pleated skirt are <img><|image_2|></img>."
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/emma.jpeg")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/dress.jpg")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")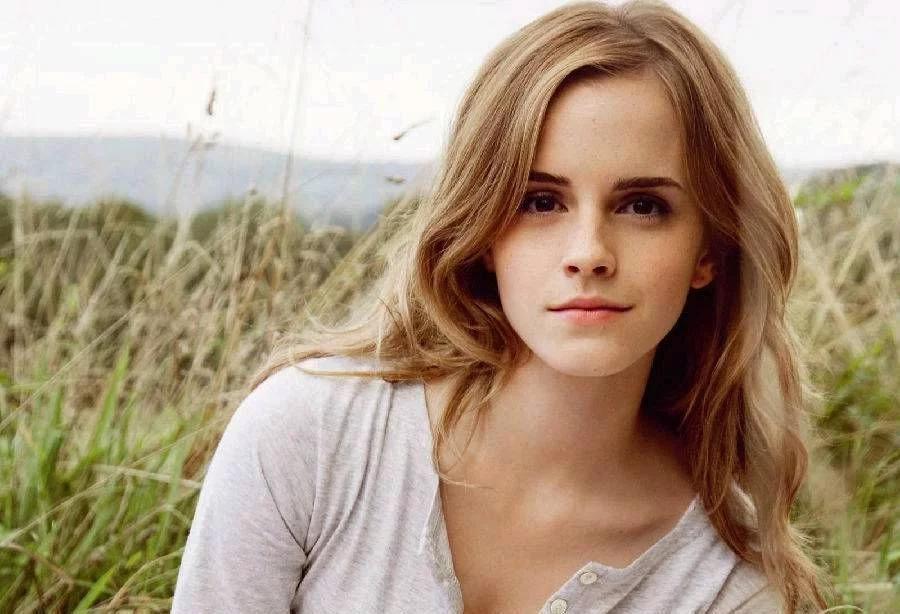
Otimização ao usar múltiplas imagens
Para a tarefa de texto para imagem, o OmniGen requer custos mínimos de memória e tempo (9 GB de memória e 31 s para uma imagem de 1024x1024 em uma GPU A800). No entanto, ao usar imagens de entrada, o custo computacional aumenta.
Aqui estão algumas diretrizes para ajudar a reduzir os custos computacionais ao usar múltiplas imagens. Os experimentos são conduzidos em uma GPU A800 com duas imagens de entrada.
Assim como outros pipelines, você pode reduzir o uso de memória ao descarregar o modelo: pipe.enable_model_cpu_offload() ou pipe.enable_sequential_cpu_offload().
No OmniGen, você também pode diminuir a sobrecarga computacional reduzindo o max_input_image_size.
O consumo de memória para diferentes tamanhos de imagem é mostrado na tabela abaixo:
| Método | Uso de Memória |
|---|---|
| max_input_image_size=1024 | 40GB |
| max_input_image_size=512 | 17GB |
| max_input_image_size=256 | 14GB |
OmniGenPipeline
classe diffusers.OmniGenPipeline
< source >( transformer: OmniGenTransformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtokenizer: LlamaTokenizer )
Parâmetros
- transformer (OmniGenTransformer2DModel) — Arquitetura de Transformer autoregressiva para OmniGen.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Um scheduler a ser usado em combinação com
transformerpara desruidar os latentes da imagem codificada. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens para e a partir de representações latentes.
- tokenizer (
LlamaTokenizer) — Tokenizador de texto da classe LlamaTokenizer.
O pipeline OmniGen para geração de imagem a partir de multimodal.
Referência: https://huggingface.co/papers/2409.11340
__call__
< source >( prompt: str | list[str]input_images: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50max_input_image_size: int = 1024timesteps: list = Noneguidance_scale: float = 2.5img_guidance_scale: float = 1.6use_input_image_size_as_output: bool = Falsenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents'] ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str], opcional) — O prompt ou os prompts para orientar a geração da imagem. Se a entrada incluir imagens, é necessário adicionar placeholders<img><|image_i|></img>no prompt para indicar a posição da i-ésima imagem. - input_images (
PipelineImageInputoulist[PipelineImageInput], opcional) — A lista de imagens de entrada. Substituiremos o ”<|image_i|>” no prompt pela i-ésima imagem da lista. - height (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A altura em pixels da imagem gerada. Isso é definido como 1024 por padrão para os melhores resultados. - width (
int, opcional, padrão é self.unet.config.sample_size * self.vae_scale_factor) — A largura em pixels da imagem gerada. O padrão é 1024 para os melhores resultados. - num_inference_steps (
int, opcional, padrão 50) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - max_input_image_size (
int, opcional, padrão 1024) — o tamanho máximo da imagem de entrada, que será usado para recortar a imagem de entrada para o tamanho máximo - timesteps (
list[int], opcional) — Timesteps personalizados para usar no processo de remoção de ruído com agendadores que suportam um argumentotimestepsem seu métodoset_timesteps. Se não definido, o comportamento padrão quandonum_inference_stepsé passado será usado. Deve estar em ordem decrescente. - guidance_scale (
float, opcional, padrão 2.5) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2. do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - img_guidance_scale (
float, opcional, padrão 1.6) — Definido como a equação 3 em Instrucpix2pix. - use_input_image_size_as_output (bool, padrão False) — se deve usar o tamanho da imagem de entrada como o tamanho da imagem de saída, o que pode ser usado para entrada de imagem única, por exemplo, em tarefas de edição de imagem
- num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre PIL:PIL.Image.Imageounp.array. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um~pipelines.flux.FluxPipelineOutputem vez de uma tupla simples. - callback_on_step_end (
Callable, opcional) — Uma função que é chamada no final de cada etapa de desruidamento durante a inferência. A função é chamada com os seguintes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá uma lista de todos os tensores, conforme especificado porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — A lista de entradas de tensor para a funçãocallback_on_step_end. Os tensores especificados na lista serão passados como argumentocallback_kwargs. Você só poderá incluir variáveis listadas no atributo._callback_tensor_inputsda sua classe de pipeline.
Retorna
ImagePipelineOutput ou tuple
ImagePipelineOutput se return_dict for True,
caso contrário, uma tuple. Ao retornar uma tupla, o primeiro elemento é uma lista com as imagens geradas.
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> import torch
>>> from diffusers import OmniGenPipeline

>>> pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")

>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=50, guidance_scale=2.5).images[0]
>>> image.save("output.png")
Retorna: ImagePipelineOutput ou tuple:
Se return_dict for True, ImagePipelineOutput é retornado; caso contrário, uma tuple é retornada,
em que o primeiro elemento é uma lista com as imagens geradas.
encode_input_images
< source >( input_pixel_values: listdevice: typing.Optional[torch.device] = Nonedtype: typing.Optional[torch.dtype] = None )
obter o embedding contínuo das imagens de entrada pelo VAE
Retorna: torch.Tensor