
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 foi criado por Arseniy Shakhmatov, Anton Razzhigaev, Aleksandr Nikolich, Vladimir Arkhipkin, Igor Pavlov, Andrey Kuznetsov e Denis Dimitrov.
A descrição em sua página no GitHub é:
O Kandinsky 2.1 herda as melhores práticas do Dall-E 2 e da difusão latente, ao mesmo tempo em que introduz algumas ideias novas. Como codificador de texto e imagem, ele utiliza o modelo CLIP e um prior de difusão de imagem (mapeamento) entre os espaços latentes das modalidades do CLIP. Essa abordagem aumenta o desempenho visual do modelo e abre novos horizontes na fusão de imagens e na manipulação de imagens guiada por texto.
O código-fonte original pode ser encontrado em ai-forever/Kandinsky-2.
Confira a organização Kandinsky Community no Hub para os checkpoints oficiais de modelos para tarefas como text-to-image, image-to-image e inpainting.
Certifique-se de consultar o guia de Schedulers para aprender a explorar o compromisso entre a velocidade e a qualidade do scheduler, e veja a seção reutilização de componentes entre pipelines para aprender a carregar eficientemente os mesmos componentes em vários pipelines.
Certifique-se de que as seguintes bibliotecas estão instaladas.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
O uso de Kandinsky 2.1 e 2.2 é muito semelhante! A única diferença é que o Kandinsky 2.2 não aceita
promptcomo entrada ao decodificar os latentes. Em vez disso, o Kandinsky 2.2 aceita apenasimage_embedsdurante a decodificação.
O Kandinsky 3 possui uma arquitetura mais concisa e não requer um modelo prévio. Isso significa que seu uso é idêntico ao de outros modelos de difusão, como o Stable Diffusion XL.
Texto para imagem
Para usar os modelos Kandinsky em qualquer tarefa, você sempre começa configurando o pipeline prior para codificar o prompt e gerar os embeddings da imagem. O pipeline prior também gera negative_image_embeds que correspondem ao prompt negativo "". Para obter melhores resultados, você pode passar um negative_prompt real para o pipeline prior, mas isso aumentará o tamanho efetivo do lote do pipeline prior em 2x.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
Agora, passe todos os prompts e embeddings para o KandinskyPipeline para gerar uma imagem:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
Passe image_embeds e negative_image_embeds para o KandinskyV22Pipeline para gerar uma imagem:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
O Kandinsky 3 não requer um modelo anterior, então você pode carregar diretamente o Kandinsky3Pipeline e passar um prompt para gerar uma imagem:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 O Diffusers também fornece uma API de ponta a ponta com o KandinskyCombinedPipeline e o KandinskyV22CombinedPipeline, o que significa que você não precisa carregar separadamente o pipeline de prior e o pipeline de texto para imagem. O pipeline combinado carrega automaticamente tanto o modelo de prior quanto o decodificador. Você ainda pode definir valores diferentes para o pipeline de prior com os parâmetros prior_guidance_scale e prior_num_inference_steps, se desejar.
Use o AutoPipelineForText2Image para chamar automaticamente os pipelines combinados por baixo dos panos:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageImagem para imagem
Para image-to-image, passe a imagem inicial e o prompt de texto para condicionar a imagem ao pipeline. Comece carregando o pipeline anterior:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")O Kandinsky 3 não requer um modelo anterior, então você pode carregar diretamente o pipeline de imagem para imagem:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
Baixe uma imagem para usar como condição:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))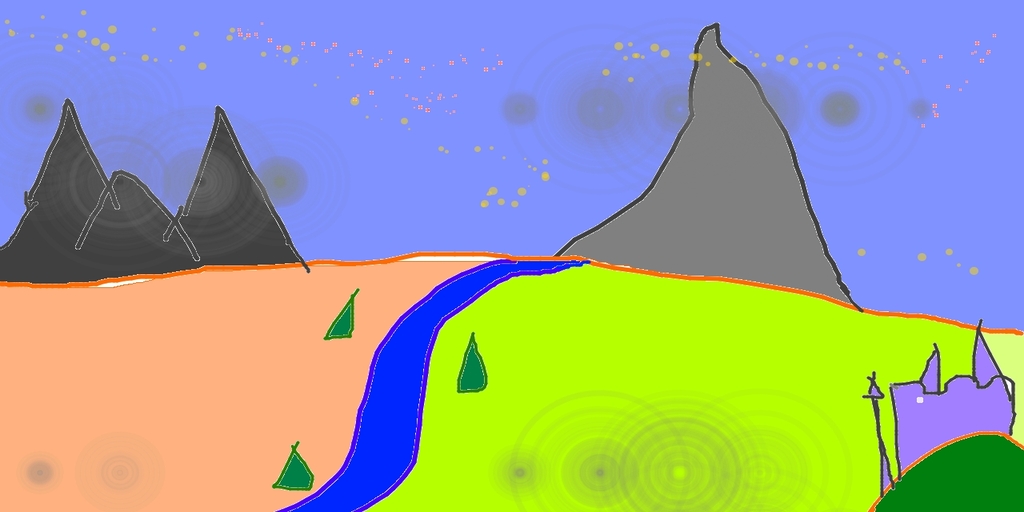
Gere os image_embeds e negative_image_embeds com o pipeline anterior:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
Agora, passe a imagem original, bem como todos os prompts e embeddings, para o pipeline para gerar uma imagem:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 O Diffusers também fornece uma API de ponta a ponta com o KandinskyImg2ImgCombinedPipeline e o KandinskyV22Img2ImgCombinedPipeline, o que significa que você não precisa carregar separadamente o prior e o pipeline de imagem para imagem. O pipeline combinado carrega automaticamente tanto o modelo prior quanto o decodificador. Você ainda pode definir valores diferentes para o pipeline prior com os parâmetros prior_guidance_scale e prior_num_inference_steps, se desejar.
Use o AutoPipelineForImage2Image para chamar automaticamente os pipelines combinados por baixo dos panos:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)Inpainting
⚠️ Os modelos Kandinsky agora usam ⬜️ pixels brancos para representar a área mascarada, em vez de pixels pretos. Se você estiver usando KandinskyInpaintPipeline em produção, precisa alterar a máscara para usar pixels brancos:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
Para inpainting, você precisará da imagem original, de uma máscara da área a ser substituída na imagem original e de um prompt de texto do que deve ser feito o inpainting. Carregue o pipeline anterior:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")Carregue uma imagem inicial e crie uma máscara:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
Gere os embeddings com o pipeline anterior:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
Agora, passe a imagem inicial, a máscara, o prompt e os embeddings para o pipeline para gerar uma imagem:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
Você também pode usar os pipelines KandinskyInpaintCombinedPipeline e KandinskyV22InpaintCombinedPipeline de ponta a ponta para chamar os pipelines de prior e decodificador juntos por baixo dos panos. Use o AutoPipelineForInpainting para isso:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)Interpolação
A interpolação permite explorar o espaço latente entre os embeddings de imagem e de texto, o que é uma maneira interessante de visualizar algumas das saídas intermediárias do modelo anterior. Carregue o pipeline anterior e duas imagens que você deseja interpolar:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

Especifique os textos ou imagens a serem interpolados e defina os pesos para cada texto ou imagem. Experimente com os pesos para ver como eles afetam a interpolação!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
Chame a função interpolate para gerar os embeddings e, em seguida, passe-os para o pipeline para gerar a imagem:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ O ControlNet é suportado apenas para o Kandinsky 2.2!
ControlNet permite condicionar grandes modelos de difusão pré-treinados com entradas adicionais, como um mapa de profundidade ou detecção de bordas. Por exemplo, você pode condicionar o Kandinsky 2.2 com um mapa de profundidade para que o modelo entenda e preserve a estrutura da imagem de profundidade.
Vamos carregar uma imagem e extrair seu mapa de profundidade:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
Em seguida, você pode usar o Pipeline depth-estimation do 🤗 Transformers para processar a imagem e recuperar o mapa de profundidade:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Texto para imagem
Carregue o pipeline anterior e o KandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Gere os embeddings de imagem a partir de um prompt e de um prompt negativo:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
Por fim, passe os embeddings da imagem e a imagem de profundidade para o KandinskyV22ControlnetPipeline para gerar uma imagem:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
Imagem para imagem
Para image-to-image com ControlNet, você precisará usar o:
- KandinskyV22PriorEmb2EmbPipeline para gerar os embeddings de imagem a partir de um prompt de texto e uma imagem
- KandinskyV22ControlnetImg2ImgPipeline para gerar uma imagem a partir da imagem inicial e dos embeddings da imagem
Processe e extraia um mapa de profundidade de uma imagem inicial de um gato com o Pipeline depth-estimation do 🤗 Transformers:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Carregue o pipeline anterior e o KandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Passe um prompt de texto e a imagem inicial para o pipeline prior para gerar os embeddings da imagem:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
Agora você pode executar o KandinskyV22ControlnetImg2ImgPipeline para gerar uma imagem a partir da imagem inicial e dos embeddings da imagem:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
Otimizações
Kandinsky é único porque exige um pipeline anterior para gerar os mapeamentos e um segundo pipeline para decodificar os latentes em uma imagem. Os esforços de otimização devem ser focados no segundo pipeline, pois é onde a maior parte do cálculo é realizada. Aqui estão algumas dicas para melhorar o Kandinsky durante a inferência.
- Ative o xFormers se você estiver usando PyTorch < 2.0:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- Ative
torch.compilese você estiver usando PyTorch >= 2.0 para usar automaticamente a scaled dot-product attention (SDPA):
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
Isso é o mesmo que definir explicitamente o processador de atenção para usar AttnAddedKVProcessor2_0:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- Desloque o modelo para a CPU com enable_model_cpu_offload() para evitar erros de memória insuficiente:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- Por padrão, o pipeline de texto para imagem usa o DDIMScheduler, mas você pode substituí-lo por outro agendador, como o DDPMScheduler, para ver como isso afeta o equilíbrio entre a velocidade de inferência e a qualidade da imagem:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
classe diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
Parâmetros
- prior (PriorTransformer) — O prior unCLIP canônico para aproximar o embedding da imagem a partir do embedding do texto.
- image_encoder (
CLIPVisionModelWithProjection) — Codificador de imagem congelado. - text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - scheduler (
UnCLIPScheduler) — Um scheduler a ser usado em combinação compriorpara gerar o embedding da imagem.
Pipeline para gerar prior de imagem para Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - num_inference_steps (
int, opcional, padrão 25) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - output_type (
str, opcional, padrão"pt") — O formato de saída da imagem gerada. Escolha entre:"np"(np.array) ou"pt"(torch.Tensor). - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
KandinskyPriorPipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
Parâmetros
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — lista de prompts e imagens para orientar a geração de imagens. - weights — (
list[float]): lista de pesos para cada condição emimages_and_prompts - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - num_inference_steps (
int, opcional, padrão 25) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - negative_prior_prompt (
str, opcional) — O prompt que não deve orientar o processo de difusão prévio. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - negative_prompt (
stroulist[str], opcional) — O prompt que não deve orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem.
Retorna
KandinskyPriorPipelineOutput ou tuple
Função invocada ao usar o pipeline anterior para interpolação.
Exemplos:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
classe diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (
DDIMScheduler|DDPMScheduler) — Um scheduler a ser usado em combinação comunetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Decoder MoVQ para gerar a imagem a partir dos latentes.
Pipeline para geração de texto para imagem usando Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto, que serão usados para condicionar a geração da imagem. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto negativo, que serão usados para condicionar a geração da imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
classe diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (
DDIMScheduler|DDPMScheduler) — Um scheduler a ser usado em combinação comunetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Decoder MoVQ para gerar a imagem a partir dos latentes.
- prior_prior (PriorTransformer) — O prior unCLIP canônico para aproximar o embedding da imagem a partir do embedding do texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imagem congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Um scheduler a ser usado em combinação compriorpara gerar o embedding da imagem.
Pipeline combinado para geração de texto para imagem usando Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - prior_guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2. do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - prior_num_inference_steps (
int, opcional, padrão 100) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente levam a uma imagem de maior qualidade, em detrimento de uma inferência mais lenta. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Desloca todos os modelos (os dicionários de estado de unet, text_encoder, vae e safety checker) para a CPU usando 🤗
Accelerate, reduzindo significativamente o uso de memória. Os modelos são movidos para um torch.device('meta') e carregados em uma
GPU apenas quando o método forward do submódulo específico é chamado. O deslocamento ocorre com base em submódulos.
As economias de memória são maiores do que ao usar enable_model_cpu_offload, mas o desempenho é menor.
KandinskyImg2ImgPipeline
classe diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (DDIMScheduler) —
Um scheduler a ser usado em combinação com
unetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Codificador e decodificador de imagem MoVQ
Pipeline para geração de imagem a imagem usando Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - image (
torch.Tensor,PIL.Image.Image) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto, que serão usados para condicionar a geração da imagem. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto negativo, que serão usados para condicionar a geração da imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - strength (
float, opcional, padrão 0.3) — Conceitualmente, indica o quanto transformar aimagede referência. Deve estar entre 0 e 1. Aimageserá usada como ponto de partida, adicionando mais ruído à medida que ostrengthaumenta. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado será máximo e o processo de desruidamento será executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1, portanto, essencialmente ignora aimage. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
classe diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (
DDIMScheduler|DDPMScheduler) — Um scheduler a ser usado em combinação comunetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Decoder MoVQ para gerar a imagem a partir dos latentes.
- prior_prior (PriorTransformer) — O prior unCLIP canônico para aproximar o embedding da imagem a partir do embedding do texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imagem congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Um scheduler a ser usado em combinação compriorpara gerar o embedding da imagem.
Pipeline combinado para geração de imagem a imagem usando Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Imageou tensor representando um lote de imagens, que será usado como ponto de partida para o processo. Também pode aceitar latentes de imagem comoimage; se latentes forem passados diretamente, eles não serão codificados novamente. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - strength (
float, opcional, padrão 0.3) — Conceitualmente, indica o quanto transformar aimagede referência. Deve estar entre 0 e 1. Aimageserá usada como ponto de partida, adicionando mais ruído à medida que ostrengthaumenta. O número de etapas de desruidamento depende da quantidade de ruído inicialmente adicionada. Quandostrengthé 1, o ruído adicionado será máximo e o processo de desruidamento será executado pelo número total de iterações especificado emnum_inference_steps. Um valor de 1, portanto, essencialmente ignora aimage. - prior_guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2. do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - prior_num_inference_steps (
int, opcional, padrão 100) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente levam a uma imagem de maior qualidade, em detrimento de uma inferência mais lenta. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Desloca todos os modelos para a CPU usando accelerate, reduzindo significativamente o uso de memória. Quando chamado, unet,
text_encoder, vae e safety checker têm seus state dicts salvos na CPU e, em seguida, são movidos para um torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
classe diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (DDIMScheduler) —
Um scheduler a ser usado em combinação com
unetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Codificador e decodificador de imagem MoVQ
Pipeline para inpainting de imagem guiado por texto usando Kandinsky2.1
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - image (
torch.Tensor,PIL.Image.Imageornp.ndarray) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - mask_image (
PIL.Image.Image,torch.Tensorornp.ndarray) —Image, or a tensor representing an image batch, to maskimage. White pixels in the mask will be repainted, while black pixels will be preserved. You can pass a pytorch tensor as mask only if the image you passed is a pytorch tensor, and it should contain one color channel (L) instead of 3, so the expected shape would be either(B, 1, H, W,),(B, H, W),(1, H, W)or(H, W)If image is an PIL image or numpy array, mask should also be a either PIL image or numpy array. If it is a PIL image, it will be converted to a single channel (luminance) before use. If it is a nummpy array, the expected shape is(H, W). - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto, que serão usados para condicionar a geração da imagem. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Os embeddings de imagem do clip para o prompt de texto negativo, que serão usados para condicionar a geração da imagem. - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
classe diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Parâmetros
- text_encoder (
MultilingualCLIP) — Codificador de texto congelado. - tokenizer (
XLMRobertaTokenizer) — Tokenizer da classe - scheduler (
DDIMScheduler|DDPMScheduler) — Um scheduler a ser usado em combinação comunetpara gerar latentes de imagem. - unet (UNet2DConditionModel) — Arquitetura U-Net condicional para desruidar o embedding da imagem.
- movq (VQModel) — Decoder MoVQ para gerar a imagem a partir dos latentes.
- prior_prior (PriorTransformer) — O prior unCLIP canônico para aproximar o embedding da imagem a partir do embedding do texto.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Codificador de imagem congelado. - prior_text_encoder (
CLIPTextModelWithProjection) — Codificador de texto congelado. - prior_tokenizer (
CLIPTokenizer) — Tokenizer da classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Um scheduler a ser usado em combinação compriorpara gerar o embedding da imagem.
Pipeline combinado para geração usando Kandinsky
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Parâmetros
- prompt (
stroulist[str]) — O prompt ou os prompts para orientar a geração da imagem. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Imageou tensor representando um lote de imagens, que será usado como ponto de partida para o processo. Também pode aceitar latentes de imagem comoimage; se latentes forem passados diretamente, eles não serão codificados novamente. - mask_image (
np.array) — Tensor representando um lote de imagens, para mascararimage. Os pixels brancos na máscara serão repintados, enquanto os pixels pretos serão preservados. Semask_imagefor uma imagem PIL, ela será convertida para um único canal (luminância) antes do uso. Se for um tensor, ele deve conter um canal de cor (L) em vez de 3, de modo que a forma esperada seria(B, H, W, 1). - negative_prompt (
stroulist[str], opcional) — O prompt ou os prompts que não devem orientar a geração da imagem. Ignorado quando não se usa orientação (ou seja, ignorado seguidance_scalefor menor que1). - num_images_per_prompt (
int, opcional, padrão 1) — O número de imagens a serem geradas por prompt. - num_inference_steps (
int, opcional, padrão 100) — O número de etapas de remoção de ruído. Mais etapas de remoção de ruído geralmente resultam em uma imagem de maior qualidade, à custa de uma inferência mais lenta. - height (
int, opcional, padrão 512) — A altura em pixels da imagem gerada. - width (
int, opcional, padrão 512) — A largura em pixels da imagem gerada. - prior_guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2. do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - prior_num_inference_steps (
int, opcional, padrão 100) — O número de etapas de desruidamento. Mais etapas de desruidamento geralmente levam a uma imagem de maior qualidade, em detrimento de uma inferência mais lenta. - guidance_scale (
float, opcional, padrão 4.0) — Escala de orientação definida em Classifier-Free Diffusion Guidance.guidance_scaleé definido comowda equação 2 do Imagen Paper. A escala de orientação é ativada ao definirguidance_scale > 1. Uma escala de orientação maior incentiva a geração de imagens que estão intimamente ligadas aopromptde texto, geralmente em detrimento de uma menor qualidade de imagem. - generator (
torch.Generatoroulist[torch.Generator], opcional) — Um ou uma lista de geradores do torch para tornar a geração determinística. - latents (
torch.Tensor, opcional) — Latentes ruidosos pré-gerados, amostrados de uma distribuição gaussiana, a serem usados como entradas para a geração de imagens. Pode ser usado para ajustar a mesma geração com diferentes prompts. Se não for fornecido, um tensor de latentes será gerado por amostragem usando ogeneratoraleatório fornecido. - output_type (
str, opcional, padrão"pil") — O formato de saída da imagem gerada. Escolha entre:"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, opcional) — Uma função que é chamada a cadacallback_stepspassos durante a inferência. A função é chamada com os seguintes argumentos:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, opcional, padrão 1) — A frequência com que a funçãocallbacké chamada. Se não for especificada, o callback é chamado a cada etapa. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um ImagePipelineOutput em vez de uma tupla simples.
Retorna
ImagePipelineOutput ou tuple
Função invocada ao chamar o pipeline para geração.
Exemplos:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Desloca todos os modelos para a CPU usando accelerate, reduzindo significativamente o uso de memória. Quando chamado, unet,
text_encoder, vae e safety checker têm seus state dicts salvos na CPU e, em seguida, são movidos para um torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.