
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
تم إنشاء Kandinsky 2.1 بواسطة Arseniy Shakhmatov وAnton Razzhigaev وAleksandr Nikolich وVladimir Arkhipkin وIgor Pavlov وAndrey Kuznetsov وDenis Dimitrov.
الوصف من صفحتها على GitHub هو:
يرث Kandinsky 2.1 أفضل الممارسات من Dall-E 2 وLatent diffusion، مع تقديم بعض الأفكار الجديدة. يستخدم نموذج CLIP كمشفّر للنص والصورة، بالإضافة إلى نموذج مسبق (mapping) للصور التوليدية بين الفضاءات الكامنة لأنماط CLIP. يزيد هذا النهج من الأداء البصري للنموذج ويفتح آفاقًا جديدة في دمج الصور والتلاعب بالصور الموجّهة بالنص.
يمكن العثور على قاعدة الكود الأصلية في ai-forever/Kandinsky-2.
اطّلع على منظمة Kandinsky Community على Hub للحصول على نقاط التفتيش الرسمية للنماذج لمهام مثل النص إلى صورة، والصورة إلى صورة، والتعبئة (inpainting).
تأكد من الاطلاع على دليل المجدولين لمعرفة كيفية استكشاف التوازن بين سرعة المجدول وجودة النتائج، واطّلع على قسم إعادة استخدام المكونات عبر خطوط الأنابيب لمعرفة كيفية تحميل نفس المكونات بكفاءة في خطوط أنابيب متعددة.
تأكد من تثبيت المكتبات التالية.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
استخدام Kandinsky 2.1 و 2.2 متشابه جدًا! الفرق الوحيد هو أن Kandinsky 2.2 لا يقبل
promptكمدخل عند فك ترميز الكمونيات. وبدلًا من ذلك، يقبل Kandinsky 2.2 فقطimage_embedsأثناء فك الترميز.
يتميز Kandinsky 3 بهيكل معماري أكثر إيجازاً ولا يتطلب نموذجاً مسبقاً. وهذا يعني أن استخدامه مطابق لاستخدام نماذج الانتشار الأخرى مثل Stable Diffusion XL.
النص إلى صورة
لاستخدام نماذج Kandinsky في أي مهمة، تبدأ دائمًا بإعداد خط أنابيب المسبق (prior pipeline) لتشفير الأمر النصي وتوليد تضمينات الصورة. كما يولّد خط الأنابيب المسبق negative_image_embeds التي تتوافق مع الأمر النصي السلبي "". للحصول على نتائج أفضل، يمكنك تمرير negative_prompt فعلي إلى خط الأنابيب المسبق، لكن ذلك سيضاعف حجم الدفعة الفعّالة لخط الأنابيب المسبق مرتين.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
الآن مرّر جميع الأوامر النصية والتضمينات إلى KandinskyPipeline لتوليد صورة:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
مرّر image_embeds وnegative_image_embeds إلى KandinskyV22Pipeline لتوليد صورة:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
لا يتطلب Kandinsky 3 نموذجًا مسبقًا، لذا يمكنك تحميل Kandinsky3Pipeline مباشرةً وتزويده بطلب (prompt) لتوليد صورة:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 كما يوفر Diffusers واجهة برمجة تطبيقات شاملة من البداية إلى النهاية مع KandinskyCombinedPipeline و KandinskyV22CombinedPipeline، مما يعني أنك لا تحتاج إلى تحميل خط أنابيب النموذج المسبق وخط أنابيب النص إلى الصورة بشكل منفصل. يقوم خط الأنابيب المدمج تلقائيًا بتحميل كل من النموذج المسبق ومفك الترميز. يمكنك دائمًا تعيين قيم مختلفة لخط أنابيب النموذج المسبق باستخدام المعاملين prior_guidance_scale و prior_num_inference_steps إذا رغبت في ذلك.
استخدم AutoPipelineForText2Image لاستدعاء خطوط الأنابيب المدمجة تلقائيًا في الخلفية:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageمن صورة إلى صورة
لتحويل الصورة إلى صورة، مرّر الصورة الأولية وموجّه النص لتكييف الصورة إلى خط الأنابيب. ابدأ بتحميل خط الأنابيب السابق:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")لا يتطلب Kandinsky 3 نموذجًا مسبقًا، لذا يمكنك تحميل خط أنابيب الصورة إلى الصورة مباشرةً:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
تحميل صورة للاستناد إليها:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))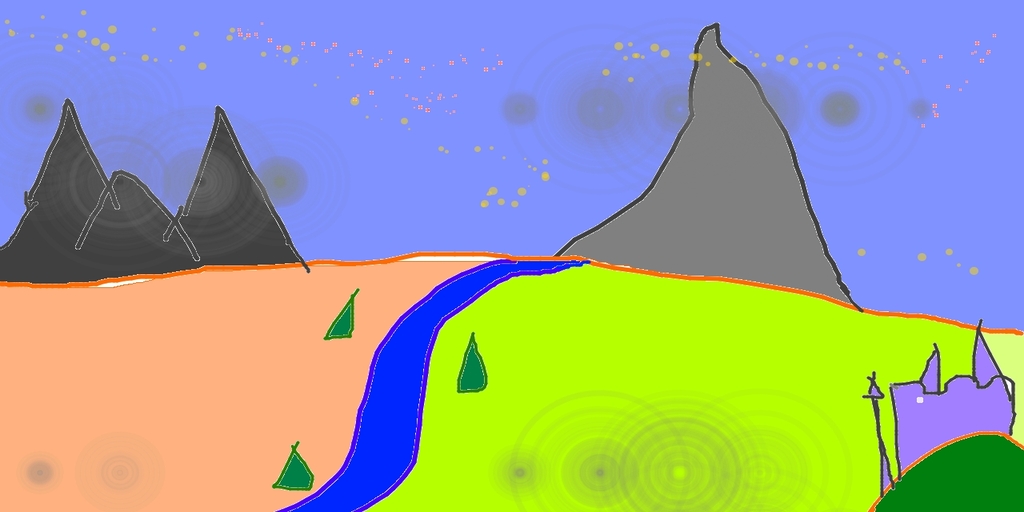
أنشئ image_embeds وnegative_image_embeds باستخدام خط الأنابيب السابق:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
الآن مرّر الصورة الأصلية، وجميع الأوامر النصية والتضمينات إلى خط الأنابيب لتوليد صورة:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 كما يوفر Diffusers واجهة برمجة تطبيقات شاملة من البداية إلى النهاية عبر KandinskyImg2ImgCombinedPipeline و KandinskyV22Img2ImgCombinedPipeline، مما يعني أنك لا تحتاج إلى تحميل خط أنابيب المسبق وخط أنابيب الصورة إلى الصورة بشكل منفصل. يقوم خط الأنابيب المدمج تلقائيًا بتحميل كل من النموذج المسبق ومفك الترميز. يمكنك دائمًا تعيين قيم مختلفة لخط أنابيب المسبق باستخدام المعاملين prior_guidance_scale و prior_num_inference_steps إذا رغبت في ذلك.
استخدم AutoPipelineForImage2Image لاستدعاء خطوط الأنابيب المدمجة تلقائيًا في الخلفية:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)الترميم
⚠️ تستخدم نماذج Kandinsky الآن بكسلات بيضاء ⬜️ لتمثيل المنطقة المقنّعة بدلاً من البكسلات السوداء. إذا كنت تستخدم KandinskyInpaintPipeline في بيئة الإنتاج، فيجب عليك تغيير القناع لاستخدام البكسلات البيضاء:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
لتطبيق تقنية إعادة الرسم (Inpainting)، ستحتاج إلى الصورة الأصلية، وقناع (Mask) للمنطقة التي تريد استبدالها في الصورة الأصلية، وموجّه نصي يصف ما تريد إعادة رسمه. حمّل خط الأنابيب السابق:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")تحميل صورة أولية وإنشاء قناع:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
أنشئ التضمينات باستخدام خط الأنابيب السابق:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
الآن مرّر الصورة الأولية، والقناع، والموجّه، والتضمينات إلى خطّ الأنابيب لتوليد صورة:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
يمكنك أيضًا استخدام خطي الأنابيب الشاملين من الطرف إلى الطرف KandinskyInpaintCombinedPipeline و KandinskyV22InpaintCombinedPipeline لاستدعاء خطي أنابيب المسبق والمفكك معًا في الخلفية. استخدم AutoPipelineForInpainting لهذا الغرض:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)الاستيفاء
تتيح لك الاستيفاء استكشاف الفضاء الكامن بين تضمينات الصور والنصوص، وهو أسلوب ممتع لرؤية بعض المخرجات الوسيطة لنموذج المسبق. حمّل خط أنابيب المسبق والصورتين اللتين ترغب في استيفاء بينهما:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

حدد النص أو الصور التي تريد استيفاءها، وقم بتعيين الأوزان لكل نص أو صورة. جرّب الأوزان المختلفة لترى كيف تؤثر على عملية الاستيفاء!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
استدعِ دالة interpolate لتوليد التضمينات، ثم مررها إلى خط الأنابيب لتوليد الصورة:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ يُدعم ControlNet فقط لنموذج Kandinsky 2.2!
يتيح ControlNet ضبط نماذج الانتشار الكبيرة المُدرَّبة مسبقًا باستخدام مدخلات إضافية مثل خريطة العمق أو كشف الحواف. على سبيل المثال، يمكنك ضبط Kandinsky 2.2 بخريطة عمق بحيث يفهم النموذج بنية صورة العمق ويحافظ عليها.
دعونا نحمّل صورة ونستخرج خريطة عمقها:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
ثم يمكنك استخدام خط أنابيب Pipeline الخاص بـ depth-estimation من 🤗 Transformers لمعالجة الصورة واستخراج خريطة العمق:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
النص إلى صورة
حمّل خط الأنابيب السابق وKandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
أنشئ تمثيلات الصور من موجه وموجه سالب:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
أخيرًا، مرّر تضمينات الصورة والصورة العمقية إلى KandinskyV22ControlnetPipeline لتوليد صورة:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
من صورة إلى صورة
بالنسبة إلى تحويل الصورة إلى صورة باستخدام ControlNet، ستحتاج إلى استخدام:
- KandinskyV22PriorEmb2EmbPipeline لتوليد تمثيلات الصور من وصف نصي وصورة
- KandinskyV22ControlnetImg2ImgPipeline لتوليد صورة من الصورة الأولية وتضمينات الصورة
معالجة واستخراج خريطة عمق لصورة أولية لقط باستخدام خط أنابيب Pipeline الخاص بـ depth-estimation من 🤗 Transformers:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
حمّل خط الأنابيب السابق وKandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
مرّر موجه نصي والصورة الأولية إلى خط أنابيب المسبق لتوليد تضمينات الصورة:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
الآن يمكنك تشغيل KandinskyV22ControlnetImg2ImgPipeline لتوليد صورة من الصورة الأولية وتضمينات الصورة:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
التحسينات
يتميّز Kandinsky بأنه يتطلب خط أنابيب مسبقًا لتوليد الخرائط، وخط أنابيب ثانٍ لفك ترميز الكمونيات إلى صورة. ينبغي توجيه جهود التحسين نحو خط الأنابيب الثاني، لأن الجزء الأكبر من الحسابات يتم فيه. فيما يلي بعض النصائح لتحسين Kandinsky أثناء الاستدلال.
- فعّل xFormers إذا كنت تستخدم PyTorch < 2.0:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- فعّل
torch.compileإذا كنت تستخدم PyTorch >= 2.0 لاستخدام الانتباه بنقطة الضرب المُقيّمة (SDPA) تلقائيًا:
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
هذا هو نفسه تعيين معالج الانتباه بشكل صريح لاستخدام AttnAddedKVProcessor2_0:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- قم بإسناد النموذج إلى وحدة المعالجة المركزية باستخدام enable_model_cpu_offload() لتجنب أخطاء نفاد الذاكرة:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- يستخدم خط أنابيب النص إلى الصورة DDIMScheduler افتراضياً، لكن يمكنك استبداله بمجدول آخر مثل DDPMScheduler لرؤية كيف يؤثر ذلك على التوازن بين سرعة الاستدلال وجودة الصورة:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
فئة diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
المعاملات
- prior (PriorTransformer) — النموذج السابق القياسي في unCLIP لتقريب تضمين الصورة من تضمين النص.
- image_encoder (
CLIPVisionModelWithProjection) — مُشفِّر صور مجمّد. - text_encoder (
CLIPTextModelWithProjection) — مُشفِّر نص ثابت. - tokenizer (
CLIPTokenizer) — مقسّم من الفئة CLIPTokenizer. - scheduler (
UnCLIPScheduler) — جدولة تُستخدم بالاقتران معpriorلتوليد تضمين الصورة.
خط أنابيب لتوليد المسبق (prior) للصور في Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - num_inference_steps (
int، اختياري، القيمة الافتراضية 25) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - output_type (
str، اختياري، القيمة الافتراضية"pt") — صيغة مخرجات توليد الصورة. اختر بين:"np"(np.array) أو"pt"(torch.Tensor). - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
KandinskyPriorPipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
المعاملات
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — قائمة من الأوامر النصية والصور لتوجيه توليد الصور. - weights — (
list[float]): قائمة بالأوزان الخاصة بكل شرط فيimages_and_prompts - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - num_inference_steps (
int، اختياري، القيمة الافتراضية 25) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - negative_prior_prompt (
str, اختياري) — الموجّه الذي لا يوجّه عملية الانتشار المسبقة. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كانguidance_scaleأقل من1). - negative_prompt (
strأوlist[str]، اختياري) — الموجّه الذي لا يُستخدم لتوجيه توليد الصورة. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كانguidance_scaleأقل من1). - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة.
يعيد
KandinskyPriorPipelineOutput أو tuple
الدالة التي يتم استدعاؤها عند استخدام خط الأنابيب السابق للاستيفاء.
أمثلة:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
فئة diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (
DDIMScheduler|DDPMScheduler) — جدولة تُستخدم بالاقتران معunetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مفكّك MoVQ لتوليد الصورة من الكمّات الكامنة.
خط أنابيب لتوليد الصور من النص باستخدام Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات الصور المقطعية (clip image embeddings) الخاصة بطلب النص، والتي ستُستخدم لتكييف توليد الصورة. - negative_image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات صور clip الخاصة بالموجّه النصي السلبي، وسيتم استخدامها لتوجيه توليد الصورة. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
فئة diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (
DDIMScheduler|DDPMScheduler) — جدولة تُستخدم بالاقتران معunetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مفكّك MoVQ لتوليد الصورة من الكمّات الكامنة.
- prior_prior (PriorTransformer) — النموذج المسبق القياسي لـ unCLIP لتقريب تضمين الصورة من تضمين النص.
- prior_image_encoder (
CLIPVisionModelWithProjection) — مُشفِّر صور مجمّد. - prior_text_encoder (
CLIPTextModelWithProjection) — مُشفِّر نص ثابت. - prior_tokenizer (
CLIPTokenizer) — مقسّم من فئة CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — جدول زمني يُستخدم بالاقتران معpriorلتوليد تضمين الصورة.
خط أنابيب مجمّع لتوليد الصور من النص باستخدام Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - prior_guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2. في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بنصprompt، وعادةً على حساب انخفاض جودة الصورة. - prior_num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة ذات جودة أعلى على حساب بطء الاستدلال. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
ينقل جميع النماذج (قواميس الحالة الخاصة بـ unet وtext_encoder وvae وsafety checker) إلى وحدة المعالجة المركزية (CPU) باستخدام 🤗
Accelerate، مما يقلل من استهلاك الذاكرة بشكل كبير. يتم نقل النماذج إلى torch.device('meta') وتحميلها على وحدة معالجة رسومات (GPU) فقط عند استدعاء طريقة forward الخاصة بالوحدة الفرعية المعنية. يتم تنفيذ النقل على أساس الوحدات الفرعية. تكون وفورات الذاكرة أعلى مما هي عليه عند استخدام enable_model_cpu_offload، لكن الأداء يكون أدنى.
KandinskyImg2ImgPipeline
فئة diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (DDIMScheduler) —
جدولة تُستخدم بالاقتران مع
unetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مُشفِّر ومُفكِّك صور MoVQ
خط أنابيب لتوليد الصور من صورة باستخدام Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - image (
torch.Tensor,PIL.Image.Image) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات الصور المقطعية (clip image embeddings) الخاصة بطلب النص، والتي ستُستخدم لتكييف توليد الصورة. - negative_image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات صور clip الخاصة بالموجّه النصي السلبي، وسيتم استخدامها لتوجيه توليد الصورة. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - strength (
float, اختياري، القيمة الافتراضية 0.3) — مفاهيمياً، يحدد مقدار تحويل الصورة المرجعيةimage. يجب أن يكون بين 0 و 1. ستُستخدمimageكنقطة انطلاق، مع إضافة المزيد من الضوضاء إليها كلما زادstrength. يعتمد عدد خطوات إزالة الضوضاء على كمية الضوضاء المضافة في البداية. عندما تكونstrengthتساوي 1، ستكون الضوضاء المضافة في أقصى حد، وستعمل عملية إزالة الضوضاء لعدد التكرارات الكامل المحدد فيnum_inference_steps. وبالتالي، فإن القيمة 1 تتجاهلimageبشكل أساسي. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
فئة diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (
DDIMScheduler|DDPMScheduler) — جدولة تُستخدم بالاقتران معunetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مفكّك MoVQ لتوليد الصورة من الكمّات الكامنة.
- prior_prior (PriorTransformer) — النموذج المسبق القياسي لـ unCLIP لتقريب تضمين الصورة من تضمين النص.
- prior_image_encoder (
CLIPVisionModelWithProjection) — مُشفِّر صور مجمّد. - prior_text_encoder (
CLIPTextModelWithProjection) — مُشفِّر نص ثابت. - prior_tokenizer (
CLIPTokenizer) — مقسّم من فئة CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — جدول زمني يُستخدم بالاقتران معpriorلتوليد تضمين الصورة.
خط أنابيب مجمّع لتوليد صورة من صورة باستخدام Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - image (
torch.Tensor،PIL.Image.Image،np.ndarray،list[torch.Tensor]،list[PIL.Image.Image]، أوlist[np.ndarray]) —Image، أو متجه (tensor) يمثل دفعة من الصور، يُستخدم كنقطة انطلاق للعملية. يمكن أيضًا قبول كامنات الصور (image latents) كـimage، فإذا تم تمرير الكامنات مباشرةً، فلن يتم ترميزها مرة أخرى. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - strength (
float, اختياري، القيمة الافتراضية 0.3) — مفاهيمياً، يحدد مقدار تحويل الصورة المرجعيةimage. يجب أن يكون بين 0 و 1. ستُستخدمimageكنقطة انطلاق، مع إضافة المزيد من الضوضاء إليها كلما زادstrength. يعتمد عدد خطوات إزالة الضوضاء على كمية الضوضاء المضافة في البداية. عندما تكونstrengthتساوي 1، ستكون الضوضاء المضافة في أقصى حد، وستعمل عملية إزالة الضوضاء لعدد التكرارات الكامل المحدد فيnum_inference_steps. وبالتالي، فإن القيمة 1 تتجاهلimageبشكل أساسي. - prior_guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2. في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بنصprompt، وعادةً على حساب انخفاض جودة الصورة. - prior_num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة ذات جودة أعلى على حساب بطء الاستدلال. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
فئة diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (DDIMScheduler) —
جدولة تُستخدم بالاقتران مع
unetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مُشفِّر ومُفكِّك صور MoVQ
خط أنابيب لتعبئة الصور الموجهة بالنص باستخدام Kandinsky2.1
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - image (
torch.Tensor,PIL.Image.Imageornp.ndarray) —Image, or tensor representing an image batch, that will be used as the starting point for the process. - mask_image (
PIL.Image.Image,torch.Tensorornp.ndarray) —Image, or a tensor representing an image batch, to maskimage. White pixels in the mask will be repainted, while black pixels will be preserved. You can pass a pytorch tensor as mask only if the image you passed is a pytorch tensor, and it should contain one color channel (L) instead of 3, so the expected shape would be either(B, 1, H, W,),(B, H, W),(1, H, W)or(H, W)If image is an PIL image or numpy array, mask should also be a either PIL image or numpy array. If it is a PIL image, it will be converted to a single channel (luminance) before use. If it is a nummpy array, the expected shape is(H, W). - image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات الصور المقطعية (clip image embeddings) الخاصة بطلب النص، والتي ستُستخدم لتكييف توليد الصورة. - negative_image_embeds (
torch.Tensorأوlist[torch.Tensor]) — تضمينات صور clip الخاصة بالموجّه النصي السلبي، وسيتم استخدامها لتوجيه توليد الصورة. - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
فئة diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
المعاملات
- text_encoder (
MultilingualCLIP) — مُشفِّر نصوص مجمّد. - tokenizer (
XLMRobertaTokenizer) — مُقسِّم من الفئة - scheduler (
DDIMScheduler|DDPMScheduler) — جدولة تُستخدم بالاقتران معunetلتوليد كامنات الصور. - unet (UNet2DConditionModel) — بنية U-Net الشرطية لإزالة الضوضاء من تضمين الصورة.
- movq (VQModel) — مفكّك MoVQ لتوليد الصورة من الكمّات الكامنة.
- prior_prior (PriorTransformer) — النموذج المسبق القياسي لـ unCLIP لتقريب تضمين الصورة من تضمين النص.
- prior_image_encoder (
CLIPVisionModelWithProjection) — مُشفِّر صور مجمّد. - prior_text_encoder (
CLIPTextModelWithProjection) — مُشفِّر نص ثابت. - prior_tokenizer (
CLIPTokenizer) — مقسّم من فئة CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — جدول زمني يُستخدم بالاقتران معpriorلتوليد تضمين الصورة.
خط أنابيب مجمّع للتوليد باستخدام Kandinsky
يرث هذا النموذج من DiffusionPipeline. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
المعاملات
- prompt (
strأوlist[str]) — الموجّه أو الموجّهات التي تُوجّه توليد الصورة. - image (
torch.Tensor،PIL.Image.Image،np.ndarray،list[torch.Tensor]،list[PIL.Image.Image]، أوlist[np.ndarray]) —Image، أو متجه (tensor) يمثل دفعة من الصور، يُستخدم كنقطة انطلاق للعملية. يمكن أيضًا قبول كامنات الصور (image latents) كـimage، فإذا تم تمرير الكامنات مباشرةً، فلن يتم ترميزها مرة أخرى. - mask_image (
np.array) — مصفوفة تمثل دفعة من الصور، لتطبيق قناع علىimage. سيتم إعادة رسم البكسلات البيضاء في القناع، بينما ستُحفظ البكسلات السوداء. إذا كانmask_imageصورة بصيغة PIL، فسيتم تحويلها إلى قناة واحدة (السطوع) قبل الاستخدام. أما إذا كانت مصفوفة، فيجب أن تحتوي على قناة لون واحدة (L) بدلاً من 3، لذا فإن الشكل المتوقع سيكون(B, H, W, 1). - negative_prompt (
strأوlist[str]، اختياري) — الموجّه أو الموجّهات التي لا ينبغي استخدامها لتوجيه توليد الصورة. يتم تجاهلها عند عدم استخدام التوجيه (أي يتم تجاهلها إذا كانguidance_scaleأقل من1). - num_images_per_prompt (
int، اختياري، القيمة الافتراضية 1) — عدد الصور التي سيتم توليدها لكل موجه. - num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة بجودة أعلى على حساب بطء الاستدلال. - height (
int، اختياري، القيمة الافتراضية 512) — ارتفاع الصورة المولّدة بالبكسل. - width (
int، اختياري، القيمة الافتراضية 512) — عرض الصورة المولّدة بالبكسل. - prior_guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2. في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بنصprompt، وعادةً على حساب انخفاض جودة الصورة. - prior_num_inference_steps (
int، اختياري، القيمة الافتراضية 100) — عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى صورة ذات جودة أعلى على حساب بطء الاستدلال. - guidance_scale (
float، اختياري، القيمة الافتراضية 4.0) — مقياس التوجيه كما هو مُعرَّف في Classifier-Free Diffusion Guidance. يُعرَّفguidance_scaleعلى أنهwمن المعادلة 2 في Imagen Paper. يتم تفعيل مقياس التوجيه عن طريق تعيينguidance_scale > 1. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بـpromptالنصي، وعادةً على حساب انخفاض جودة الصورة. - generator (
torch.Generatorأوlist[torch.Generator]، اختياري) — مولّد واحد أو قائمة من مولّدات torch لجعل التوليد حتميًا. - latents (
torch.Tensor، اختياري) — كائنات latents ضجيجية مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الصور. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كائن latents عن طريق الاستخراج باستخدامgeneratorالعشوائي المُقدَّم. - output_type (
str، اختياري، القيمة الافتراضية"pil") — صيغة مخرجات توليد الصورة. اختر بين:"pil"(PIL.Image.Image)،"np"(np.array) أو"pt"(torch.Tensor). - callback (
Callable، اختياري) — دالة تُستدعى كلcallback_stepsخطوات أثناء الاستدلال. تُستدعى الدالة مع الحجج التالية:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int، اختياري، القيمة الافتراضية 1) — التردد الذي تُستدعى به دالةcallback. إذا لم يُحدد، تُستدعى الدالة في كل خطوة. - return_dict (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إرجاع ImagePipelineOutput بدلاً من tuple عادي.
يعيد
ImagePipelineOutput أو tuple
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.