
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 由 Arseniy Shakhmatov、Anton Razzhigaev、Aleksandr Nikolich、Vladimir Arkhipkin、Igor Pavlov、Andrey Kuznetsov 和 Denis Dimitrov 创建。
其 GitHub 页面上的描述为:
Kandinsky 2.1 继承了 Dall-E 2 和 Latent diffusion 的最佳实践,同时引入了一些新想法。它使用 CLIP 模型作为文本和图像编码器,并在 CLIP 模态的潜在空间之间引入扩散图像先验(映射)。这种方法提升了模型的视觉表现,并在图像融合以及文本引导的图像操作方面开辟了新的可能性。
原始代码库可在 ai-forever/Kandinsky-2 中找到。
在 Hub 上查看 Kandinsky Community 组织,以获取文本生成图像、图像生成图像和图像修复等任务的官方模型检查点。
请务必参阅 调度器指南,了解如何探索调度器速度与质量之间的权衡,并查看 跨流水线复用组件 部分,了解如何高效地将相同组件加载到多个流水线中。
请确保已安装以下库。
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Kandinsky 2.1 和 2.2 的用法非常相似!唯一的区别在于,Kandinsky 2.2 在解码潜变量时不接受
prompt作为输入。相反,Kandinsky 2.2 在解码时仅接受image_embeds。
Kandinsky 3 的架构更为简洁,且无需依赖先验模型。这意味着其使用方式与其他扩散模型(如 Stable Diffusion XL)完全相同。
文本到图像
要将 Kandinsky 模型用于任何任务,您始终需要首先设置 prior pipeline,以编码提示词并生成图像嵌入。prior pipeline 还会生成与负向提示词 "" 对应的 negative_image_embeds。为了获得更好的效果,您可以向 prior pipeline 传入实际的 negative_prompt,但这会使 prior pipeline 的有效批处理大小增加 2 倍。
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
现在将所有提示词和嵌入传递给 KandinskyPipeline 以生成图像:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
将 image_embeds 和 negative_image_embeds 传入 KandinskyV22Pipeline 以生成图像:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3 无需预训练模型,因此您可以直接加载 Kandinsky3Pipeline 并传入提示词来生成图像:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers 还提供了端到端 API,即 KandinskyCombinedPipeline 和 KandinskyV22CombinedPipeline,这意味着您无需分别加载 prior 和 text-to-image 流水线。组合流水线会自动加载 prior 模型和 decoder。如果您愿意,仍然可以通过 prior_guidance_scale 和 prior_num_inference_steps 参数为 prior 流水线设置不同的值。
使用 AutoPipelineForText2Image 可在底层自动调用组合管道:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
image图像到图像
对于图像到图像任务,请将初始图像和文本提示词传递给流水线,以作为生成图像的条件。首先,加载先验流水线:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3 不需要预训练模型,因此您可以直接加载图像到图像流水线:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
下载一张用于条件生成的图像:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))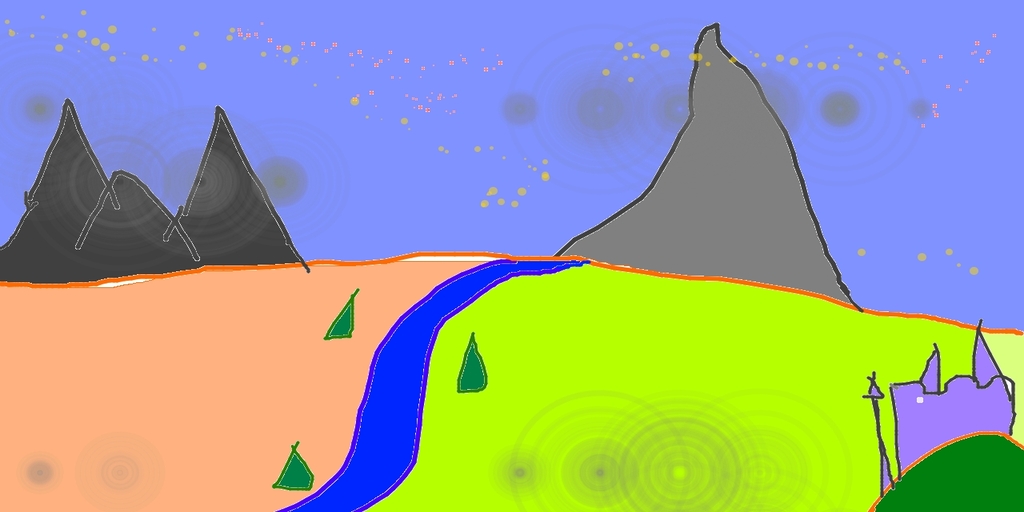
使用先前的流水线生成 image_embeds 和 negative_image_embeds:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
现在将原始图像以及所有提示词和嵌入向量传入流水线以生成图像:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers 还提供了端到端 API,即 KandinskyImg2ImgCombinedPipeline 和 KandinskyV22Img2ImgCombinedPipeline,这意味着您无需分别加载 prior 和图像到图像 pipeline。组合 pipeline 会自动加载 prior 模型和 decoder。如果您愿意,仍然可以通过 prior_guidance_scale 和 prior_num_inference_steps 参数为 prior pipeline 设置不同的值。
使用 AutoPipelineForImage2Image 可在底层自动调用组合管道:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)图像修复
⚠️ Kandinsky 模型现在使用 ⬜️ 白色像素 而非黑色像素来表示遮罩区域。如果您在生产环境中使用 KandinskyInpaintPipeline,需要将遮罩更改为使用白色像素:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
对于图像修复(inpainting),您需要原始图像、原始图像中待替换区域的掩码,以及描述要修复内容的文本提示。加载之前的流水线:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")加载初始图像并创建掩码:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
使用先前的流水线生成嵌入:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
现在将初始图像、掩码、提示词和嵌入传递给管道以生成图像:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
您还可以使用端到端的 KandinskyInpaintCombinedPipeline 和 KandinskyV22InpaintCombinedPipeline,在底层同时调用 prior 和 decoder 流水线。请使用 AutoPipelineForInpainting 来实现:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)插值
插值允许你探索图像嵌入和文本嵌入之间的潜在空间,这是一种查看先前模型中间输出的有趣方式。加载先前管道以及你想要进行插值的两张图像:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

指定要插值的文本或图像,并为每个文本或图像设置权重。尝试调整权重,观察它们如何影响插值效果!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
调用 interpolate 函数生成嵌入,然后将其传递给 pipeline 以生成图像:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet 仅支持 Kandinsky 2.2!
ControlNet 允许使用深度图或边缘检测等额外输入来为大型预训练扩散模型提供条件。例如,你可以使用深度图为 Kandinsky 2.2 提供条件,使模型能够理解并保留深度图像的结构。
让我们加载一张图像并提取其深度图:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
然后,您可以使用 🤗 Transformers 中的 depth-estimation Pipeline 来处理图像并获取深度图:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
文本到图像
加载先前的 pipeline 和 KandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
根据提示词和负面提示词生成图像嵌入:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
最后,将图像嵌入和深度图像传入 KandinskyV22ControlnetPipeline 以生成图像:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
图像到图像
对于使用 ControlNet 的图像到图像任务,您需要使用:
- 使用 KandinskyV22PriorEmb2EmbPipeline 从文本提示词和图像生成图像嵌入
- 使用 KandinskyV22ControlnetImg2ImgPipeline 根据初始图像和图像嵌入生成图像
使用 🤗 Transformers 中的 Pipeline 对一张猫的初始图像进行处理,并提取其深度图,管道类型为 depth-estimation:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
加载先前的 pipeline 和 KandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
将文本提示和初始图像传入 prior 流水线,以生成图像嵌入:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
现在,您可以运行 KandinskyV22ControlnetImg2ImgPipeline,根据初始图像和图像嵌入生成图像:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
优化
Kandinsky 的独特之处在于,它需要一个前置流水线来生成映射,以及一个第二流水线将潜在变量解码为图像。优化工作应集中在第二流水线上,因为大部分计算都在此完成。以下是一些在推理阶段提升 Kandinsky 性能的技巧。
- 如果您使用的是 PyTorch < 2.0,请启用 xFormers:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- 如果您使用的是 PyTorch >= 2.0,请启用
torch.compile以自动使用缩放点积注意力(SDPA):
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
这与显式将注意力处理器设置为使用 AttnAddedKVProcessor2_0 的效果相同:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- 使用 enable_model_cpu_offload() 将模型卸载到 CPU,以避免内存不足错误:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- 默认情况下,文本到图像流水线使用 DDIMScheduler,但您可以将其替换为其他调度器,例如 DDPMScheduler,以观察其对推理速度与图像质量之间权衡的影响:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
class diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
参数
- prior (PriorTransformer) — 用于从文本嵌入近似图像嵌入的 unCLIP 标准先验模型。
- image_encoder (
CLIPVisionModelWithProjection) — 冻结的图像编码器。 - text_encoder (
CLIPTextModelWithProjection) — 冻结的文本编码器。 - tokenizer (
CLIPTokenizer) — CLIPTokenizer 类的分词器。 - scheduler (
UnCLIPScheduler) — 用于与prior配合以生成图像嵌入的调度器。
用于生成 Kandinsky 图像先验的 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - num_inference_steps (
int,可选,默认为 25) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - output_type (
str,可选,默认为"pt") — 生成图像的格式。可选值:"np"(np.array)或"pt"(torch.Tensor)。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
KandinskyPriorPipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
参数
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — 用于引导图像生成的提示词和图像列表。 - weights — (
list[float]):images_and_prompts中每个条件对应的权重列表 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - num_inference_steps (
int,可选,默认为 25) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - negative_prior_prompt (
str, 可选) — 用于不引导先验扩散过程的提示词。在未使用引导时会被忽略(即当guidance_scale小于1时忽略)。 - negative_prompt (
str或list[str],可选) — 用于不引导图像生成的提示词。在未使用引导时会被忽略(即当guidance_scale小于1时会被忽略)。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。
返回值
KandinskyPriorPipelineOutput 或 tuple
在使用先前流水线进行插值时调用的函数。
示例:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
class diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (
DDIMScheduler|DDPMScheduler) — 用于与unet配合以生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 解码器,用于从潜变量生成图像。
使用 Kandinsky 进行文本到图像生成的 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于负面文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
class diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (
DDIMScheduler|DDPMScheduler) — 用于与unet配合以生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 解码器,用于从潜变量生成图像。
- prior_prior (PriorTransformer) — 用于从文本嵌入近似图像嵌入的 unCLIP 标准先验模型。
- prior_image_encoder (
CLIPVisionModelWithProjection) — 冻结的图像编码器。 - prior_text_encoder (
CLIPTextModelWithProjection) — 冻结的文本编码器。 - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 类的分词器。 - prior_scheduler (
UnCLIPScheduler) — 用于与prior配合以生成图像嵌入的调度器。
使用 Kandinsky 进行文本到图像生成的组合 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - prior_guidance_scale (
float,可选,默认值为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - prior_num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但推理速度会变慢。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
使用 🤗 Accelerate 将所有模型(unet、text_encoder、vae 和 safety checker 的状态字典)卸载到 CPU,从而显著降低内存占用。模型会被移至 torch.device('meta'),仅在其特定子模块的 forward 方法被调用时才会加载到 GPU 上。卸载操作以子模块为单位进行。与使用 enable_model_cpu_offload 相比,内存节省更多,但性能较低。
KandinskyImg2ImgPipeline
class diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (DDIMScheduler) —
用于与
unet配合生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 图像编码器与解码器
使用 Kandinsky 进行图像到图像生成的 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - image (
torch.Tensor,PIL.Image.Image) —Image,或表示图像批次的张量,将用作该流程的起始点。 - image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于负面文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - strength (
float, 可选,默认为 0.3) — 从概念上讲,表示对参考image进行多大程度的变换。取值必须在 0 到 1 之间。image将作为起始点,strength越大,添加的噪声越多。去噪步数取决于初始添加的噪声量。当strength为 1 时,添加的噪声达到最大值,去噪过程将运行num_inference_steps中指定的完整迭代次数。因此,值为 1 时,实际上会忽略image。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
class diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (
DDIMScheduler|DDPMScheduler) — 用于与unet配合以生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 解码器,用于从潜变量生成图像。
- prior_prior (PriorTransformer) — 用于从文本嵌入近似图像嵌入的 unCLIP 标准先验模型。
- prior_image_encoder (
CLIPVisionModelWithProjection) — 冻结的图像编码器。 - prior_text_encoder (
CLIPTextModelWithProjection) — 冻结的文本编码器。 - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 类的分词器。 - prior_scheduler (
UnCLIPScheduler) — 用于与prior配合以生成图像嵌入的调度器。
使用 Kandinsky 进行图像到图像生成的组合 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - image (
torch.Tensor、PIL.Image.Image、np.ndarray、list[torch.Tensor]、list[PIL.Image.Image]或list[np.ndarray]) —Image,或表示图像批次的张量,将用作该过程的起点。如果直接传入潜在表示,也可以接受图像潜在表示作为image,此时不会再次进行编码。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - strength (
float, 可选,默认为 0.3) — 从概念上讲,表示对参考image进行多大程度的变换。取值必须在 0 到 1 之间。image将作为起始点,strength越大,添加的噪声越多。去噪步数取决于初始添加的噪声量。当strength为 1 时,添加的噪声达到最大值,去噪过程将运行num_inference_steps中指定的完整迭代次数。因此,值为 1 时,实际上会忽略image。 - prior_guidance_scale (
float,可选,默认值为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - prior_num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但推理速度会变慢。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
class diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (DDIMScheduler) —
用于与
unet配合生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 图像编码器与解码器
使用 Kandinsky2.1 进行文本引导图像修复的 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - image (
torch.Tensor、PIL.Image.Image或np.ndarray) —Image,或表示图像批次的张量,将作为该流程的起始点。 - mask_image (
PIL.Image.Image,torch.Tensor或np.ndarray) —Image,或表示图像批次的张量,用于对image进行遮罩。遮罩中的白色像素将被重绘,而黑色像素将保留。只有当传入的图像是 PyTorch 张量时,才能传入 PyTorch 张量作为遮罩,并且它应包含一个颜色通道(L)而不是三个,因此预期的形状应为(B, 1, H, W,)、(B, H, W)、(1, H, W)或(H, W)。如果图像是 PIL 图像或 numpy 数组,则遮罩也应为 PIL 图像或 numpy 数组。如果是 PIL 图像,在使用前会将其转换为单通道(亮度)。如果是 numpy 数组,预期的形状为(H, W)。 - image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_image_embeds (
torch.Tensor或list[torch.Tensor]) — 用于负面文本提示的 CLIP 图像嵌入,将用于条件化图像生成。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
class diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
参数
- text_encoder (
MultilingualCLIP) — 冻结的文本编码器。 - tokenizer (
XLMRobertaTokenizer) —XLMRobertaTokenizer类的分词器 - scheduler (
DDIMScheduler|DDPMScheduler) — 用于与unet配合以生成图像潜变量的调度器。 - unet (UNet2DConditionModel) — 用于对图像嵌入进行去噪的条件 U-Net 架构。
- movq (VQModel) — MoVQ 解码器,用于从潜变量生成图像。
- prior_prior (PriorTransformer) — 用于从文本嵌入近似图像嵌入的 unCLIP 标准先验模型。
- prior_image_encoder (
CLIPVisionModelWithProjection) — 冻结的图像编码器。 - prior_text_encoder (
CLIPTextModelWithProjection) — 冻结的文本编码器。 - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 类的分词器。 - prior_scheduler (
UnCLIPScheduler) — 用于与prior配合以生成图像嵌入的调度器。
使用 Kandinsky 进行生成的组合 Pipeline
该模型继承自 DiffusionPipeline。有关该库为所有流水线实现的通用方法(例如下载或保存、在特定设备上运行等),请参阅父类文档。
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
参数
- prompt (
str或list[str]) — 用于引导图像生成的提示词或提示词列表。 - image (
torch.Tensor、PIL.Image.Image、np.ndarray、list[torch.Tensor]、list[PIL.Image.Image]或list[np.ndarray]) —Image,或表示图像批次的张量,将用作该过程的起点。如果直接传入潜在表示,也可以接受图像潜在表示作为image,此时不会再次进行编码。 - mask_image (
np.array) — 表示图像批次的张量,用于对image进行遮罩。遮罩中的白色像素将被重绘,而黑色像素将保留。如果mask_image是 PIL 图像,在使用前会先转换为单通道(亮度)。如果它是张量,则应包含一个颜色通道(L)而不是 3 个,因此预期的形状应为(B, H, W, 1)。 - negative_prompt (
str或list[str],可选) — 用于引导图像生成的反向提示词。当未使用引导时将被忽略(即当guidance_scale小于1时忽略)。 - num_images_per_prompt (
int,可选,默认为 1) — 每个提示词生成的图像数量。 - num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但代价是推理速度变慢。 - height (
int,可选,默认值为 512) — 生成图像的高度(以像素为单位)。 - width (
int,可选,默认值为 512) — 生成图像的宽度(以像素为单位)。 - prior_guidance_scale (
float,可选,默认值为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - prior_num_inference_steps (
int,可选,默认为 100) — 去噪步数。更多的去噪步数通常能生成更高质量的图像,但推理速度会变慢。 - guidance_scale (
float,可选,默认为 4.0) — Classifier-Free Diffusion Guidance 中定义的引导尺度。guidance_scale定义为 Imagen Paper 中公式 2 的w。通过设置guidance_scale > 1来启用引导尺度。较高的引导尺度会促使生成与文本prompt紧密关联的图像,通常以牺牲图像质量为代价。 - generator (
torch.Generator或list[torch.Generator],可选) — 一个或一组 torch 生成器,用于使生成过程具有确定性。 - latents (
torch.Tensor, 可选) — 预先生成的噪声潜变量,从高斯分布中采样得到,用作图像生成的输入。可用于使用不同的提示词对同一生成过程进行微调。如果未提供,将通过使用提供的随机generator进行采样来生成一个潜变量张量。 - output_type (
str,可选,默认为"pil") — 生成图像的输出格式。可选值:"pil"(PIL.Image.Image)、"np"(np.array) 或"pt"(torch.Tensor)。 - callback (
Callable, 可选) — 一个在推理过程中每隔callback_steps步调用一次的函数。该函数以以下参数被调用:callback(step: int, timestep: int, latents: torch.Tensor)。 - callback_steps (
int,可选,默认为 1) — 调用callback函数的频率。如果未指定,则会在每一步调用该回调。 - return_dict (
bool,可选,默认为True) — 是否返回 ImagePipelineOutput 而不是普通元组。
返回值
ImagePipelineOutput 或 tuple
调用生成 pipeline 时调用的函数。
示例:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.