
Diffusers documentation
Marigold Computer Vision
Marigold Computer Vision
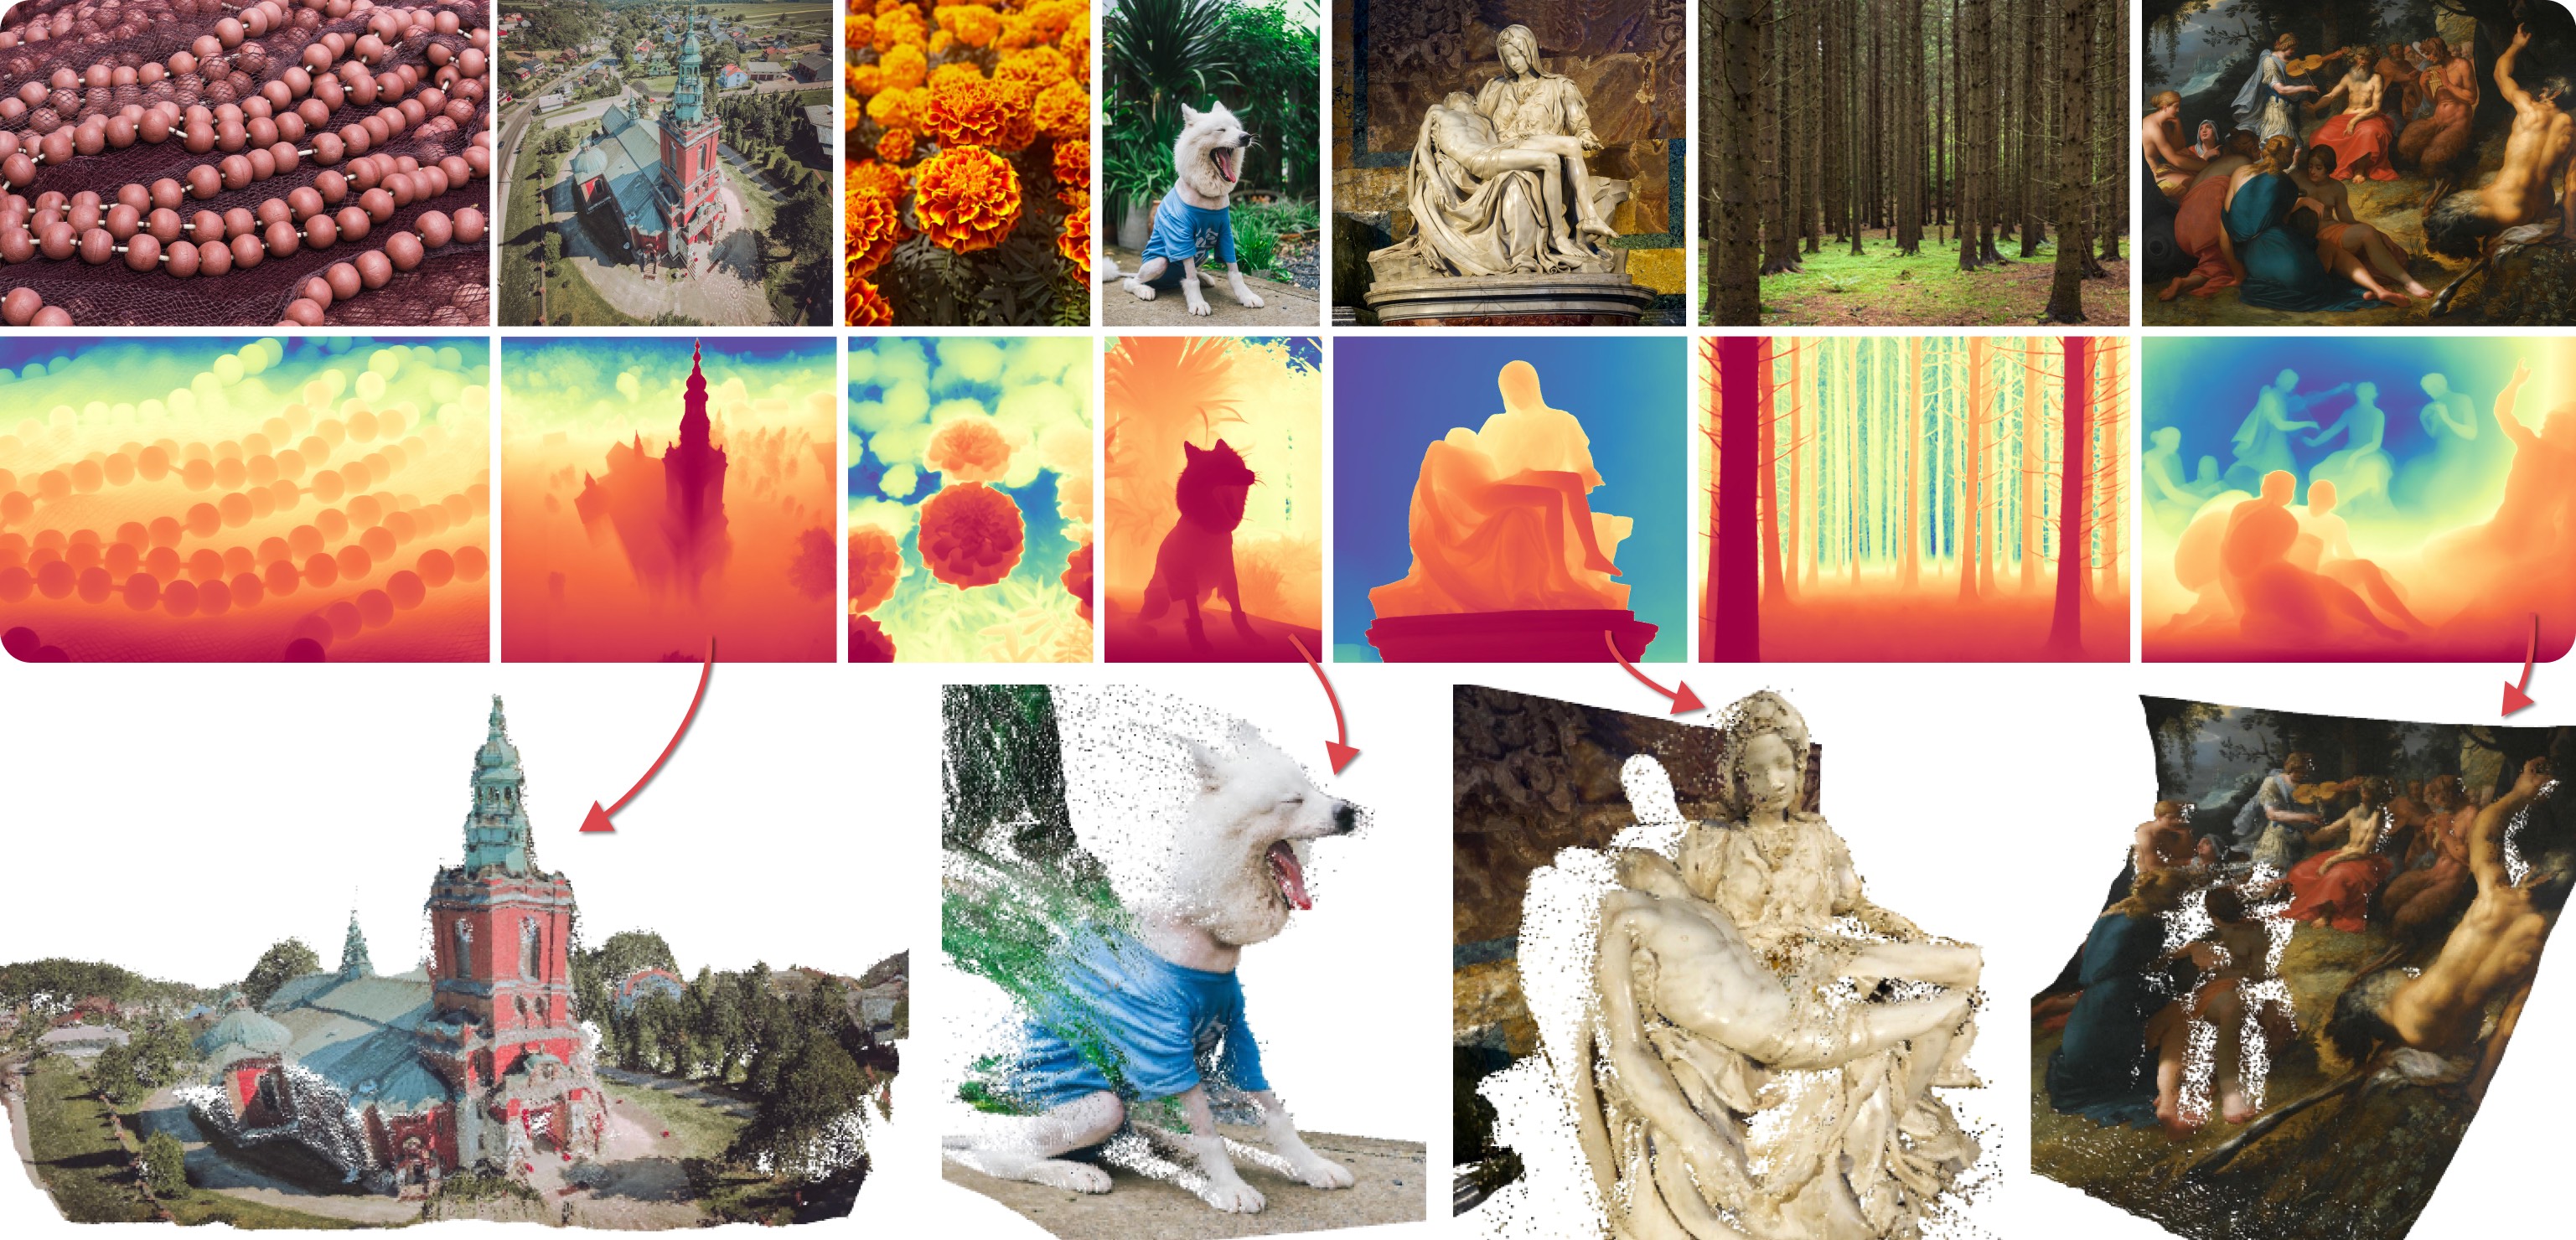
Marigold được đề xuất trong Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, một bài báo Oral tại CVPR 2024 của Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt và Konrad Schindler. Ý tưởng cốt lõi là tái sử dụng tiên nghiệm sinh của các Text-to-Image Latent Diffusion Models (LDMs) cho các tác vụ thị giác máy tính truyền thống. Cách tiếp cận này được khám phá bằng cách tinh chỉnh Stable Diffusion cho Monocular Depth Estimation, như được minh họa trong hình teaser ở trên.
Marigold sau đó được mở rộng trong bài báo tiếp theo, Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, do Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov và Konrad Schindler thực hiện. Công trình này đã mở rộng Marigold để hỗ trợ các chế độ mới như Surface Normals và Intrinsic Image Decomposition (IID), giới thiệu một giao thức huấn luyện cho Latent Consistency Models (LCM) và chứng minh khả năng xử lý High-Resolution (HR).
Các mô hình Marigold ban đầu (
v1-0và các phiên bản trước đó) được tối ưu hóa để đạt kết quả tốt nhất với ít nhất 10 bước suy luận. Các mô hình LCM sau đó được phát triển để cho phép suy luận chất lượng cao chỉ trong 1 đến 4 bước. Các mô hình Marigoldv1-1và các phiên bản sau đó sử dụng trình lập lịch DDIM để đạt kết quả tối ưu chỉ trong 1 đến 4 bước.
Các Pipeline khả dụng
Mỗi pipeline được thiết kế riêng cho một tác vụ thị giác máy tính cụ thể, xử lý một ảnh RGB đầu vào và tạo ra dự đoán tương ứng. Hiện tại, các tác vụ thị giác máy tính sau đã được triển khai:
| Pipeline | Các điểm kiểm tra mô hình được khuyến nghị | Spaces (Ứng dụng tương tác) | Các phương thức dự đoán |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Ước lượng độ sâu | Độ sâu, Độ lệch |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Ước lượng pháp tuyến bề mặt | Pháp tuyến bề mặt |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Phân tách ảnh nội tại | Albedo, Vật liệu, Chiếu sáng |
Các điểm kiểm tra khả dụng
Tất cả các checkpoint gốc đều có sẵn dưới tổ chức PRS-ETH trên Hugging Face. Chúng được thiết kế để sử dụng với các pipeline của diffusers và mã nguồn gốc, vốn cũng có thể được dùng để huấn luyện các checkpoint mô hình mới. Dưới đây là tóm tắt về các checkpoint được khuyến nghị, tất cả đều cho kết quả đáng tin cậy với 1 đến 4 bước.
| Checkpoint | Phương thức | Bình luận |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Độ sâu | Dự đoán độ sâu bất biến affine gán cho mỗi pixel một giá trị nằm trong khoảng từ 0 (mặt phẳng gần) đến 1 (mặt phẳng xa), trong đó cả hai mặt phẳng đều được mô hình xác định trong quá trình suy luận. |
| prs-eth/marigold-normals-v0-1 | Pháp tuyến | Dự đoán pháp tuyến bề mặt là các vector 3D có độ dài đơn vị trong không gian màn hình của camera, với giá trị trong khoảng từ -1 đến 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Đặc tính nội tại | Phân rã InteriorVerse bao gồm Albedo và hai thuộc tính vật liệu BRDF: Roughness và Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Đặc tính nội tại | Phân tách HyperSim của một hình ảnh gồm Albedo $A$, Bóng đổ khuếch tán $S$, và Phần dư không khuếch tán $R$: $I = A*S+R$. |
Hãy chắc chắn xem qua hướng dẫn về Schedulers để tìm hiểu cách khám phá sự đánh đổi giữa tốc độ và chất lượng của scheduler, và xem phần tái sử dụng các thành phần giữa các pipeline để tìm hiểu cách nạp hiệu quả cùng một thành phần vào nhiều pipeline. Ngoài ra, để biết thêm về việc giảm mức sử dụng bộ nhớ của pipeline này, hãy tham khảo phần [“Giảm mức sử dụng bộ nhớ”] tại đây.
Các pipeline Marigold được thiết kế và kiểm thử với scheduler được nhúng trong checkpoint của model. Số bước suy luận tối ưu thay đổi tùy theo scheduler, không có giá trị phổ quát nào hoạt động tốt nhất trong mọi trường hợp. Để đáp ứng điều này, tham số
num_inference_stepstrong phương thức__call__của pipeline mặc định làNone(xem API reference). Trừ khi được đặt rõ ràng, giá trị này sẽ kế thừa từ trườngdefault_denoising_stepstrong tệp cấu hình checkpoint (model_index.json). Điều này đảm bảo các dự đoán chất lượng cao khi gọi pipeline chỉ với đối sốimage.
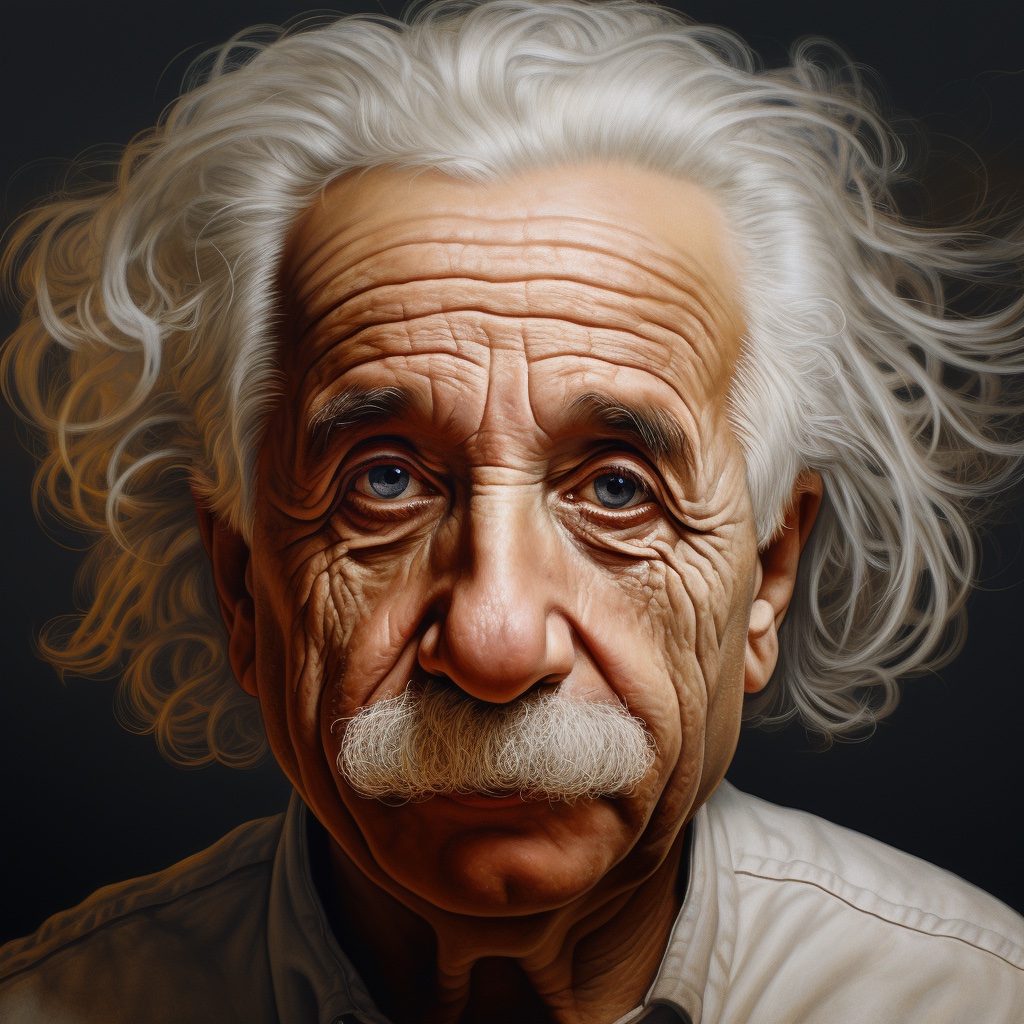
Các ví dụ bên dưới chủ yếu được đưa ra cho dự đoán độ sâu, nhưng chúng có thể được áp dụng phổ quát cho các chế độ (modalities) khác được hỗ trợ. Chúng tôi trình bày các dự đoán bằng cách sử dụng cùng một hình ảnh đầu vào của Albert Einstein được tạo bởi Midjourney. Điều này giúp dễ dàng so sánh các trực quan hóa của các dự đoán giữa các chế độ và các checkpoint khác nhau.
Dự đoán độ sâu
Để có được dự đoán độ sâu, hãy nạp checkpoint prs-eth/marigold-depth-v1-1 vào MarigoldDepthPipeline,
đưa ảnh qua pipeline và lưu các dự đoán:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
Hàm visualize_depth() áp dụng một trong các colormap của matplotlib (mặc định là Spectral) để ánh xạ các giá trị pixel dự đoán từ khoảng độ sâu đơn kênh [0, 1] thành một hình ảnh RGB.
Với colormap Spectral, các pixel có độ sâu gần được tô màu đỏ, còn các pixel xa được tô màu xanh dương.
Tệp PNG 16-bit lưu trữ các giá trị đơn kênh được ánh xạ tuyến tính từ khoảng [0, 1] sang [0, 65535].
Dưới đây là các dự đoán thô và đã được trực quan hóa. Các vùng tối hơn và gần hơn (phần ria mép) dễ phân biệt hơn trong
bản trực quan hóa.


Ước lượng pháp tuyến bề mặt
Tải checkpoint prs-eth/marigold-normals-v1-1 vào MarigoldNormalsPipeline, đưa ảnh qua pipeline và lưu các dự đoán:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
visualize_normals() ánh xạ dự đoán ba chiều có giá trị pixel trong khoảng [-1, 1] thành một ảnh RGB.
Hàm trực quan hóa hỗ trợ lật các trục pháp tuyến bề mặt để làm cho việc trực quan hóa tương thích với các lựa chọn khác của hệ quy chiếu.
Về mặt khái niệm, mỗi pixel được tô màu theo vector pháp tuyến bề mặt trong hệ quy chiếu, trong đó trục X
chỉ sang phải, trục Y chỉ lên trên và trục Z chỉ về phía người xem.
Dưới đây là dự đoán đã được trực quan hóa:

Trong ví dụ này, mũi gần như chắc chắn có một điểm trên bề mặt mà tại đó vector pháp tuyến của bề mặt hướng thẳng về phía người xem, nghĩa là tọa độ của nó là [0, 0, 1].
Vector này ánh xạ sang RGB [128, 128, 255], tương ứng với màu tím-xanh dương.
Tương tự, một vector pháp tuyến trên má ở phần bên phải của hình ảnh có thành phần X lớn, làm tăng sắc đỏ.
Các điểm trên vai hướng lên với thành phần Y lớn sẽ tạo ra màu xanh lá cây.
Phân tách ảnh nội tại
Marigold cung cấp hai mô hình cho Phân tách Ảnh Nội tại (IID): “Appearance” và “Lighting”. Mỗi mô hình tạo ra các bản đồ Albedo, lần lượt được suy ra từ các chú thích của InteriorVerse và Hypersim.
- Mô hình “Appearance” cũng ước tính các thuộc tính Vật liệu: Roughness và Metallicity.
- Mô hình “Lighting” tạo ra Diffuse Shading và Non-diffuse Residual.
Dưới đây là mã mẫu lưu các dự đoán do mô hình “Appearance” tạo ra:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Một ví dụ khác minh họa các dự đoán do mô hình “Lighting” đưa ra:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Cả hai mô hình đều chia sẻ cùng một pipeline trong khi hỗ trợ các kiểu phân rã khác nhau.
Tham số hóa phân rã chính xác (ví dụ: không gian sRGB so với không gian tuyến tính) được lưu trong từ điển pipe.target_properties, vốn được truyền vào hàm visualize_intrinsics().
Dưới đây là một số ví dụ minh họa cho kết quả phân rã dự đoán. Tất cả các phương thức (modality) có thể được xem xét trong Space Intrinsic Image Decomposition.


Tăng tốc suy luận
Các đoạn mã khởi động nhanh ở trên đã được tối ưu hóa cho chất lượng và tốc độ, bao gồm việc nạp checkpoint, sử dụng biến thể fp16 của trọng số và phép tính, cũng như thực hiện số bước khuếch tán khử nhiễu mặc định (4).
Bước đầu tiên để tăng tốc suy luận, với cái giá là chất lượng dự đoán, là giảm số bước khuếch tán khử nhiễu xuống mức tối thiểu:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Với thay đổi này, lệnh gọi pipe hoàn tất trong 280ms trên GPU RTX 3090.
Bên trong, hình ảnh đầu vào trước tiên được mã hóa bằng trình mã hóa VAE của Stable Diffusion, sau đó là một bước khử nhiễu duy nhất do U-Net thực hiện.
Cuối cùng, latent dự đoán được giải mã bằng trình giải mã VAE vào không gian pixel.
Trong cấu hình này, hai trong số ba lệnh gọi module được dành riêng cho việc chuyển đổi giữa không gian pixel và không gian latent của LDM.
Vì không gian latent của Marigold tương thích với Stable Diffusion 2.0, suy luận có thể được tăng tốc hơn 3 lần,
giảm thời gian gọi xuống còn 85ms trên RTX 3090, bằng cách sử dụng bản thay thế VAE SD nhẹ hơn.
Lưu ý rằng việc sử dụng VAE nhẹ có thể làm giảm nhẹ chất lượng hình ảnh của các dự đoán.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Cho đến nay, chúng ta đã tối ưu hóa số bước khuếch tán và các thành phần của mô hình. Các thao tác tự chú ý chiếm một phần đáng kể trong các phép tính. Việc tăng tốc chúng có thể đạt được bằng cách sử dụng bộ xử lý chú ý hiệu quả hơn:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Cuối cùng, như đã đề xuất trong Tối ưu hóa, việc bật torch.compile có thể nâng cao hiệu suất hơn nữa tùy thuộc vào phần cứng đích.
Tuy nhiên, quá trình biên dịch gây ra chi phí đáng kể trong lần gọi pipeline đầu tiên, do đó chỉ mang lại lợi ích khi cùng một instance pipeline được gọi lặp đi lặp lại, chẳng hạn như trong một vòng lặp.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Tối ưu hóa độ chính xác và kết hợp mô hình
Các pipeline Marigold có cơ chế ensembling tích hợp, kết hợp nhiều dự đoán từ các latent ngẫu nhiên khác nhau.
Đây là cách brute-force để cải thiện độ chính xác của các dự đoán, tận dụng bản chất sinh của diffusion.
Đường dẫn ensembling được kích hoạt tự động khi tham số ensemble_size được đặt lớn hơn hoặc bằng 3.
Khi hướng tới độ chính xác tối đa, việc điều chỉnh đồng thời num_inference_steps cùng với ensemble_size là hợp lý.
Các giá trị khuyến nghị thay đổi giữa các checkpoint nhưng chủ yếu phụ thuộc vào loại scheduler.
Hiệu ứng của ensembling được thể hiện rõ nhất với surface normals:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
Như có thể thấy, tất cả các vùng có cấu trúc chi tiết, chẳng hạn như tóc, đều cho ra các dự đoán thận trọng hơn và chính xác hơn về mặt trung bình. Kết quả như vậy phù hợp hơn cho các tác vụ hạ nguồn nhạy cảm với độ chính xác, chẳng hạn như tái tạo 3D.
Xử lý video theo từng khung hình với tính nhất quán theo thời gian
Do bản chất sinh của Marigold, mỗi dự đoán là duy nhất và được xác định bởi nhiễu ngẫu nhiên được lấy mẫu cho việc khởi tạo ẩn. Điều này trở thành một nhược điểm rõ ràng so với các mạng hồi quy dày đặc end-to-end truyền thống, như được minh họa trong các video sau:


Để giải quyết vấn đề này, bạn có thể truyền tham số latents vào các pipeline, trong đó xác định điểm bắt đầu của quá trình khuếch tán.
Về mặt thực nghiệm, chúng tôi nhận thấy rằng tổ hợp lồi của cùng một nhiễu latent tại điểm bắt đầu và latent tương ứng với dự đoán khung hình trước đó cho kết quả đủ mượt mà, như được triển khai trong đoạn mã bên dưới:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Ở đây, quá trình khuếch tán bắt đầu từ latent đã được tính toán cho trước.
Pipeline đặt output_latent=True để truy cập out.latent và tính toán đóng góp của nó vào việc khởi tạo latent của khung hình tiếp theo.
Kết quả giờ đây ổn định hơn nhiều:

Marigold cho ControlNet
Một ứng dụng rất phổ biến của dự đoán độ sâu bằng mô hình khuếch tán là kết hợp với ControlNet. Độ sắc nét của độ sâu đóng vai trò then chốt trong việc đạt được kết quả chất lượng cao từ ControlNet. Như đã thấy trong các so sánh với các phương pháp khác ở trên, Marigold vượt trội trong nhiệm vụ đó. Đoạn mã dưới đây minh họa cách tải một hình ảnh, tính toán độ sâu và truyền nó vào ControlNet ở định dạng tương thích:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")


Đánh giá định lượng
Để đánh giá Marigold một cách định lượng trên các bảng xếp hạng và bộ chuẩn (benchmark) tiêu chuẩn (chẳng hạn như NYU, KITTI và các bộ dữ liệu khác),
hãy làm theo giao thức đánh giá được mô tả trong bài báo: tải mô hình độ chính xác đầy đủ fp32 và sử dụng các giá trị phù hợp
cho num_inference_steps và ensemble_size.
Tùy chọn, hãy đặt seed cho tính ngẫu nhiên để đảm bảo khả năng tái lập.
Tối đa hóa batch_size sẽ mang lại mức sử dụng thiết bị cao nhất.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Sử dụng Độ bất định dự đoán
Cơ chế ensembling được tích hợp sẵn trong các pipeline của Marigold kết hợp nhiều dự đoán thu được từ các latent ngẫu nhiên khác nhau.
Như một tác dụng phụ, nó có thể được sử dụng để định lượng sự không chắc chắn epistemic (của mô hình); chỉ cần chỉ định ensemble_size lớn hơn hoặc bằng 3 và đặt output_uncertainty=True.
Sự không chắc chắn thu được sẽ có sẵn trong trường uncertainty của đầu ra.
Nó có thể được trực quan hóa như sau:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


Việc diễn giải độ bất định rất đơn giản: các giá trị cao hơn (màu trắng) tương ứng với các pixel mà mô hình gặp khó khăn trong việc đưa ra các dự đoán nhất quán.
- Mô hình độ sâu thể hiện mức độ bất định cao nhất quanh các điểm gián đoạn, nơi độ sâu của đối tượng thay đổi đột ngột.
- Mô hình pháp tuyến bề mặt ít tự tin nhất ở các cấu trúc chi tiết như tóc và ở các vùng tối như khu vực cổ áo.
- Uncertainty của albedo được biểu diễn dưới dạng ảnh RGB, vì nó nắm bắt uncertainty một cách độc lập cho từng kênh màu, khác với độ sâu và pháp tuyến bề mặt. Nó cũng cao hơn ở các vùng bị bóng râm và tại các điểm gián đoạn.
API Dự đoán Độ sâu Marigold
lớp diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Tham số
- unet (
UNet2DConditionModel) — U-Net có điều kiện để khử nhiễu latent chiều sâu, được điều kiện bởi latent hình ảnh. - vae (
AutoencoderKL) — Mô hình Variational Auto-Encoder (VAE) để mã hóa và giải mã hình ảnh cũng như các dự đoán sang và từ các biểu diễn ẩn (latent). - scheduler (
DDIMSchedulerhoặcLCMScheduler) — Một scheduler được sử dụng kết hợp vớiunetđể khử nhiễu các latents của ảnh đã mã hóa. - text_encoder (
CLIPTextModel) — Bộ mã hóa văn bản, dùng cho nhúng văn bản rỗng. - tokenizer (
CLIPTokenizer) — Tokenizer của CLIP. - prediction_type (
str, tùy chọn) — Loại dự đoán do mô hình thực hiện. - scale_invariant (
bool, tùy chọn) — Thuộc tính của mô hình chỉ định xem các bản đồ độ sâu dự đoán có bất biến theo tỷ lệ hay không. Giá trị này phải được đặt trong cấu hình mô hình. Khi được sử dụng cùng với cờshift_invariant=True, mô hình còn được gọi là “bất biến theo affine”. Lưu ý: việc ghi đè giá trị này không được hỗ trợ. - shift_invariant (
bool, tùy chọn) — Thuộc tính của mô hình chỉ định xem các bản đồ độ sâu dự đoán có bất biến theo phép dịch hay không. Giá trị này phải được đặt trong cấu hình mô hình. Khi được sử dụng cùng với cờscale_invariant=True, mô hình còn được gọi là “bất biến theo phép affine”. Lưu ý: việc ghi đè giá trị này không được hỗ trợ. - default_denoising_steps (
int, tùy chọn) — Số lượng bước khuếch tán khử nhiễu tối thiểu cần thiết để tạo ra dự đoán có chất lượng hợp lý với mô hình đã cho. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõnum_inference_steps, giá trị mặc định sẽ được sử dụng. Điều này là cần thiết để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau tương thích với pipeline, chẳng hạn như những biến thể dựa trên lịch trình khử nhiễu rất ngắn (LCMScheduler) và những biến thể có lịch trình khuếch tán đầy đủ (DDIMScheduler). - default_processing_resolution (
int, tùy chọn) — Giá trị khuyến nghị cho tham sốprocessing_resolutioncủa pipeline. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõprocessing_resolution, giá trị mặc định sẽ được sử dụng. Điều này là bắt buộc để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau được huấn luyện với các giá trị độ phân xử lý tối ưu khác nhau.
Pipeline cho ước lượng độ sâu đơn mục sử dụng phương pháp Marigold: https://marigoldmonodepth.github.io.
Mô hình này kế thừa từ DiffusionPipeline. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các pipeline (chẳng hạn như tải xuống hoặc lưu, chạy trên một thiết bị cụ thể, v.v.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Tham số
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: Một hoặc nhiều ảnh đầu vào được sử dụng cho tác vụ ước lượng độ sâu. Đối với mảng và tensor, khoảng giá trị mong đợi nằm trong[0, 1]. Có thể truyền một lô ảnh bằng cách cung cấp một mảng hoặc tensor bốn chiều. Ngoài ra, có thể truyền một danh sách các ảnh dưới dạng mảng hoặc tensor hai hoặc ba chiều. Trong trường hợp sau, tất cả các phần tử trong danh sách phải có cùng chiều rộng và chiều cao. - num_inference_steps (
int, tùy chọn, mặc định làNone) — Số bước khuếch tán khử nhiễu trong quá trình suy luận. Giá trị mặc địnhNonesẽ dẫn đến việc tự động lựa chọn. - ensemble_size (
int, mặc định là1) — Số lượng dự đoán ensemble. Giá trị cao hơn sẽ mang lại cải thiện đáng đo được và suy giảm về mặt hình ảnh. - processing_resolution (
int, tùy chọn, mặc định làNone) — Độ phân xử lý hiệu dụng. Khi đặt thành0, sẽ khớp với chiều lớn hơn của ảnh đầu vào. Điều này tạo ra các dự đoán sắc nét hơn, nhưng cũng có thể dẫn đến mất ngữ cảnh toàn cục. Giá trị mặc địnhNonesẽ được giải quyết thành giá trị tối ưu từ cấu hình mô hình. - match_input_resolution (
bool, tùy chọn, mặc định làTrue) — Khi được bật, dự đoán đầu ra sẽ được thay đổi kích thước để khớp với kích thước đầu vào. Khi bị tắt, cạnh dài hơn của đầu ra sẽ bằng vớiprocessing_resolution. - resample_method_input (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước ảnh đầu vào thànhprocessing_resolution. Các giá trị được chấp nhận là:"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - resample_method_output (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước các dự đoán đầu ra cho khớp với độ phân giải đầu vào. Các giá trị được chấp nhận là"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - batch_size (
int, tùy chọn, mặc định là1) — Kích thước lô; chỉ có ý nghĩa khi thiết lậpensemble_sizehoặc truyền vào một tensor chứa các hình ảnh. - ensembling_kwargs (
dict, tùy chọn, mặc định làNone) — Từ điển bổ sung chứa các đối số để kiểm soát ensembling chính xác. Các tùy chọn sau có sẵn:- reduction (
str, tùy chọn, mặc định là"median"): Xác định hàm ensembling được áp dụng tại mỗi vị trí pixel, có thể là"median"hoặc"mean". - regularizer_strength (
float, tùy chọn, mặc định là0.02): Độ mạnh của bộ điều hòa (regularizer) kéo các dự đoán đã căn chỉnh về khoảng đơn vị từ 0 đến 1. - max_iter (
int, tùy chọn, mặc định là2): Số bước tối đa của bộ giải căn chỉnh. Tham khảo hàmscipy.optimize.minimize, đối sốoptions. - tol (
float, tùy chọn, mặc định là1e-3): Độ dung sai của bộ giải căn chỉnh. Bộ giải sẽ dừng lại khi đạt đến độ dung sai. - max_res (
int, tùy chọn, mặc định làNone): Độ phân giải mà việc căn chỉnh được thực hiện;Nonekhớp vớiprocessing_resolution.
- reduction (
- latents (
torch.Tensor, hoặclist[torch.Tensor], tuỳ chọn, mặc định làNone) — Các tensor nhiễu tiềm ẩn để thay thế cho việc khởi tạo ngẫu nhiên. Chúng có thể được lấy từ đầu ra của lần gọi hàm trước đó. - generator (
torch.Generator, hoặclist[torch.Generator], tuỳ chọn, mặc định làNone) — Đối tượng bộ sinh số ngẫu nhiên để đảm bảo khả năng tái lập. - output_type (
str, tùy chọn, mặc định là"np") — Định dạng ưu tiên cho trườngpredictioncủa kết quả đầu ra và trườnguncertaintytùy chọn. Các giá trị được chấp nhận là:"np"(mảng numpy) hoặc"pt"(tensor torch). - output_uncertainty (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnguncertaintycủa kết xuất sẽ chứa bản đồ bất định dự đoán, với điều kiện tham sốensemble_sizeđược đặt thành một giá trị lớn hơn 2. - output_latent (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnglatentcủa đầu ra sẽ chứa các mã latent tương ứng với các dự đoán trong ensemble. Các mã này có thể được lưu lại, chỉnh sửa và sử dụng cho các lần gọi tiếp theo với tham sốlatents. - return_dict (
bool, tùy chọn, mặc định làTrue) — Có nên trả về một MarigoldDepthOutput thay vì một tuple thông thường hay không.
Trả về
MarigoldDepthOutput hoặc tuple
Nếu return_dict là True, MarigoldDepthOutput sẽ được trả về, ngược lại một
tuple sẽ được trả về trong đó phần tử đầu tiên là dự đoán, phần tử thứ hai là độ bất định
(hoặc None), và phần tử thứ ba là latent (hoặc None).
Hàm được gọi khi gọi pipeline.
Ví dụ:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
lớp diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Tham số
- prediction (
np.ndarray,torch.Tensor) — Các bản đồ độ sâu dự đoán với giá trị trong khoảng [0, 1]. Hình dạng lànumimages × 1 × height × widthđối vớitorch.Tensorhoặcnumimages × height × width × 1đối vớinp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Các bản đồ độ không chắc chắn được tính từ ensemble, với giá trị trong khoảng [0, 1]. Hình dạng lànumimages × 1 × height × widthđối vớitorch.Tensorhoặcnumimages × height × width × 1đối vớinp.ndarray. - latent (
None,torch.Tensor) — Các đặc trưng ẩn tương ứng với các dự đoán, tương thích với tham sốlatentscủa pipeline. Hình dạng lànumimages * numensemble × 4 × latentheight × latentwidth.
Lớp đầu ra cho pipeline dự đoán độ sâu đơn mục Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Tham số
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): Bản đồ độ sâu. - val_min (
float, tùy chọn, mặc định là0.0) — Giá trị tối thiểu của phạm vi độ sâu được trực quan hóa. - val_max (
float, tùy chọn, mặc định là1.0) — Giá trị tối đa của phạm vi độ sâu được trực quan hóa. - color_map (
str, không bắt buộc, mặc định là"Spectral") — Bản đồ màu được sử dụng để chuyển đổi dự đoán độ sâu một kênh thành biểu diễn có màu.
Trực quan hóa các bản đồ độ sâu, chẳng hạn như các dự đoán của MarigoldDepthPipeline.
Trả về: list[PIL.Image.Image] với trực quan hóa bản đồ độ sâu.
API Ước lượng Vector pháp tuyến Marigold
lớp diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Tham số
- unet (
UNet2DConditionModel) — U-Net có điều kiện để khử nhiễu cho latent của normals, được điều kiện bởi latent của ảnh. - vae (
AutoencoderKL) — Mô hình Variational Auto-Encoder (VAE) để mã hóa và giải mã hình ảnh cũng như các dự đoán sang và từ các biểu diễn ẩn (latent). - scheduler (
DDIMSchedulerhoặcLCMScheduler) — Một scheduler được sử dụng kết hợp vớiunetđể khử nhiễu các latents của ảnh đã mã hóa. - text_encoder (
CLIPTextModel) — Bộ mã hóa văn bản, dùng cho nhúng văn bản rỗng. - tokenizer (
CLIPTokenizer) — Tokenizer của CLIP. - prediction_type (
str, tùy chọn) — Loại dự đoán do mô hình thực hiện. - use_full_z_range (
bool, tùy chọn) — Xác định xem các vector pháp tuyến do mô hình này dự đoán có sử dụng toàn bộ phạm vi của chiều Z hay chỉ một nửa dương của chiều đó. - default_denoising_steps (
int, tùy chọn) — Số lượng bước khuếch tán khử nhiễu tối thiểu cần thiết để tạo ra dự đoán có chất lượng hợp lý với mô hình đã cho. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõnum_inference_steps, giá trị mặc định sẽ được sử dụng. Điều này là cần thiết để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau tương thích với pipeline, chẳng hạn như những biến thể dựa trên lịch trình khử nhiễu rất ngắn (LCMScheduler) và những biến thể có lịch trình khuếch tán đầy đủ (DDIMScheduler). - default_processing_resolution (
int, tùy chọn) — Giá trị khuyến nghị cho tham sốprocessing_resolutioncủa pipeline. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõprocessing_resolution, giá trị mặc định sẽ được sử dụng. Điều này là bắt buộc để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau được huấn luyện với các giá trị độ phân xử lý tối ưu khác nhau.
Pipeline để ước lượng pháp tuyến đơn mục bằng phương pháp Marigold: https://marigoldmonodepth.github.io.
Mô hình này kế thừa từ DiffusionPipeline. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các pipeline (chẳng hạn như tải xuống hoặc lưu, chạy trên một thiết bị cụ thể, v.v.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Tham số
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: Một hoặc nhiều ảnh đầu vào được sử dụng cho tác vụ ước lượng pháp tuyến. Đối với mảng và tensor, khoảng giá trị mong đợi nằm trong[0, 1]. Việc truyền một lô ảnh là khả thi bằng cách cung cấp một mảng hoặc tensor bốn chiều. Ngoài ra, có thể truyền một danh sách các ảnh dưới dạng mảng hoặc tensor hai hoặc ba chiều. Trong trường hợp sau, tất cả các phần tử trong danh sách phải có cùng chiều rộng và chiều cao. - num_inference_steps (
int, tùy chọn, mặc định làNone) — Số bước khuếch tán khử nhiễu trong quá trình suy luận. Giá trị mặc địnhNonesẽ dẫn đến việc tự động lựa chọn. - ensemble_size (
int, mặc định là1) — Số lượng dự đoán ensemble. Giá trị cao hơn sẽ mang lại cải thiện đáng đo được và suy giảm về mặt hình ảnh. - processing_resolution (
int, tùy chọn, mặc định làNone) — Độ phân xử lý hiệu dụng. Khi đặt thành0, sẽ khớp với chiều lớn hơn của ảnh đầu vào. Điều này tạo ra các dự đoán sắc nét hơn, nhưng cũng có thể dẫn đến mất ngữ cảnh toàn cục. Giá trị mặc địnhNonesẽ được giải quyết thành giá trị tối ưu từ cấu hình mô hình. - match_input_resolution (
bool, tùy chọn, mặc định làTrue) — Khi được bật, dự đoán đầu ra sẽ được thay đổi kích thước để khớp với kích thước đầu vào. Khi bị tắt, cạnh dài hơn của đầu ra sẽ bằng vớiprocessing_resolution. - resample_method_input (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước ảnh đầu vào thànhprocessing_resolution. Các giá trị được chấp nhận là:"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - resample_method_output (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước các dự đoán đầu ra cho khớp với độ phân giải đầu vào. Các giá trị được chấp nhận là"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - batch_size (
int, tùy chọn, mặc định là1) — Kích thước lô; chỉ có ý nghĩa khi thiết lậpensemble_sizehoặc truyền vào một tensor chứa các hình ảnh. - ensembling_kwargs (
dict, tùy chọn, mặc định làNone) — Từ điển bổ sung chứa các đối số để kiểm soát ensembling chính xác. Các tùy chọn sau có sẵn:- reduction (
str, tùy chọn, mặc định là"closest"): Xác định hàm ensembling được áp dụng tại mỗi vị trí pixel, có thể là"closest"hoặc"mean".
- reduction (
- latents (
torch.Tensor, tùy chọn, mặc định làNone) — Các tensor nhiễu tiềm ẩn để thay thế cho việc khởi tạo ngẫu nhiên. Chúng có thể được lấy từ đầu ra của lần gọi hàm trước đó. - generator (
torch.Generator, hoặclist[torch.Generator], tuỳ chọn, mặc định làNone) — Đối tượng bộ sinh số ngẫu nhiên để đảm bảo khả năng tái lập. - output_type (
str, tùy chọn, mặc định là"np") — Định dạng ưu tiên cho trườngpredictioncủa kết quả đầu ra và trườnguncertaintytùy chọn. Các giá trị được chấp nhận là:"np"(mảng numpy) hoặc"pt"(tensor torch). - output_uncertainty (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnguncertaintycủa kết xuất sẽ chứa bản đồ bất định dự đoán, với điều kiện tham sốensemble_sizeđược đặt thành một giá trị lớn hơn 2. - output_latent (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnglatentcủa đầu ra sẽ chứa các mã latent tương ứng với các dự đoán trong ensemble. Các mã này có thể được lưu lại, chỉnh sửa và sử dụng cho các lần gọi tiếp theo với tham sốlatents. - return_dict (
bool, tùy chọn, mặc định làTrue) — Có nên trả về một MarigoldNormalsOutput thay vì một tuple thông thường hay không.
Trả về
MarigoldNormalsOutput hoặc tuple
Nếu return_dict là True, MarigoldNormalsOutput sẽ được trả về, ngược lại một
tuple sẽ được trả về trong đó phần tử đầu tiên là dự đoán, phần tử thứ hai là độ bất định
(hoặc None), và phần tử thứ ba là latent (hoặc None).
Hàm được gọi khi gọi pipeline.
Ví dụ:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
lớp diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Tham số
- prediction (
np.ndarray,torch.Tensor) — Các vector pháp tuyến dự đoán với giá trị trong khoảng [-1, 1]. Hình dạng lànumimages × 3 × height × widthđối vớitorch.Tensorhoặcnumimages × height × width × 3đối vớinp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Các bản đồ độ không chắc chắn được tính từ ensemble, với giá trị trong khoảng [0, 1]. Hình dạng lànumimages × 1 × height × widthđối vớitorch.Tensorhoặcnumimages × height × width × 1đối vớinp.ndarray. - latent (
None,torch.Tensor) — Các đặc trưng ẩn tương ứng với các dự đoán, tương thích với tham sốlatentscủa pipeline. Hình dạng lànumimages * numensemble × 4 × latentheight × latentwidth.
Lớp đầu ra cho pipeline dự đoán pháp tuyến đơn mục Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Tham số
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Pháp tuyến bề mặt. - flip_x (
bool, tùy chọn, mặc định làFalse) — Lật trục X của hệ quy chiếu pháp tuyến. Hướng mặc định là sang phải. - flip_y (
bool, tùy chọn, mặc định làFalse) — Lật trục Y của hệ quy chiếu pháp tuyến. Hướng mặc định là lên trên. - flip_z (
bool, tùy chọn, mặc định làFalse) — Lật trục Z của hệ quy chiếu pháp tuyến. Hướng mặc định là hướng về phía người quan sát.
Trực quan hóa các vector pháp tuyến bề mặt, chẳng hạn như các dự đoán của MarigoldNormalsPipeline.
Trả về: list[PIL.Image.Image] với trực quan hóa pháp tuyến bề mặt.
API Phân Tách Ảnh Nội Tại Marigold
lớp diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Tham số
- unet (
UNet2DConditionModel) — U-Net có điều kiện để khử nhiễu cho latent của mục tiêu, dựa trên điều kiện từ latent của ảnh. - vae (
AutoencoderKL) — Mô hình Variational Auto-Encoder (VAE) để mã hóa và giải mã hình ảnh cũng như các dự đoán sang và từ các biểu diễn ẩn (latent). - scheduler (
DDIMSchedulerhoặcLCMScheduler) — Một scheduler được sử dụng kết hợp vớiunetđể khử nhiễu các latents của ảnh đã mã hóa. - text_encoder (
CLIPTextModel) — Bộ mã hóa văn bản, dùng cho nhúng văn bản rỗng. - tokenizer (
CLIPTokenizer) — Tokenizer của CLIP. - prediction_type (
str, tùy chọn) — Loại dự đoán do mô hình thực hiện. - target_properties (
dict[str, Any], tùy chọn) — Các thuộc tính của các modalities được dự đoán, chẳng hạn nhưtarget_names, mộtlist[str]được dùng để xác định số lượng, thứ tự và tên của các modalities được dự đoán, cùng bất kỳ metadata nào khác có thể cần thiết để diễn giải các dự đoán. - default_denoising_steps (
int, tùy chọn) — Số lượng bước khuếch tán khử nhiễu tối thiểu cần thiết để tạo ra dự đoán có chất lượng hợp lý với mô hình đã cho. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõnum_inference_steps, giá trị mặc định sẽ được sử dụng. Điều này là cần thiết để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau tương thích với pipeline, chẳng hạn như những biến thể dựa trên lịch trình khử nhiễu rất ngắn (LCMScheduler) và những biến thể có lịch trình khuếch tán đầy đủ (DDIMScheduler). - default_processing_resolution (
int, tùy chọn) — Giá trị khuyến nghị cho tham sốprocessing_resolutioncủa pipeline. Giá trị này phải được đặt trong cấu hình mô hình. Khi pipeline được gọi mà không đặt rõprocessing_resolution, giá trị mặc định sẽ được sử dụng. Điều này là bắt buộc để đảm bảo kết quả hợp lý với các biến thể mô hình khác nhau được huấn luyện với các giá trị độ phân xử lý tối ưu khác nhau.
Pipeline cho Phân tách Ảnh Nội tại (IID) sử dụng phương pháp Marigold: https://marigoldcomputervision.github.io.
Mô hình này kế thừa từ DiffusionPipeline. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các pipeline (chẳng hạn như tải xuống hoặc lưu, chạy trên một thiết bị cụ thể, v.v.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Tham số
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: Một hoặc nhiều ảnh đầu vào được sử dụng làm đầu vào cho tác vụ phân rã nội tại. Đối với mảng và tensor, khoảng giá trị mong đợi nằm trong[0, 1]. Việc truyền một lô ảnh là khả thi bằng cách cung cấp một mảng hoặc tensor bốn chiều. Ngoài ra, có thể truyền một danh sách các ảnh dưới dạng mảng hoặc tensor hai hoặc ba chiều. Trong trường hợp sau, tất cả các phần tử trong danh sách phải có cùng chiều rộng và chiều cao. - num_inference_steps (
int, tùy chọn, mặc định làNone) — Số bước khuếch tán khử nhiễu trong quá trình suy luận. Giá trị mặc địnhNonesẽ dẫn đến việc tự động lựa chọn. - ensemble_size (
int, mặc định là1) — Số lượng dự đoán ensemble. Giá trị cao hơn sẽ mang lại cải thiện đáng đo được và suy giảm về mặt hình ảnh. - processing_resolution (
int, tùy chọn, mặc định làNone) — Độ phân xử lý hiệu dụng. Khi đặt thành0, sẽ khớp với chiều lớn hơn của ảnh đầu vào. Điều này tạo ra các dự đoán sắc nét hơn, nhưng cũng có thể dẫn đến mất ngữ cảnh toàn cục. Giá trị mặc địnhNonesẽ được giải quyết thành giá trị tối ưu từ cấu hình mô hình. - match_input_resolution (
bool, tùy chọn, mặc định làTrue) — Khi được bật, dự đoán đầu ra sẽ được thay đổi kích thước để khớp với kích thước đầu vào. Khi bị tắt, cạnh dài hơn của đầu ra sẽ bằng vớiprocessing_resolution. - resample_method_input (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước ảnh đầu vào thànhprocessing_resolution. Các giá trị được chấp nhận là:"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - resample_method_output (
str, tùy chọn, mặc định là"bilinear") — Phương pháp lấy mẫu lại được sử dụng để thay đổi kích thước các dự đoán đầu ra cho khớp với độ phân giải đầu vào. Các giá trị được chấp nhận là"nearest","nearest-exact","bilinear","bicubic"hoặc"area". - batch_size (
int, tùy chọn, mặc định là1) — Kích thước lô; chỉ có ý nghĩa khi thiết lậpensemble_sizehoặc truyền vào một tensor chứa các hình ảnh. - ensembling_kwargs (
dict, tuỳ chọn, mặc định làNone) — Từ điển bổ sung chứa các đối số để kiểm soát ensembling chính xác. Các tùy chọn sau có sẵn:- reduction (
str, tùy chọn, mặc định là"median"): Xác định hàm ensembling được áp dụng tại mỗi vị trí pixel, có thể là"median"hoặc"mean".
- reduction (
- latents (
torch.Tensor, tùy chọn, mặc định làNone) — Các tensor nhiễu tiềm ẩn để thay thế cho việc khởi tạo ngẫu nhiên. Chúng có thể được lấy từ đầu ra của lần gọi hàm trước đó. - generator (
torch.Generator, hoặclist[torch.Generator], tuỳ chọn, mặc định làNone) — Đối tượng bộ sinh số ngẫu nhiên để đảm bảo khả năng tái lập. - output_type (
str, tùy chọn, mặc định là"np") — Định dạng ưu tiên cho trườngpredictioncủa kết quả đầu ra và trườnguncertaintytùy chọn. Các giá trị được chấp nhận là:"np"(mảng numpy) hoặc"pt"(tensor torch). - output_uncertainty (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnguncertaintycủa kết xuất sẽ chứa bản đồ bất định dự đoán, với điều kiện tham sốensemble_sizeđược đặt thành một giá trị lớn hơn 2. - output_latent (
bool, tùy chọn, mặc định làFalse) — Khi được bật, trườnglatentcủa đầu ra sẽ chứa các mã latent tương ứng với các dự đoán trong ensemble. Các mã này có thể được lưu lại, chỉnh sửa và sử dụng cho các lần gọi tiếp theo với tham sốlatents. - return_dict (
bool, tùy chọn, mặc định làTrue) — Có nên trả về một MarigoldIntrinsicsOutput thay vì một tuple thông thường hay không.
Trả về
MarigoldIntrinsicsOutput hoặc tuple
Nếu return_dict là True, MarigoldIntrinsicsOutput sẽ được trả về, ngược lại một tuple sẽ được trả về trong đó phần tử đầu tiên là dự đoán, phần tử thứ hai là độ bất định (hoặc None), và phần tử thứ ba là latent (hoặc None).
Hàm được gọi khi gọi pipeline.
Ví dụ:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")class diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Tham số
- prediction (
np.ndarray,torch.Tensor) — Các thuộc tính nội tại của ảnh dự đoán với giá trị trong khoảng [0, 1]. Hình dạng là(numimages * numtargets) × 3 × height × widthđối vớitorch.Tensorhoặc(numimages * numtargets) × height × width × 3đối vớinp.ndarray, trong đónumtargetstương ứng với số lượng các chế độ mục tiêu được dự đoán của quá trình phân tách thuộc tính nội tại của ảnh. - uncertainty (
None,np.ndarray,torch.Tensor) — Bản đồ độ không chắc chắn được tính từ ensemble, với các giá trị trong khoảng [0, 1]. Hình dạng là(numimages * numtargets) × 3 × height × widthđối vớitorch.Tensorhoặc(numimages * numtargets) × height × width × 3đối vớinp.ndarray. - latent (
None,torch.Tensor) — Các đặc trưng ẩn tương ứng với các dự đoán, tương thích với tham sốlatentscủa pipeline. Hình dạng là(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Lớp đầu ra cho pipeline Phân tách Ảnh Nội tại Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dictcolor_map: str | dict[str, str] = 'binary' )
Tham số
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Phân tách ảnh nội tại. - target_properties (
dict[str, Any]) — Các thuộc tính phân rã. Các mục được mong đợi:target_names: list[str]và một từ điển có các khóaprediction_space: str,sub_target_names: list[str | Null](phải có 3 mục, null cho các chế độ thiếu),up_to_scale: bool, một cho mỗi target và sub-target. - color_map (
str | dict[str, str], optional, mặc định là"Spectral") — Color map được sử dụng để chuyển đổi các dự đoán đơn kênh thành các biểu diễn có màu. Khi một dictionary được truyền vào, mỗi modality có thể được tô màu bằng color map riêng của nó.
Trực quan hóa phân tách ảnh nội tại, chẳng hạn như các dự đoán của MarigoldIntrinsicsPipeline.
Trả về: list[dict[str, PIL.Image.Image]] với trực quan hóa phân tách ảnh nội tại.