
Diffusers documentation
Marigold Computer Vision
Marigold Computer Vision
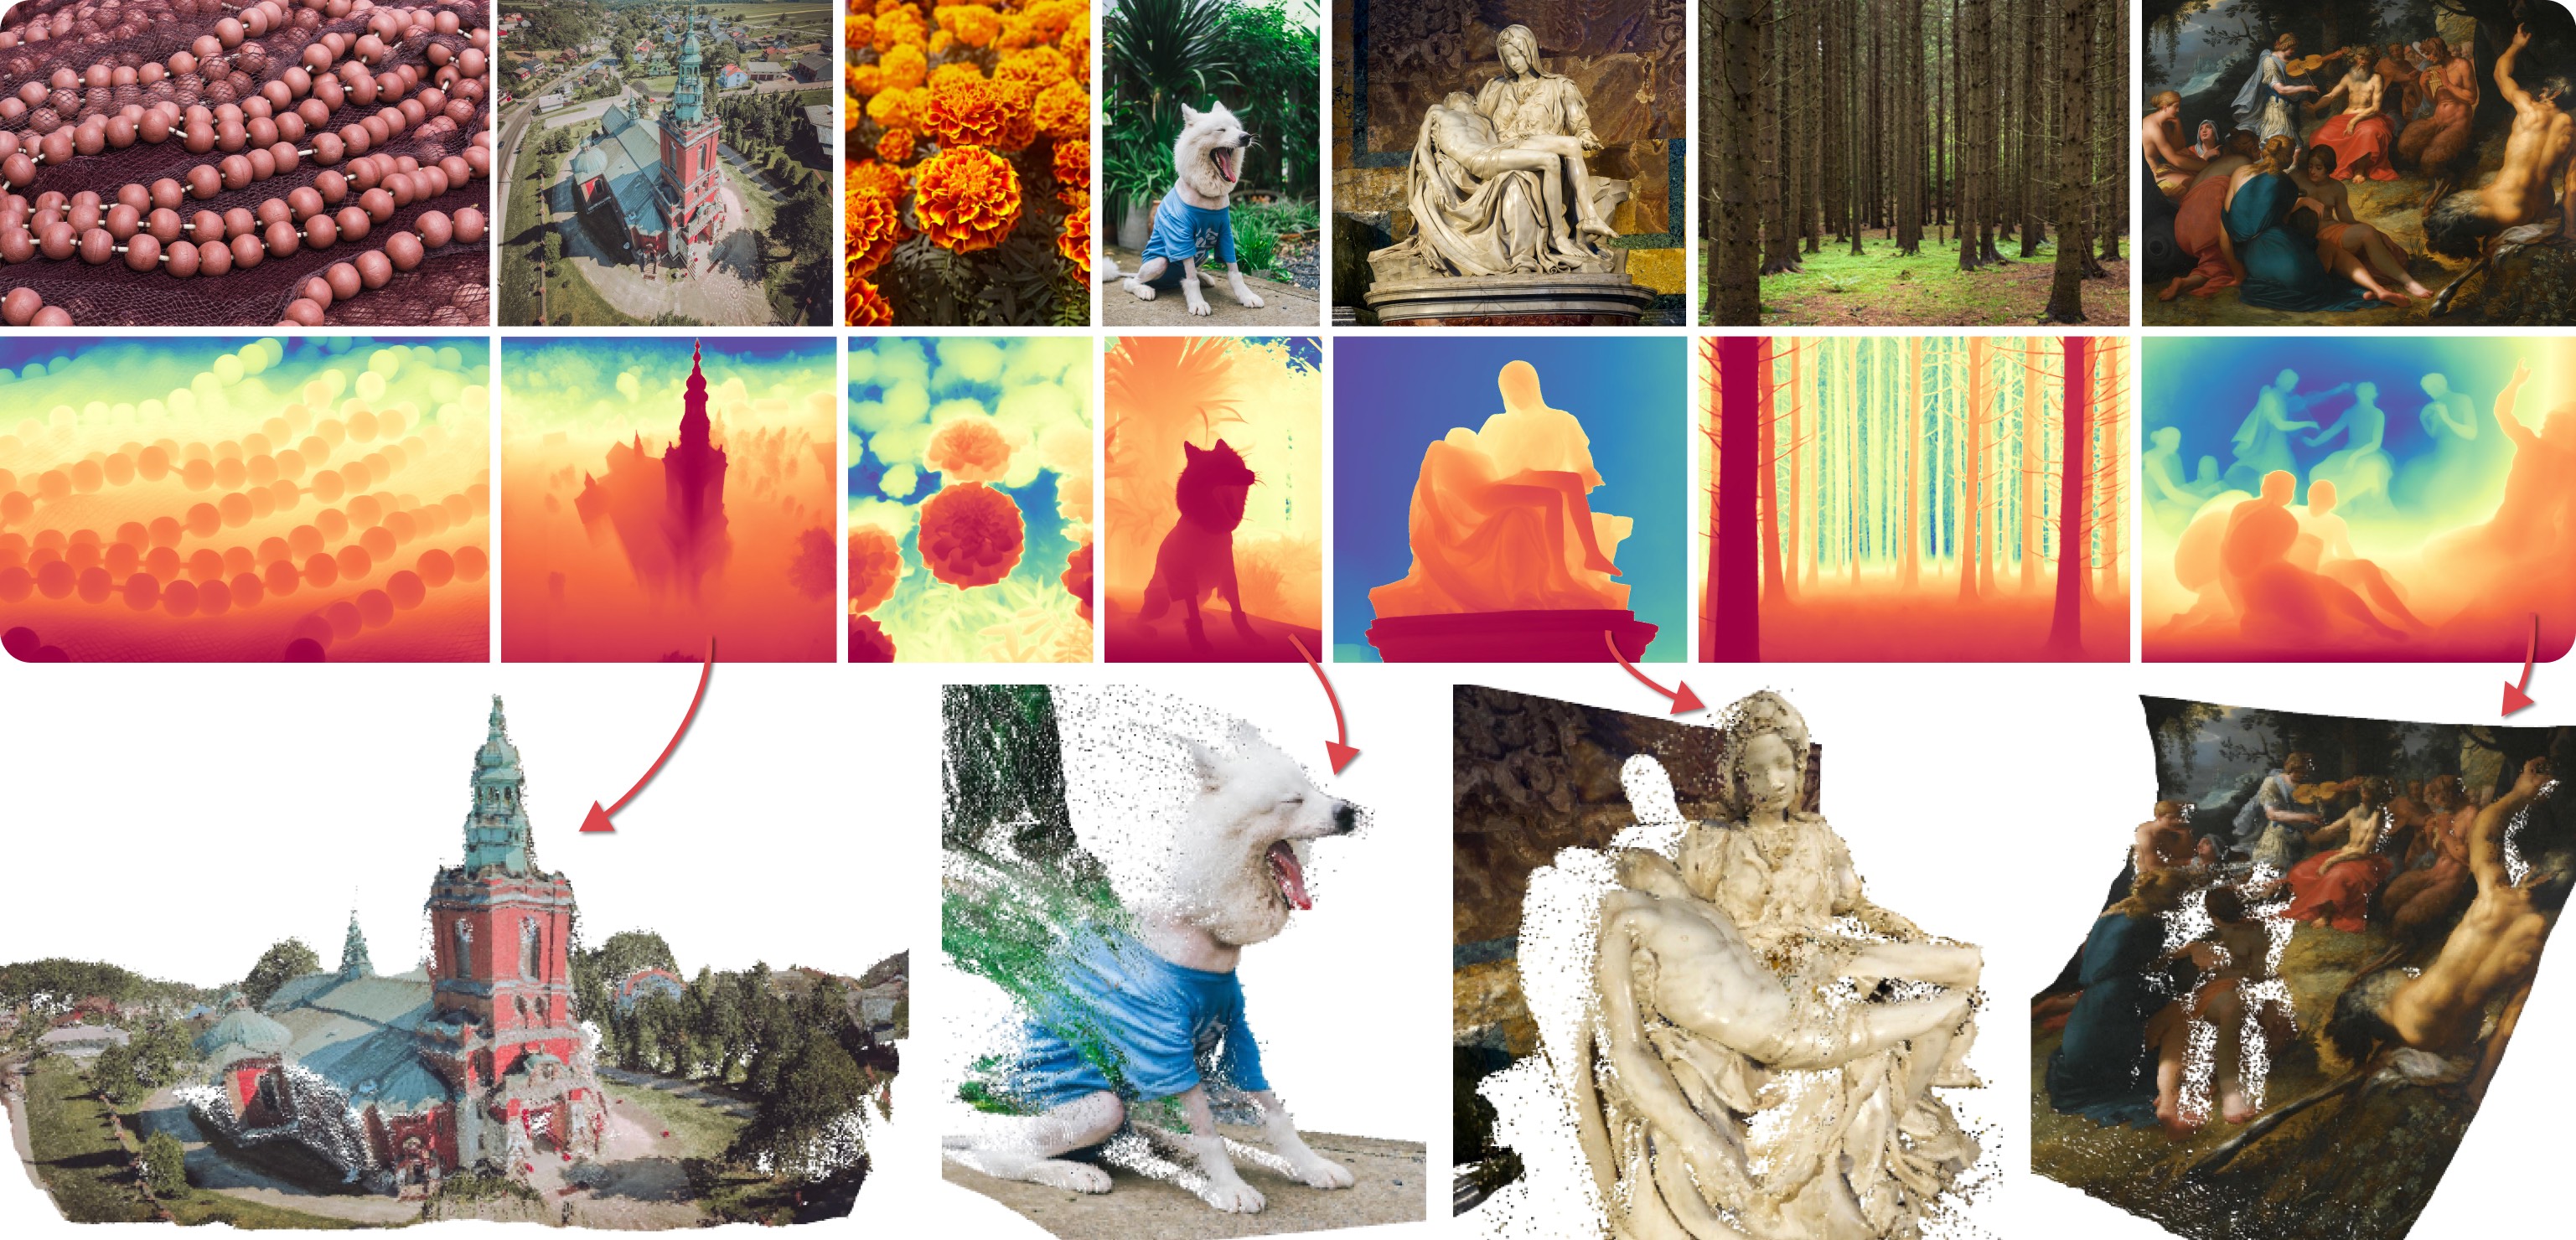
Marigold был предложен в статье Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, представленной на CVPR 2024 в формате Oral, авторами которой являются Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt и Konrad Schindler. Основная идея заключается в том, чтобы использовать генеративный априорный модель Text-to-Image Latent Diffusion Models (LDMs) для традиционных задач компьютерного зрения. Этот подход был исследован путем дообучения Stable Diffusion для задачи Monocular Depth Estimation, что продемонстрировано на иллюстрации выше.
Marigold был впоследствии расширен в продолжении, статье Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, авторами которой являются Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov и Konrad Schindler. В этой работе Marigold был расширен для поддержки новых модальностей, таких как Surface Normals и Intrinsic Image Decomposition (IID), был предложен протокол обучения для Latent Consistency Models (LCM) и продемонстрирована возможность обработки изображений в High-Resolution (HR) режиме.
Ранние модели Marigold (
v1-0и более ранние) были оптимизированы для достижения наилучших результатов при использовании не менее 10 шагов инференса. Модели LCM были разработаны позже, чтобы обеспечить высококачественный инференс всего за 1–4 шага. Модели Marigoldv1-1и более поздние используют планировщик DDIM для достижения оптимальных результатов всего за 1–4 шага.
Доступные конвейеры
Каждый конвейер предназначен для конкретной задачи компьютерного зрения: он обрабатывает входное RGB-изображение и формирует соответствующее предсказание. В настоящее время реализованы следующие задачи компьютерного зрения:
| Pipeline | Рекомендуемые контрольные точки моделей | Spaces (интерактивные приложения) | Предсказанные модальности |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Оценка глубины | Глубина, Разность |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Оценка нормалей поверхности | Нормали поверхности |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Разложение на собственные изображения | Альбедо, Материалы, Освещение |
Доступные контрольные точки
Все исходные контрольные точки доступны в организации PRS-ETH на Hugging Face. Они предназначены для использования с конвейерами diffusers и исходным кодом, который также можно использовать для обучения новых контрольных точек моделей. Ниже приведено краткое описание рекомендуемых контрольных точек, все из которых дают надежные результаты за 1–4 шага.
| Чекпоинт | Модальность | Комментарий |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Глубина | Предсказание глубины, инвариантное к аффинным преобразованиям, присваивает каждому пикселю значение от 0 (ближняя плоскость) до 1 (дальняя плоскость), причём обе плоскости определяются моделью во время инференса. |
| prs-eth/marigold-normals-v0-1 | Нормали | Предсказания нормалей поверхности представляют собой трёхмерные векторы единичной длины в системе координат камеры экранного пространства, со значениями в диапазоне от -1 до 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Встроенные функции | Декомпозиция InteriorVerse включает Albedo и два свойства материала BRDF: Roughness и Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Встроенные функции | Декомпозиция изображения в HyperSim состоит из альбедо $A$, диффузного затенения $S$ и недиффузного остатка $R$: $I = A*S+R$. |
Обязательно ознакомьтесь с руководством по планировщикам, чтобы узнать, как исследовать компромисс между скоростью и качеством планировщика, а также с разделом повторное использование компонентов в разных конвейерах, чтобы узнать, как эффективно загружать одни и те же компоненты в несколько конвейеров. Кроме того, чтобы узнать больше о снижении потребления памяти этим конвейером, обратитесь к разделу [«Снижение потребления памяти»] здесь.
Пайплайны Marigold были разработаны и протестированы с планировщиком, встроенным в контрольную точку модели. Оптимальное количество шагов инференса зависит от планировщика, и универсального значения, которое было бы лучшим во всех случаях, не существует. Чтобы учесть это, параметр
num_inference_stepsв методе__call__пайплайна по умолчанию принимает значениеNone(см. справочник API). Если значение не задано явно, оно наследуется из поляdefault_denoising_stepsв файле конфигурации контрольной точки (model_index.json). Это обеспечивает высокое качество предсказаний при вызове пайплайна только с аргументомimage.
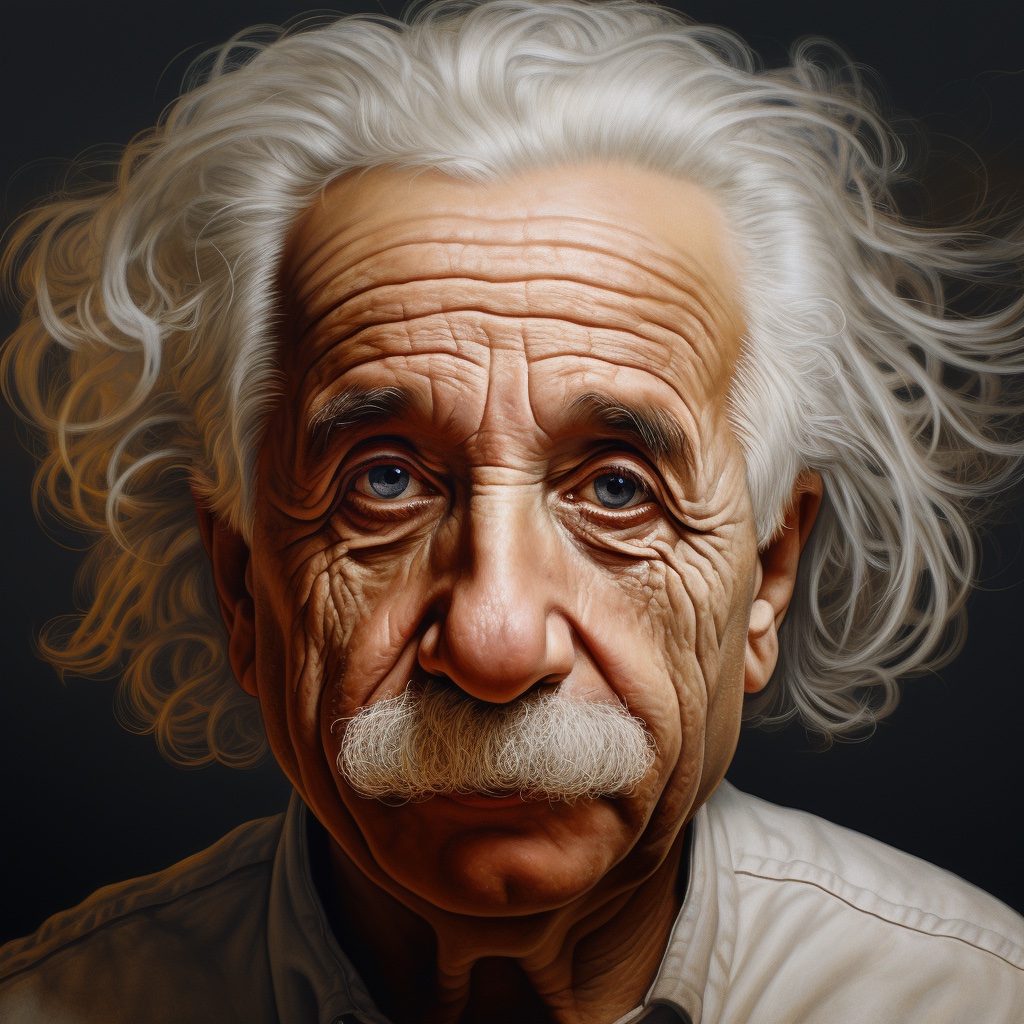
Приведённые ниже примеры в основном относятся к предсказанию глубины, однако их можно универсально применять к другим поддерживаемым модальностям. Мы демонстрируем предсказания, используя одно и то же входное изображение Альберта Эйнштейна, сгенерированное Midjourney. Это упрощает сравнение визуализаций предсказаний для различных модальностей и контрольных точек.
Предсказание глубины
Чтобы получить предсказание глубины, загрузите чекпоинт prs-eth/marigold-depth-v1-1 в MarigoldDepthPipeline,
пропустите изображение через пайплайн и сохраните предсказания:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
Функция visualize_depth() применяет одну из цветовых карт matplotlib (по умолчанию Spectral), чтобы отображать предсказанные значения пикселей из одноканального диапазона глубины [0, 1] в RGB-изображение.
При использовании цветовой карты Spectral пиксели с малой глубиной окрашиваются в красный цвет, а пиксели с большой глубиной — в синий.
Файл PNG с глубиной цвета 16 бит хранит значения одного канала, линейно отображённые из диапазона [0, 1] в диапазон [0, 65535].
Ниже приведены исходные и визуализированные предсказания. Тёмные и близкие области (усы) легче различить на
визуализации.


Оценка нормалей поверхности
Загрузите чекпоинт prs-eth/marigold-normals-v1-1 в MarigoldNormalsPipeline, пропустите изображение через пайплайн и сохраните предсказания:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
Функция visualize_normals() отображает трёхмерное предсказание со значениями пикселей в диапазоне [-1, 1] в RGB-изображение.
Функция визуализации поддерживает переворот осей нормалей поверхности, чтобы сделать визуализацию совместимой с другими
выборами системы координат.
Концептуально каждый пиксель окрашивается в соответствии с вектором нормали поверхности в системе координат, где ось X
направлена вправо, ось Y — вверх, а ось Z — на зрителя.
Ниже приведено визуализированное предсказание:

В этом примере на кончике носа почти наверняка есть точка на поверхности, нормаль к которой направлена прямо на наблюдателя, то есть её координаты равны [0, 0, 1].
Этот вектор отображается в RGB-значение [128, 128, 255], что соответствует фиолетово-синему цвету.
Аналогично, нормаль к поверхности на щеке в правой части изображения имеет большую компоненту X, что усиливает красный оттенок.
Точки на плечах, направленные вверх с большой компонентой Y, способствуют появлению зеленого цвета.
Разложение собственных изображений
Marigold предоставляет две модели для разложения изображений на внутренние компоненты (Intrinsic Image Decomposition, IID): «Appearance» и «Lighting». Каждая модель генерирует карты альбедо, полученные из аннотаций InteriorVerse и Hypersim соответственно.
- Модель «Appearance» также оценивает свойства материала: Roughness и Metallicity.
- Модель «Lighting» генерирует Diffuse Shading и Non-diffuse Residual.
Ниже приведён пример кода, сохраняющего предсказания, сделанные моделью «Appearance»:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Ещё один пример, демонстрирующий предсказания, сделанные моделью «Lighting»:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Обе модели используют один и тот же конвейер, поддерживая при этом различные типы декомпозиции.
Точная параметризация декомпозиции (например, sRGB или линейное пространство) хранится в словаре pipe.target_properties, который передается в функцию visualize_intrinsics().
Ниже приведены примеры, демонстрирующие результаты предсказанного разложения. Все модальности можно просмотреть в пространстве Intrinsic Image Decomposition.


Ускорение вывода
Приведённые выше примеры быстрого старта уже оптимизированы по качеству и скорости: они загружают контрольную точку, используют вариант весов и вычислений fp16 и выполняют стандартное количество (4) шагов диффузии для удаления шума.
Первый шаг к ускорению инференса, ценой снижения качества предсказаний, — это сократить количество шагов диффузии для удаления шума до минимума:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Благодаря этому изменению вызов pipe завершается за 280 мс на GPU RTX 3090.
Внутри входное изображение сначала кодируется с помощью кодировщика VAE Stable Diffusion, после чего выполняется один шаг денойзинга, выполняемый U-Net.
Наконец, предсказанное латентное представление декодируется декодером VAE в пиксельное пространство.
В такой конфигурации два из трёх вызовов модулей предназначены для преобразования между пиксельным и латентным пространствами LDM.
Поскольку латентное пространство Marigold совместимо со Stable Diffusion 2.0, инференс можно ускорить более чем в 3 раза,
сократив время вызова до 85 мс на RTX 3090, используя лёгкую замену SD VAE.
Обратите внимание, что использование лёгкого VAE может незначительно снизить визуальное качество предсказаний.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
До сих пор мы оптимизировали количество шагов диффузии и компоненты модели. Операции self-attention занимают значительную долю вычислений. Их ускорение можно достичь с помощью более эффективного attention-процессора:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Наконец, как предложено в разделе Оптимизации, включение torch.compile может дополнительно повысить производительность в зависимости от целевого оборудования.
Однаком компиляция приводит к значительным накладным расходам при первом вызове конвейера, что делает её полезной только в том случае, если один и тот же экземпляр конвейера вызывается многократно, например, внутри цикла.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Максимизация точности и ансамблирование
Пайплайны Marigold имеют встроенный механизм ансамблирования, объединяющий несколько предсказаний из разных случайных латентов.
Это грубый способ повышения точности предсказаний, использующий генеративную природу диффузии.
Путь ансамблирования активируется автоматически, когда аргумент ensemble_size установлен в значение, большее или равное 3.
При стремлении к максимальной точности имеет смысл одновременно настраивать num_inference_steps и ensemble_size.
Рекомендуемые значения различаются в зависимости от контрольных точек, но в первую очередь зависят от типа планировщика.
Эффект ансамблирования особенно хорошо виден на нормалях поверхности:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
Как видно, все области с мелкомасштабной структурой, например волосы, получили более консервативные и в среднем более точные предсказания. Такой результат лучше подходит для задач, чувствительных к точности, таких как 3D-реконструкция.
Покдровая обработка видео с временной согласованностью
В связи с генеративной природой Marigold каждое предсказание уникально и определяется случайным шумом, сэмплированным для латентной инициализации. Это становится очевидным недостатком по сравнению с традиционными сквозными сетями плотной регрессии, что проиллюстрировано в следующих видео:


Для решения этой проблемы можно передать аргумент latents в пайплайны, который определяет начальную точку диффузии.
Эмпирически мы установили, что выпуклая комбинация того же самого начального шума-латента и латента, соответствующего предсказанию предыдущего кадра, даёт достаточно плавные результаты, как реализовано в приведённом ниже фрагменте кода:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Здесь процесс диффузии начинается с заданного вычисленного латентного представления.
Пайплайн устанавливает output_latent=True, чтобы получить доступ к out.latent и вычислить его вклад в инициализацию латентного представления следующего кадра.
Теперь результат значительно более стабилен:

Marigold для ControlNet
Очень распространённое применение предсказания глубины с помощью диффузионных моделей — использование в связке с ControlNet. Чёткость карты глубины играет ключевую роль в получении высококачественных результатов от ControlNet. Как видно из приведённых выше сравнений с другими методами, Marigold отлично справляется с этой задачей. Ниже приведён фрагмент кода, демонстрирующий, как загрузить изображение, вычислить глубину и передать её в ControlNet в совместимом формате:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")


Количественная оценка
Для количественной оценки Marigold в стандартных рейтингах и бенчмарках (таких как NYU, KITTI и другие наборы данных)
следуйте протоколу оценки, описанному в статье: загрузите модель с полной точностью fp32 и используйте соответствующие значения
для num_inference_steps и ensemble_size.
При необходимости задайте seed для обеспечения воспроизводимости.
Максимальное значение batch_size обеспечит максимальную загрузку устройства.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Использование предиктивной неопределённости
Механизм ансамблирования, встроенный в конвейеры Marigold, объединяет несколько предсказаний, полученных из разных случайных латентов.
Как побочный эффект, его можно использовать для количественной оценки эпистемической (модельной) неопределённости: достаточно указать ensemble_size больше или равно 3 и установить output_uncertainty=True.
Полученная неопределённость будет доступна в поле uncertainty результата.
Её можно визуализировать следующим образом:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


Интерпретация неопределённости проста: более высокие значения (белый цвет) соответствуют пикселям, на которых модели трудно делать согласованные предсказания.
- Модель глубины демонстрирует наибольшую неопределенность вблизи разрывов, где глубина объектов меняется резко.
- Модель нормалей поверхности наименее уверенна в детализированных структурах, таких как волосы, и в тёмных областях, например в зоне воротника.
- Неопределённость альбедо представлена в виде RGB-изображения, поскольку она фиксирует неопределённость независимо для каждого цветового канала, в отличие от глубины и нормалей поверхности. Она также выше в затенённых областях и в местах разрывов.
API предсказания глубины Marigold
класс diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Параметры
- unet (
UNet2DConditionModel) — Условный U-Net для удаления шума из латентного представления глубины, с условием на латентное представление изображения. - vae (
AutoencoderKL) — Модель вариационного автоэнкодера (VAE) для кодирования и декодирования изображений и предсказаний в латентные представления и обратно. - scheduler (
DDIMSchedulerилиLCMScheduler) — планировщик, используемый в связке сunetдля удаления шума из закодированных латентов изображения. - text_encoder (
CLIPTextModel) — Текстовый энкодер для пустого текстового эмбеддинга. - tokenizer (
CLIPTokenizer) — токенизатор CLIP. - prediction_type (
str, необязательный) — Тип предсказаний, выполняемых моделью. - scale_invariant (
bool, необязательный) — Свойство модели, указывающее, являются ли предсказанные карты глубины инвариантными к масштабу. Это значение должно быть задано в конфигурации модели. При использовании вместе с флагомshift_invariant=Trueмодель также называется «аффинно-инвариантной». Примечание: переопределение этого значения не поддерживается. - shift_invariant (
bool, необязательный) — Свойство модели, указывающее, являются ли предсказанные карты глубины инвариантными к сдвигу. Это значение должно быть задано в конфигурации модели. При использовании вместе с флагомscale_invariant=Trueмодель также называется «инвариантной к аффинным преобразованиям». Примечание: переопределение этого значения не поддерживается. - default_denoising_steps (
int, необязательный) — Минимальное количество шагов диффузии для денойзинга, необходимое для получения предсказания приемлемого качества с данной моделью. Это значение должно быть задано в конфигурации модели. Если пайплайн вызывается без явного указанияnum_inference_steps, используется значение по умолчанию. Это требуется для обеспечения разумных результатов с различными вариантами моделей, совместимыми с пайплайном, в том числе с теми, которые используют очень короткие расписания денойзинга (LCMScheduler), и с теми, что имеют полные расписания диффузии (DDIMScheduler). - default_processing_resolution (
int, необязательный) — Рекомендуемое значение параметраprocessing_resolutionконвейера. Это значение должно быть указано в конфигурации модели. Если конвейер вызывается без явного указанияprocessing_resolution, используется значение по умолчанию. Это необходимо для обеспечения разумных результатов при работе с различными вариантами моделей, обученными с разными оптимальными значениями разрешения обработки.
Пайплайн для оценки монокулярной глубины с использованием метода Marigold: https://marigoldmonodepth.github.io.
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Параметры
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: входное изображение или изображения, используемые как вход для задачи оценки глубины. Для массивов и тензоров ожидаемый диапазон значений — от[0, 1]. Передача батча изображений возможна путём предоставления четырёхмерного массива или тензора. Кроме того, можно передать список изображений в виде двумерных или трёхмерных массивов или тензоров. В последнем случае все элементы списка должны иметь одинаковую ширину и высоту. - num_inference_steps (
int, необязательный, по умолчаниюNone) — Количество шагов диффузии для удаления шума при инференсе. Значение по умолчаниюNoneприводит к автоматическому выбору. - ensemble_size (
int, по умолчанию1) — Количество предсказаний ансамбля. Большие значения приводят к измеримому улучшению качества и визуальному ухудшению. - processing_resolution (
int, необязательный, по умолчаниюNone) — Эффективное разрешение обработки. Если установлено в0, совпадает с большей стороной входного изображения. Это даёт более чёткие предсказания, но может привести к потере глобального контекста. Значение по умолчаниюNoneразрешается в оптимальное значение из конфигурации модели. - match_input_resolution (
bool, необязательный, по умолчаниюTrue) — Если включено, размер выходного предсказания приводится к размерам входных данных. Если выключено, длина большей стороны выхода будет равнаprocessing_resolution. - resample_method_input (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера входных изображений доprocessing_resolution. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - resample_method_output (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера выходных предсказаний в соответствии с разрешением входных данных. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - batch_size (
int, необязательный, по умолчанию1) — Размер пакета; имеет значение только при установкеensemble_sizeили передаче тензора изображений. - ensembling_kwargs (
dict, необязательный, по умолчаниюNone) — Дополнительный словарь с аргументами для точного управления ансамблированием. Доступны следующие параметры:- reduction (
str, необязательный, по умолчанию"median"): определяет функцию ансамблирования, применяемую в каждой пиксельной позиции; может принимать значение"median"или"mean". - regularizer_strength (
float, необязательный, по умолчанию0.02): Сила регуляризатора, который притягивает выровненные предсказания к единичному диапазону от 0 до 1. - max_iter (
int, необязательный, по умолчанию2): Максимальное количество шагов решателя выравнивания. См. функциюscipy.optimize.minimize, аргументoptions. - tol (
float, необязательный, по умолчанию1e-3): допустимая погрешность решателя выравнивания. Решатель останавливается, когда достигается заданная погрешность. - max_res (
int, необязательный, по умолчаниюNone): разрешение, при котором выполняется выравнивание;Noneсоответствуетprocessing_resolution.
- reduction (
- latents (
torch.Tensorилиlist[torch.Tensor], необязательный, по умолчаниюNone) — Тензоры латентного шума для замены случайной инициализации. Их можно взять из результата предыдущего вызова функции. - generator (
torch.Generatorилиlist[torch.Generator], необязательный, по умолчаниюNone) — Объект генератора случайных чисел для обеспечения воспроизводимости. - output_type (
str, необязательный, по умолчанию"np") — предпочтительный формат полейpredictionи необязательногоuncertaintyв выводе. Допустимые значения:"np"(массив numpy) или"pt"(тензор torch). - output_uncertainty (
bool, необязательный, по умолчаниюFalse) — Если включено, полеuncertaintyв выводе содержит карту предиктивной неопределённости, при условии что аргументensemble_sizeустановлен в значение, превышающее 2. - output_latent (
bool, необязательный, по умолчаниюFalse) — Если включено, полеlatentв выводе содержит латентные коды, соответствующие предсказаниям внутри ансамбля. Эти коды можно сохранить, изменить и использовать для последующих вызовов с аргументомlatents. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать MarigoldDepthOutput вместо обычного кортежа.
Возвращает
MarigoldDepthOutput или tuple
Если return_dict равно True, возвращается MarigoldDepthOutput, в противном случае возвращается tuple, где первый элемент — это предсказание, второй — неопределённость (или None), а третий — латентное представление (или None).
Функция, вызываемая при обращении к конвейеру.
Примеры:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
класс diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Параметры
- prediction (
np.ndarray,torch.Tensor) — Прогнозируемые карты глубины со значениями в диапазоне [0, 1]. Форма —numimages × 1 × height × widthдляtorch.Tensorилиnumimages × height × width × 1дляnp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Карты неопределённости, вычисленные на основе ансамбля, со значениями в диапазоне [0, 1]. Форма —numimages × 1 × height × widthдляtorch.Tensorилиnumimages × height × width × 1дляnp.ndarray. - latent (
None,torch.Tensor) — Латентные признаки, соответствующие предсказаниям, совместимые с аргументомlatentsконвейера. Форма:numimages * numensemble × 4 × latentheight × latentwidth.
Класс вывода для конвейера однокамерного предсказания глубины Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Параметры
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): Карты глубины. - val_min (
float, необязательный, по умолчанию0.0) — минимальное значение визуализируемого диапазона глубины. - val_max (
float, необязательный, по умолчанию1.0) — Максимальное значение визуализируемого диапазона глубины. - color_map (
str, необязательный, по умолчанию"Spectral") — Карта цветов, используемая для преобразования одноканального предсказания глубины в цветное представление.
Визуализирует карты глубины, например, предсказания MarigoldDepthPipeline.
Возвращает: list[PIL.Image.Image] с визуализацией карт глубины.
API оценки нормалей Marigold
класс diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Параметры
- unet (
UNet2DConditionModel) — Условный U-Net для удаления шума из латентного представления нормалей, с условием на латентное представление изображения. - vae (
AutoencoderKL) — Модель вариационного автоэнкодера (VAE) для кодирования и декодирования изображений и предсказаний в латентные представления и обратно. - scheduler (
DDIMSchedulerилиLCMScheduler) — планировщик, используемый в связке сunetдля удаления шума из закодированных латентов изображения. - text_encoder (
CLIPTextModel) — Текстовый энкодер для пустого текстового эмбеддинга. - tokenizer (
CLIPTokenizer) — токенизатор CLIP. - prediction_type (
str, необязательный) — Тип предсказаний, выполняемых моделью. - use_full_z_range (
bool, необязательный) — Указывает, используют ли нормали, предсказываемые этой моделью, полный диапазон измерения Z или только его положительную половину. - default_denoising_steps (
int, необязательный) — Минимальное количество шагов диффузии для денойзинга, необходимое для получения предсказания приемлемого качества с данной моделью. Это значение должно быть задано в конфигурации модели. Если пайплайн вызывается без явного указанияnum_inference_steps, используется значение по умолчанию. Это требуется для обеспечения разумных результатов с различными вариантами моделей, совместимыми с пайплайном, в том числе с теми, которые используют очень короткие расписания денойзинга (LCMScheduler), и с теми, что имеют полные расписания диффузии (DDIMScheduler). - default_processing_resolution (
int, необязательный) — Рекомендуемое значение параметраprocessing_resolutionконвейера. Это значение должно быть указано в конфигурации модели. Если конвейер вызывается без явного указанияprocessing_resolution, используется значение по умолчанию. Это необходимо для обеспечения разумных результатов при работе с различными вариантами моделей, обученными с разными оптимальными значениями разрешения обработки.
Пайплайн для оценки монокулярных нормалей с использованием метода Marigold: https://marigoldmonodepth.github.io.
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Параметры
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: входное изображение или изображения, используемые для задачи оценки нормалей. Для массивов и тензоров ожидаемый диапазон значений — от[0, 1]. Передача батча изображений возможна путём предоставления четырёхмерного массива или тензора. Кроме того, можно передать список изображений в виде двумерных или трёхмерных массивов или тензоров. В последнем случае все элементы списка должны иметь одинаковую ширину и высоту. - num_inference_steps (
int, необязательный, по умолчаниюNone) — Количество шагов диффузии для удаления шума при инференсе. Значение по умолчаниюNoneприводит к автоматическому выбору. - ensemble_size (
int, по умолчанию1) — Количество предсказаний ансамбля. Большие значения приводят к измеримому улучшению качества и визуальному ухудшению. - processing_resolution (
int, необязательный, по умолчаниюNone) — Эффективное разрешение обработки. Если установлено в0, совпадает с большей стороной входного изображения. Это даёт более чёткие предсказания, но может привести к потере глобального контекста. Значение по умолчаниюNoneразрешается в оптимальное значение из конфигурации модели. - match_input_resolution (
bool, необязательный, по умолчаниюTrue) — Если включено, размер выходного предсказания приводится к размерам входных данных. Если выключено, длина большей стороны выхода будет равнаprocessing_resolution. - resample_method_input (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера входных изображений доprocessing_resolution. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - resample_method_output (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера выходных предсказаний в соответствии с разрешением входных данных. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - batch_size (
int, необязательный, по умолчанию1) — Размер пакета; имеет значение только при установкеensemble_sizeили передаче тензора изображений. - ensembling_kwargs (
dict, необязательный, по умолчаниюNone) — Дополнительный словарь с аргументами для точного управления ансамблированием. Доступны следующие параметры:- reduction (
str, необязательный, по умолчанию"closest"): определяет функцию ансамблирования, применяемую в каждой пиксельной позиции; может принимать значение"closest"или"mean".
- reduction (
- latents (
torch.Tensor, необязательный, по умолчаниюNone) — Тензоры латентного шума для замены случайной инициализации. Их можно взять из результата предыдущего вызова функции. - generator (
torch.Generatorилиlist[torch.Generator], необязательный, по умолчаниюNone) — Объект генератора случайных чисел для обеспечения воспроизводимости. - output_type (
str, необязательный, по умолчанию"np") — предпочтительный формат полейpredictionи необязательногоuncertaintyв выводе. Допустимые значения:"np"(массив numpy) или"pt"(тензор torch). - output_uncertainty (
bool, необязательный, по умолчаниюFalse) — Если включено, полеuncertaintyв выводе содержит карту предиктивной неопределённости, при условии что аргументensemble_sizeустановлен в значение, превышающее 2. - output_latent (
bool, необязательный, по умолчаниюFalse) — Если включено, полеlatentв выводе содержит латентные коды, соответствующие предсказаниям внутри ансамбля. Эти коды можно сохранить, изменить и использовать для последующих вызовов с аргументомlatents. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать MarigoldNormalsOutput вместо обычного кортежа.
Возвращает
MarigoldNormalsOutput или tuple
Если return_dict равно True, возвращается MarigoldNormalsOutput, иначе возвращается tuple, где первый элемент — это предсказание, второй — неопределённость (или None), а третий — латентное представление (или None).
Функция, вызываемая при обращении к конвейеру.
Примеры:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
класс diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Параметры
- prediction (
np.ndarray,torch.Tensor) — Предсказанные нормали со значениями в диапазоне [-1, 1]. Форма —numimages × 3 × height × widthдляtorch.Tensorилиnumimages × height × width × 3дляnp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Карты неопределённости, вычисленные на основе ансамбля, со значениями в диапазоне [0, 1]. Форма —numimages × 1 × height × widthдляtorch.Tensorилиnumimages × height × width × 1дляnp.ndarray. - latent (
None,torch.Tensor) — Латентные признаки, соответствующие предсказаниям, совместимые с аргументомlatentsконвейера. Форма:numimages * numensemble × 4 × latentheight × latentwidth.
Класс вывода для конвейера предсказания монокулярных нормалей Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Параметры
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Нормали поверхности. - flip_x (
bool, необязательный, по умолчаниюFalse) — Инвертирует ось X в системе координат нормалей. Направление по умолчанию — вправо. - flip_y (
bool, необязательный, по умолчаниюFalse) — Разворачивает ось Y системы координат нормалей. Направление по умолчанию — вверх. - flip_z (
bool, необязательный, по умолчаниюFalse) — Инвертирует ось Z системы координат нормалей. Направление по умолчанию — в сторону наблюдателя.
Визуализирует нормали поверхности, например, предсказания MarigoldNormalsPipeline.
Возвращает: list[PIL.Image.Image] с визуализацией нормалей поверхности.
API Marigold Intrinsic Image Decomposition
класс diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Параметры
- unet (
UNet2DConditionModel) — Условный U-Net для удаления шума из латентного представления целевого изображения, с условием на латентное представление исходного изображения. - vae (
AutoencoderKL) — Модель вариационного автоэнкодера (VAE) для кодирования и декодирования изображений и предсказаний в латентные представления и обратно. - scheduler (
DDIMSchedulerилиLCMScheduler) — планировщик, используемый в связке сunetдля удаления шума из закодированных латентов изображения. - text_encoder (
CLIPTextModel) — Текстовый энкодер для пустого текстового эмбеддинга. - tokenizer (
CLIPTokenizer) — токенизатор CLIP. - prediction_type (
str, необязательный) — Тип предсказаний, выполняемых моделью. - target_properties (
dict[str, Any], необязательный) — Свойства предсказанных модальностей, такие какtarget_names,list[str], используемый для определения количества, порядка и имён предсказанных модальностей, а также любые другие метаданные, которые могут потребоваться для интерпретации предсказаний. - default_denoising_steps (
int, необязательный) — Минимальное количество шагов диффузии для денойзинга, необходимое для получения предсказания приемлемого качества с данной моделью. Это значение должно быть задано в конфигурации модели. Если пайплайн вызывается без явного указанияnum_inference_steps, используется значение по умолчанию. Это требуется для обеспечения разумных результатов с различными вариантами моделей, совместимыми с пайплайном, в том числе с теми, которые используют очень короткие расписания денойзинга (LCMScheduler), и с теми, что имеют полные расписания диффузии (DDIMScheduler). - default_processing_resolution (
int, необязательный) — Рекомендуемое значение параметраprocessing_resolutionконвейера. Это значение должно быть указано в конфигурации модели. Если конвейер вызывается без явного указанияprocessing_resolution, используется значение по умолчанию. Это необходимо для обеспечения разумных результатов при работе с различными вариантами моделей, обученными с разными оптимальными значениями разрешения обработки.
Пайплайн для разложения на собственные изображения (IID) с использованием метода Marigold: https://marigoldcomputervision.github.io.
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Параметры
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: входное изображение или изображения, используемые как вход для задачи внутренней декомпозиции. Для массивов и тензоров ожидаемый диапазон значений составляет[0, 1]. Передача батча изображений возможна путём предоставления четырёхмерного массива или тензора. Кроме того, можно передать список изображений в виде двумерных или трёхмерных массивов или тензоров. В последнем случае все элементы списка должны иметь одинаковую ширину и высоту. - num_inference_steps (
int, необязательный, по умолчаниюNone) — Количество шагов диффузии для удаления шума при инференсе. Значение по умолчаниюNoneприводит к автоматическому выбору. - ensemble_size (
int, по умолчанию1) — Количество предсказаний ансамбля. Большие значения приводят к измеримому улучшению качества и визуальному ухудшению. - processing_resolution (
int, необязательный, по умолчаниюNone) — Эффективное разрешение обработки. Если установлено в0, совпадает с большей стороной входного изображения. Это даёт более чёткие предсказания, но может привести к потере глобального контекста. Значение по умолчаниюNoneразрешается в оптимальное значение из конфигурации модели. - match_input_resolution (
bool, необязательный, по умолчаниюTrue) — Если включено, размер выходного предсказания приводится к размерам входных данных. Если выключено, длина большей стороны выхода будет равнаprocessing_resolution. - resample_method_input (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера входных изображений доprocessing_resolution. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - resample_method_output (
str, необязательный, по умолчанию"bilinear") — Метод ресемплинга, используемый для изменения размера выходных предсказаний в соответствии с разрешением входных данных. Допустимые значения:"nearest","nearest-exact","bilinear","bicubic"или"area". - batch_size (
int, необязательный, по умолчанию1) — Размер пакета; имеет значение только при установкеensemble_sizeили передаче тензора изображений. - ensembling_kwargs (
dict, необязательный, по умолчаниюNone) — Дополнительный словарь с аргументами для точного управления ансамблированием. Доступны следующие параметры:- reduction (
str, необязательный, по умолчанию"median"): определяет функцию ансамблирования, применяемую в каждой пиксельной позиции; может принимать значение"median"или"mean".
- reduction (
- latents (
torch.Tensor, необязательный, по умолчаниюNone) — Тензоры латентного шума для замены случайной инициализации. Их можно взять из результата предыдущего вызова функции. - generator (
torch.Generatorилиlist[torch.Generator], необязательный, по умолчаниюNone) — Объект генератора случайных чисел для обеспечения воспроизводимости. - output_type (
str, необязательный, по умолчанию"np") — предпочтительный формат полейpredictionи необязательногоuncertaintyв выводе. Допустимые значения:"np"(массив numpy) или"pt"(тензор torch). - output_uncertainty (
bool, необязательный, по умолчаниюFalse) — Если включено, полеuncertaintyв выводе содержит карту предиктивной неопределённости, при условии что аргументensemble_sizeустановлен в значение, превышающее 2. - output_latent (
bool, необязательный, по умолчаниюFalse) — Если включено, полеlatentв выводе содержит латентные коды, соответствующие предсказаниям внутри ансамбля. Эти коды можно сохранить, изменить и использовать для последующих вызовов с аргументомlatents. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать MarigoldIntrinsicsOutput вместо обычного кортежа.
Возвращает
MarigoldIntrinsicsOutput или tuple
Если return_dict равно True, возвращается MarigoldIntrinsicsOutput, иначе возвращается tuple, где первый элемент — это предсказание, второй — неопределённость (или None), а третий — латентное представление (или None).
Функция, вызываемая при обращении к конвейеру.
Примеры:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")класс diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Параметры
- prediction (
np.ndarray,torch.Tensor) — Предсказанные внутренние параметры изображения со значениями в диапазоне [0, 1]. Форма —(numimages * numtargets) × 3 × height × widthдляtorch.Tensorили(numimages * numtargets) × height × width × 3дляnp.ndarray, гдеnumtargetsсоответствует количеству предсказанных целевых модальностей декомпозиции внутреннего изображения. - uncertainty (
None,np.ndarray,torch.Tensor) — Карты неопределённости, вычисленные на основе ансамбля, со значениями в диапазоне [0, 1]. Форма —(numimages * numtargets) × 3 × height × widthдляtorch.Tensorили(numimages * numtargets) × height × width × 3дляnp.ndarray. - latent (
None,torch.Tensor) — Латентные признаки, соответствующие предсказаниям, совместимые с аргументомlatentsконвейера. Форма:(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Класс вывода для конвейера Marigold Intrinsic Image Decomposition.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dictcolor_map: str | dict[str, str] = 'binary' )
Параметры
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Разложение на собственные изображения. - target_properties (
dict[str, Any]) — Свойства декомпозиции. Ожидаемые записи:target_names: list[str]и словарь с ключамиprediction_space: str,sub_target_names: list[str | Null](должно содержать 3 записи, null для отсутствующих модальностей),up_to_scale: bool, по одному для каждой цели и подцели. - color_map (
str | dict[str, str], необязательный, по умолчанию"Spectral") — Карта цветов, используемая для преобразования одноканальных предсказаний в цветные представления. Если передается словарь, каждая модальность может быть окрашена с помощью собственной карты цветов.
Визуализирует разложение на внутренние изображения, например, предсказания MarigoldIntrinsicsPipeline.
Возвращает: list[dict[str, PIL.Image.Image]] с визуализацией разложения на внутренние изображения.