
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1은 Arseniy Shakhmatov, Anton Razzhigaev, Aleksandr Nikolich, Vladimir Arkhipkin, Igor Pavlov, Andrey Kuznetsov, Denis Dimitrov에 의해 개발되었습니다.
GitHub 페이지의 설명은 다음과 같습니다:
Kandinsky 2.1은 Dall-E 2와 Latent diffusion에서 최적의 관행을 계승하면서 몇 가지 새로운 아이디어를 도입했습니다. 텍스트 및 이미지 인코더로는 CLIP 모델을 사용하며, CLIP 모달리티의 잠재 공간 사이에 확산 이미지 사전(매핑)을 적용합니다. 이 접근 방식은 모델의 시각적 성능을 향상시키고, 이미지 블렌딩 및 텍스트 기반 이미지 조작 분야에서 새로운 가능성을 열어줍니다.
원본 코드베이스는 ai-forever/Kandinsky-2에서 찾을 수 있습니다.
Hub의 Kandinsky Community 조직에서 텍스트-이미지, 이미지-이미지, 인페인팅과 같은 작업에 대한 공식 모델 체크포인트를 확인해 보세요.
Scheduler의 가이드를 확인하여 스케줄러의 속도와 품질 사이의 트레이드오프를 탐색하는 방법을 배우고, 파이프라인 간 구성 요소 재사용 섹션을 확인하여 동일한 구성 요소를 여러 파이프라인에 효율적으로 로드하는 방법을 배워보세요.
다음 라이브러리가 설치되어 있는지 확인하세요.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Kandinsky 2.1과 2.2의 사용법은 매우 유사합니다! 유일한 차이점은 Kandinsky 2.2가 latents를 디코딩할 때
prompt를 입력으로 받지 않는다는 것입니다. 대신 Kandinsky 2.2는 디코딩 시image_embeds만 받습니다.
Kandinsky 3는 더 간결한 아키텍처를 갖추고 있으며 사전 모델이 필요하지 않습니다. 이는 Stable Diffusion XL와 같은 다른 diffusion 모델과 동일한 방식으로 사용할 수 있음을 의미합니다.
텍스트-이미지
Kandinsky 모델을 어떤 작업에 사용하든, 프롬프트를 인코딩하고 이미지 임베딩을 생성하기 위해 prior 파이프라인을 설정하는 것부터 시작합니다. prior 파이프라인은 또한 negative prompt ""에 해당하는 negative_image_embeds를 생성합니다. 더 나은 결과를 얻으려면 prior 파이프라인에 실제 negative_prompt를 전달할 수 있지만, 이렇게 하면 prior 파이프라인의 실효 배치 크기가 2배로 증가합니다.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
이제 모든 프롬프트와 임베딩을 KandinskyPipeline에 전달하여 이미지를 생성합니다:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()image_embeds와 negative_image_embeds를 KandinskyV22Pipeline에 전달하여 이미지를 생성합니다:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3는 이전 모델이 필요하지 않으므로 Kandinsky3Pipeline을 직접 로드하고 프롬프트를 전달하여 이미지를 생성할 수 있습니다:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers는 KandinskyCombinedPipeline와 KandinskyV22CombinedPipeline을 통해 end-to-end API를 제공하므로, prior와 text-to-image 파이프라인을 별도로 로드할 필요가 없습니다. 통합 파이프라인은 prior 모델과 디코더를 자동으로 로드합니다. 원할 경우 prior_guidance_scale와 prior_num_inference_steps 매개변수를 사용하여 prior 파이프라인에 다른 값을 설정할 수 있습니다.
AutoPipelineForText2Image를 사용하면 내부적으로 결합된 파이프라인을 자동으로 호출할 수 있습니다:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
image이미지-이미지
이미지-이미지 변환의 경우, 초기 이미지와 텍스트 프롬프트를 파이프라인에 전달하여 이미지를 조건화합니다. 먼저 prior 파이프라인을 로드합니다:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3는 이전 모델이 필요하지 않으므로 이미지-이미지 파이프라인을 직접 로드할 수 있습니다:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
조건으로 사용할 이미지를 다운로드합니다:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))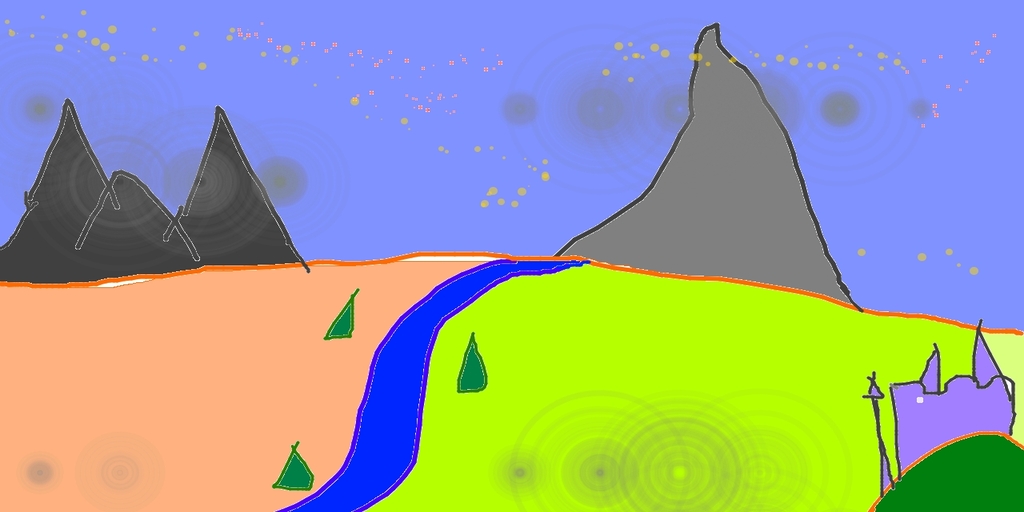
이전 파이프라인으로 image_embeds와 negative_image_embeds를 생성합니다:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
이제 원본 이미지와 모든 프롬프트 및 임베딩을 파이프라인에 전달하여 이미지를 생성하세요:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers는 KandinskyImg2ImgCombinedPipeline와 KandinskyV22Img2ImgCombinedPipeline을 통해 end-to-end API를 제공하므로, prior와 image-to-image 파이프라인을 별도로 로드할 필요가 없습니다. 통합 파이프라인은 prior 모델과 디코더를 자동으로 로드합니다. 원할 경우 prior_guidance_scale와 prior_num_inference_steps 매개변수를 사용하여 prior 파이프라인에 다른 값을 설정할 수 있습니다.
AutoPipelineForImage2Image를 사용하면 내부적으로 결합된 파이프라인을 자동으로 호출할 수 있습니다:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)인페인팅
⚠️ Kandinsky 모델은 이제 검은색 픽셀 대신 ⬜️ 흰색 픽셀을 사용하여 마스킹된 영역을 나타냅니다. 프로덕션 환경에서 KandinskyInpaintPipeline을 사용 중이라면 흰색 픽셀을 사용하도록 마스킹을 변경해야 합니다:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
인페인팅을 위해선 원본 이미지, 원본 이미지에서 대체할 영역의 마스크, 그리고 인페인팅할 대상에 대한 텍스트 프롬프트가 필요합니다. 이전 파이프라인을 로드하세요:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")초기 이미지를 로드하고 마스크를 생성합니다:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
이전 파이프라인으로 임베딩을 생성합니다:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
이제 초기 이미지, 마스크, 프롬프트 및 임베딩을 파이프라인에 전달하여 이미지를 생성합니다:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
end-to-end KandinskyInpaintCombinedPipeline와 KandinskyV22InpaintCombinedPipeline를 사용하여 내부적으로 prior와 decoder 파이프라인을 함께 호출할 수도 있습니다. 이를 위해 AutoPipelineForInpainting를 사용하세요:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)보간
Interpolation을 사용하면 이미지와 텍스트 임베딩 사이의 잠재 공간(latent space)을 탐색할 수 있으며, 이는 이전 모델의 중간 출력 중 일부를 확인하는 좋은 방법입니다. 이전 파이프라인과 보간할 두 이미지를 로드하세요:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

보간할 텍스트 또는 이미지를 지정하고 각 텍스트 또는 이미지에 대한 가중치를 설정합니다. 가중치를 실험하여 보간에 미치는 영향을 확인해 보세요!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
interpolate 함수를 호출하여 임베딩을 생성한 다음, 파이프라인에 전달하여 이미지를 생성합니다:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet은 Kandinsky 2.2에서만 지원됩니다!
ControlNet은 깊이 맵이나 엣지 검출과 같은 추가 입력으로 사전 학습된 대규모 diffusion 모델을 조건화할 수 있게 합니다. 예를 들어, 깊이 맵으로 Kandinsky 2.2를 조건화하면 모델이 깊이 이미지의 구조를 이해하고 유지할 수 있습니다.
이미지를 로드하고 깊이 맵을 추출해 보겠습니다:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
이후 🤗 Transformers의 depth-estimation Pipeline를 사용하여 이미지를 처리하고 깊이 맵을 가져올 수 있습니다:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
텍스트-이미지
이전 파이프라인과 KandinskyV22ControlnetPipeline를 로드합니다:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
프롬프트와 네거티브 프롬프트에서 이미지 임베딩을 생성합니다:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
마지막으로, 이미지 임베딩과 깊이 이미지를 KandinskyV22ControlnetPipeline에 전달하여 이미지를 생성합니다:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
이미지-이미지
ControlNet을 사용한 이미지-이미지 변환에는 다음을 사용해야 합니다:
- KandinskyV22PriorEmb2EmbPipeline를 사용하여 텍스트 프롬프트와 이미지에서 이미지 임베딩을 생성합니다
- 초기 이미지와 이미지 임베딩을 사용하여 이미지를 생성하기 위해 KandinskyV22ControlnetImg2ImgPipeline을(를) 사용합니다
🤗 Transformers의 Pipeline인 depth-estimation를 사용하여 고양이 초기 이미지의 깊이 맵을 처리하고 추출합니다:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
이전 파이프라인과 KandinskyV22ControlnetImg2ImgPipeline를 로드합니다:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
텍스트 프롬프트와 초기 이미지를 prior 파이프라인에 전달하여 이미지 임베딩을 생성합니다:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
이제 초기 이미지와 이미지 임베딩을 사용하여 이미지를 생성하기 위해 KandinskyV22ControlnetImg2ImgPipeline을 실행할 수 있습니다:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
최적화
Kandinsky는 매핑을 생성하기 위한 사전 파이프라인과, latents를 이미지로 디코딩하기 위한 두 번째 파이프라인이 필요하다는 점에서 독특합니다. 대부분의 계산이 두 번째 파이프라인에서 수행되므로 최적화 작업은 이 부분에 집중해야 합니다. 추론 시 Kandinsky의 성능을 향상시키기 위한 몇 가지 팁을 소개합니다.
- PyTorch < 2.0을 사용하는 경우 xFormers를 활성화하세요:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- PyTorch >= 2.0을 사용하는 경우
torch.compile을 활성화하여 스케일된 도트 프로덕트 어텐션(SDPA)을 자동으로 사용하세요:
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
이는 attention processor를 AttnAddedKVProcessor2_0으로 명시적으로 설정하는 것과 동일합니다:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- 메모리 부족 오류를 방지하려면 enable_model_cpu_offload()를 사용하여 모델을 CPU로 오프로드하세요:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- 기본적으로 텍스트-이미지 파이프라인은 DDIMScheduler를 사용하지만, 추론 속도와 이미지 품질 간의 트레이드오프에 미치는 영향을 확인하기 위해 DDPMScheduler와 같은 다른 스케줄러로 교체할 수 있습니다:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
클래스 diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
매개변수
- prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 unCLIP의 표준 prior입니다.
- image_encoder (
CLIPVisionModelWithProjection) — 동결된 이미지 인코더. - text_encoder (
CLIPTextModelWithProjection) — 동결된 텍스트 인코더. - tokenizer (
CLIPTokenizer) — CLIPTokenizer 클래스의 토크나이저. - scheduler (
UnCLIPScheduler) —prior와 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다.
Kandinsky의 이미지 prior를 생성하는 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 25) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - output_type (
str, 선택 사항, 기본값"pt") — 이미지 생성의 출력 형식입니다."np"(np.array) 또는"pt"(torch.Tensor) 중 하나를 선택합니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
KandinskyPriorPipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
매개변수
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — 이미지 생성을 안내하기 위한 프롬프트와 이미지의 목록입니다. - weights — (
list[float]):images_and_prompts의 각 조건에 대한 가중치 목록 - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 25) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - negative_prior_prompt (
str, 선택 사항) — prior diffusion 프로세스를 안내하지 않을 프롬프트입니다. guidance를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 유도하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다.
반환값
KandinskyPriorPipelineOutput 또는 tuple
interpolation에 pipeline을 사용할 때 호출되는 함수입니다.
예:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
클래스 diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (
DDIMScheduler|DDPMScheduler) —unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — Latents에서 이미지를 생성하기 위한 MoVQ Decoder입니다.
Kandinsky를 사용한 텍스트-이미지 생성을 위한 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - image_embeds (
torch.Tensor또는list[torch.Tensor]) — 이미지 생성을 조건부로 제어하기 위해 텍스트 프롬프트에 사용되는 클립 이미지 임베딩입니다. - negative_image_embeds (
torch.Tensor또는list[torch.Tensor]) — 음성 텍스트 프롬프트에 대한 CLIP 이미지 임베딩입니다. 이미지 생성을 조건화하는 데 사용됩니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
클래스 diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (
DDIMScheduler|DDPMScheduler) —unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — Latents에서 이미지를 생성하기 위한 MoVQ Decoder입니다.
- prior_prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 표준 unCLIP prior입니다.
- prior_image_encoder (
CLIPVisionModelWithProjection) — 동결된 이미지 인코더. - prior_text_encoder (
CLIPTextModelWithProjection) — 동결된 텍스트 인코더. - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 클래스의 토크나이저. - prior_scheduler (
UnCLIPScheduler) —prior와 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다.
Kandinsky를 사용한 텍스트-이미지 생성을 위한 통합 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - prior_guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 guidance scale입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 guidance scale이 활성화됩니다. guidance scale이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 장려하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - prior_num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
🤗 Accelerate를 사용하여 모든 모델(unet, text_encoder, vae, safety checker 상태 사전)을 CPU로 오프로드하여 메모리 사용량을 크게 줄입니다. 모델은 torch.device('meta')로 이동되며, 해당 서브모듈의 forward 메서드가 호출될 때만 GPU에 로드됩니다. 오프로딩은 서브모듈 단위로 수행됩니다. enable_model_cpu_offload를 사용하는 것보다 메모리 절감 효과가 크지만 성능은 낮습니다.
KandinskyImg2ImgPipeline
클래스 diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (DDIMScheduler) —
unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러입니다. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — MoVQ 이미지 인코더 및 디코더
Kandinsky를 사용한 이미지-이미지 생성을 위한 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - image (
torch.Tensor,PIL.Image.Image) — 프로세스의 시작점으로 사용될Image또는 이미지 배치 텐서. - image_embeds (
torch.Tensor또는list[torch.Tensor]) — 이미지 생성을 조건부로 제어하기 위해 텍스트 프롬프트에 사용되는 클립 이미지 임베딩입니다. - negative_image_embeds (
torch.Tensor또는list[torch.Tensor]) — 음성 텍스트 프롬프트에 대한 CLIP 이미지 임베딩입니다. 이미지 생성을 조건화하는 데 사용됩니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - strength (
float, 선택 사항, 기본값 0.3) — 개념적으로, 참조image를 얼마나 변환할지를 나타냅니다. 0과 1 사이여야 합니다.image가 시작점으로 사용되며,strength값이 클수록 더 많은 노이즈가 추가됩니다. 디노이징 단계의 수는 초기에 추가된 노이즈의 양에 따라 결정됩니다.strength가 1이면 추가되는 노이즈가 최대가 되며,num_inference_steps에 지정된 전체 반복 횟수만큼 디노이징 프로세스가 실행됩니다. 따라서 1이라는 값은 실질적으로image를 무시하는 것과 같습니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
클래스 diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (
DDIMScheduler|DDPMScheduler) —unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — Latents에서 이미지를 생성하기 위한 MoVQ Decoder입니다.
- prior_prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 표준 unCLIP prior입니다.
- prior_image_encoder (
CLIPVisionModelWithProjection) — 동결된 이미지 인코더. - prior_text_encoder (
CLIPTextModelWithProjection) — 동결된 텍스트 인코더. - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 클래스의 토크나이저. - prior_scheduler (
UnCLIPScheduler) —prior와 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다.
Kandinsky를 사용한 이미지-이미지 생성을 위한 통합 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]또는list[np.ndarray]) — 프로세스의 시작점으로 사용될Image또는 이미지 배치 텐서입니다. 직접 latents를 전달하는 경우,image로 이미지 latents를 받아도 되며, 이 경우 다시 인코딩되지 않습니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - strength (
float, 선택 사항, 기본값 0.3) — 개념적으로, 참조image를 얼마나 변환할지를 나타냅니다. 0과 1 사이여야 합니다.image가 시작점으로 사용되며,strength값이 클수록 더 많은 노이즈가 추가됩니다. 디노이징 단계의 수는 초기에 추가된 노이즈의 양에 따라 결정됩니다.strength가 1이면 추가되는 노이즈가 최대가 되며,num_inference_steps에 지정된 전체 반복 횟수만큼 디노이징 프로세스가 실행됩니다. 따라서 1이라는 값은 실질적으로image를 무시하는 것과 같습니다. - prior_guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 guidance scale입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 guidance scale이 활성화됩니다. guidance scale이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 장려하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - prior_num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
class diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (DDIMScheduler) —
unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러입니다. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — MoVQ 이미지 인코더 및 디코더
Kandinsky2.1을 사용한 텍스트 기반 이미지 인페인팅을 위한 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - image (
torch.Tensor,PIL.Image.Image또는np.ndarray) — 프로세스의 시작점으로 사용될Image또는 이미지 배치 텐서입니다. - mask_image (
PIL.Image.Image,torch.Tensor또는np.ndarray) —image를 마스킹할Image또는 이미지 배치 텐서입니다. 마스크의 흰색 픽셀은 다시 채워지고, 검은색 픽셀은 유지됩니다. pytorch 텐서를 마스크로 전달하려면 전달한 이미지도 pytorch 텐서여야 하며, 3개 대신 1개의 색상 채널(L)을 포함해야 하므로 예상되는 모양은(B, 1, H, W,),(B, H, W),(1, H, W)또는(H, W)입니다. 이미지가 PIL 이미지 또는 numpy 배열인 경우, 마스크도 PIL 이미지 또는 numpy 배열이어야 합니다. PIL 이미지의 경우 사용 전에 단일 채널(명도)로 변환됩니다. numpy 배열인 경우 예상되는 모양은(H, W)입니다. - image_embeds (
torch.Tensor또는list[torch.Tensor]) — 이미지 생성을 조건부로 제어하기 위해 텍스트 프롬프트에 사용되는 클립 이미지 임베딩입니다. - negative_image_embeds (
torch.Tensor또는list[torch.Tensor]) — 음성 텍스트 프롬프트에 대한 CLIP 이미지 임베딩입니다. 이미지 생성을 조건화하는 데 사용됩니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
class diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
매개변수
- text_encoder (
MultilingualCLIP) — 동결된 텍스트 인코더입니다. - tokenizer (
XLMRobertaTokenizer) — 클래스 - scheduler (
DDIMScheduler|DDPMScheduler) —unet와 함께 사용하여 이미지 latents를 생성하는 데 사용되는 스케줄러. - unet (UNet2DConditionModel) — 이미지 임베딩의 노이즈를 제거하기 위한 조건부 U-Net 아키텍처.
- movq (VQModel) — Latents에서 이미지를 생성하기 위한 MoVQ Decoder입니다.
- prior_prior (PriorTransformer) — 텍스트 임베딩에서 이미지 임베딩을 근사하기 위한 표준 unCLIP prior입니다.
- prior_image_encoder (
CLIPVisionModelWithProjection) — 동결된 이미지 인코더. - prior_text_encoder (
CLIPTextModelWithProjection) — 동결된 텍스트 인코더. - prior_tokenizer (
CLIPTokenizer) — CLIPTokenizer 클래스의 토크나이저. - prior_scheduler (
UnCLIPScheduler) —prior와 함께 사용하여 이미지 임베딩을 생성하는 데 사용되는 스케줄러입니다.
Kandinsky를 사용하여 생성을 위한 통합 Pipeline
이 모델은 DiffusionPipeline에서 상속됩니다. 라이브러리가 모든 파이프라인에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 특정 디바이스에서 실행 등)에 대해서는 상위 클래스 문서를 확인하세요.
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
매개변수
- prompt (
str또는list[str]) — 이미지 생성을 안내하는 프롬프트 또는 프롬프트 목록입니다. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]또는list[np.ndarray]) — 프로세스의 시작점으로 사용될Image또는 이미지 배치 텐서입니다. 직접 latents를 전달하는 경우,image로 이미지 latents를 받아도 되며, 이 경우 다시 인코딩되지 않습니다. - mask_image (
np.array) —image를 마스킹하기 위한 이미지 배치 텐서입니다. 마스크의 흰색 픽셀은 다시 채워지고, 검은색 픽셀은 유지됩니다.mask_image가 PIL 이미지인 경우, 사용 전에 단일 채널(휘도)로 변환됩니다. 텐서인 경우 3개 대신 하나의 색상 채널(L)을 포함해야 하므로, 예상되는 모양은(B, H, W, 1)입니다. - negative_prompt (
str또는list[str], 선택 사항) — 이미지 생성을 안내하지 않을 프롬프트입니다. 가이던스를 사용하지 않는 경우 무시됩니다(즉,guidance_scale이1보다 작은 경우 무시됩니다). - num_images_per_prompt (
int, 선택 사항, 기본값 1) — 프롬프트당 생성할 이미지의 수입니다. - num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - height (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 높이입니다. - width (
int, 선택 사항, 기본값 512) — 생성된 이미지의 픽셀 단위 너비입니다. - prior_guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 guidance scale입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 guidance scale이 활성화됩니다. guidance scale이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 장려하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - prior_num_inference_steps (
int, 선택 사항, 기본값 100) — 디노이징 단계의 수입니다. 디노이징 단계가 많을수록 일반적으로 더 높은 품질의 이미지를 생성하지만, 추론 속도가 느려집니다. - guidance_scale (
float, 선택 사항, 기본값 4.0) — Classifier-Free Diffusion Guidance에서 정의한 가이던스 스케일입니다.guidance_scale은 Imagen Paper의 방정식 2의w로 정의됩니다.guidance_scale > 1로 설정하면 가이던스 스케일이 활성화됩니다. 가이던스 스케일이 높을수록prompt텍스트와 밀접하게 연결된 이미지를 생성하도록 유도하지만, 일반적으로 이미지 품질이 낮아지는 대가를 치릅니다. - generator (
torch.Generator또는list[torch.Generator], 선택 사항) — 생성을 결정적으로 만들기 위한 torch generator 하나 또는 목록 - latents (
torch.Tensor, 선택 사항) — 이미지 생성의 입력으로 사용할 가우시안 분포에서 샘플링된 사전 생성된 노이즈 latents입니다. 동일한 생성을 다른 프롬프트로 조정하는 데 사용할 수 있습니다. 제공되지 않으면, 제공된 랜덤generator를 사용하여 샘플링하여 latents 텐서가 생성됩니다. - output_type (
str, 선택 사항, 기본값"pil") — 이미지 생성의 출력 형식입니다. 다음 중 하나를 선택하세요:"pil"(PIL.Image.Image),"np"(np.array) 또는"pt"(torch.Tensor). - callback (
Callable, 선택 사항) — 추론 중callback_steps스텝마다 호출되는 함수입니다. 이 함수는 다음 인수를 받아 호출됩니다:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, 선택 사항, 기본값 1) —callback함수가 호출되는 주기입니다. 지정하지 않으면 모든 단계에서 callback이 호출됩니다. - return_dict (
bool, 선택 사항, 기본값True) — 일반 튜플 대신 ImagePipelineOutput을 반환할지 여부.
반환값
ImagePipelineOutput 또는 tuple
생성을 위해 파이프라인을 호출할 때 호출되는 함수.
예:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.