
Diffusers documentation
Marigold コンピュータービジョン
Marigold コンピュータービジョン
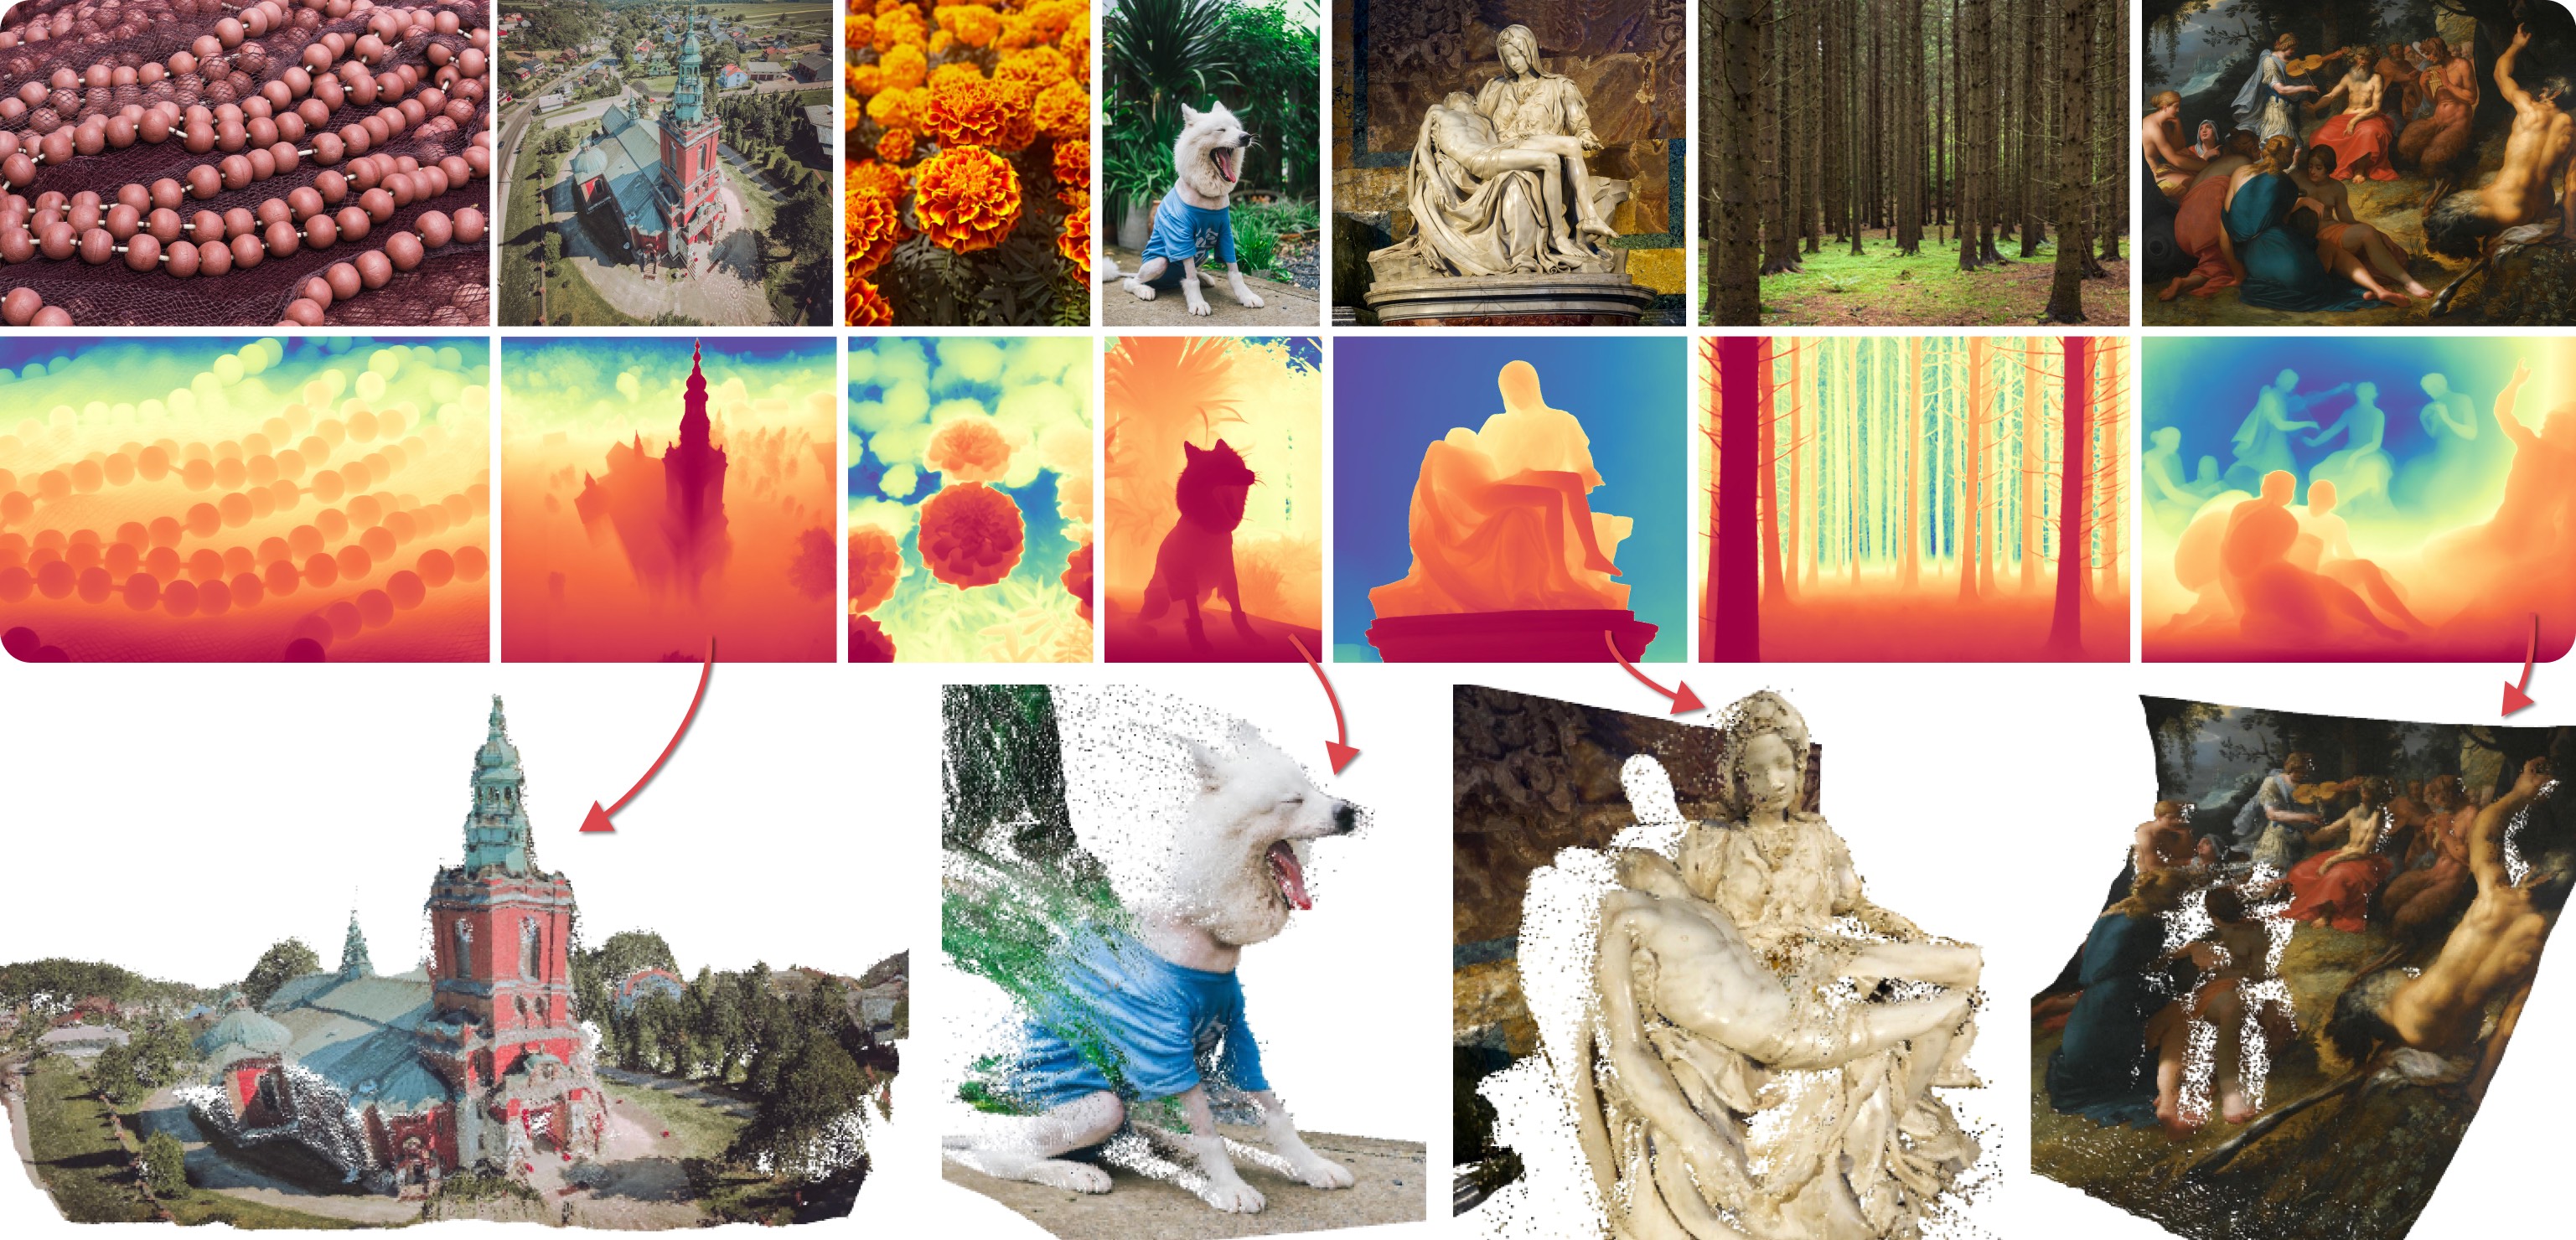
Marigold は、Bingxin Ke、Anton Obukhov、Shengyu Huang、Nando Metzger、Rodrigo Caye Daudt、および Konrad Schindler による CVPR 2024 Oral 論文 Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation で提案されました。 その核心となるアイデアは、Text-to-Image Latent Diffusion Models (LDMs) の生成事前分布を、従来のコンピュータビジョンタスクに転用することです。 このアプローチは、上記のティザーで示されているように、Monocular Depth Estimation 向けに Stable Diffusion をファインチューニングすることで検証されました。
Marigoldは、Bingxin Ke、Kevin Qu、Tianfu Wang、Nando Metzger、Shengyu Huang、Bo Li、Anton Obukhov、およびKonrad Schindlerによる後続論文Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysisにおいて拡張されました。 この研究では、Surface NormalsやIntrinsic Image Decomposition(IID)といった新しいモダリティへの対応が追加され、Latent Consistency Models(LCM)向けのトレーニングプロトコルが導入され、High-Resolution(HR)処理能力が実証されました。
初期の Marigold モデル(
v1-0およびそれ以前)は、少なくとも10回の推論ステップで最良の結果を得られるよう最適化されていました。 その後、LCM モデルが開発され、わずか1〜4回のステップで高品質な推論が可能になりました。v1-1以降の Marigold モデルは、DDIM スケジューラーを使用することで、わずか1〜4回のステップで最適な結果を実現します。
利用可能なパイプライン
各パイプラインは特定のコンピュータビジョンタスク向けに設計されており、入力されたRGB画像を処理して、対応する予測を生成します。 現在、以下のコンピュータビジョンタスクが実装されています:
利用可能なチェックポイント
すべてのオリジナルのチェックポイントは、Hugging Face上のPRS-ETH組織の下で利用可能です。 これらは、diffusersのパイプラインおよびオリジナルのコードベースでの使用を前提として設計されており、新しいモデルのチェックポイントのトレーニングにも使用できます。 以下は、推奨されるチェックポイントの概要です。いずれも1ステップから4ステップで信頼できる結果を生成します。
| チェックポイント | モダリティ | コメント |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | 深さ | Affine-invariant depth predictionでは、各ピクセルに0(近面)から1(遠面)の値が割り当てられ、両方の面は推論中にモデルによって決定されます。 |
| prs-eth/marigold-normals-v0-1 | ノーマル | 表面法線の予測値は、スクリーン空間のカメラにおける単位長さの3次元ベクトルであり、値の範囲は-1から1です。 |
| prs-eth/marigold-iid-appearance-v1-1 | イントリニクス | InteriorVerseの分解は、Albedoと2つのBRDFマテリアル特性であるRoughnessとMetallicityで構成されています。 |
| prs-eth/marigold-iid-lighting-v1-1 | イントリニクス | 画像のHyperSim分解 は、アルベド $A$、ディフューズシェーディング $S$、および非ディフューズ残差 $R$ で構成され、$I = A*S+R$ と表されます。 |
スケジューラーのトレードオフ、すなわち速度と品質のバランスをどのように調整するかを学ぶには、ガイドを参照してください。また、同じコンポーネントを複数のパイプラインに効率的に読み込む方法については、パイプライン間でコンポーネントを再利用するセクションをご覧ください。 さらに、このパイプラインのメモリ使用量を削減する方法については、こちらの[“メモリ使用量の削減”]セクションを参照してください。
Marigold パイプラインは、モデルのチェックポイントにスケジューラが埋め込まれていることを前提として設計・テストされました。 最適な推論ステップ数はスケジューラによって異なり、すべてのケースで最適に機能する普遍的な値はありません。 この点に対応するため、パイプラインの
__call__メソッドにおけるnum_inference_stepsパラメータのデフォルト値はNoneに設定されています(API リファレンスを参照してください)。 明示的に設定されない限り、チェックポイントの設定ファイル(model_index.json)内のdefault_denoising_stepsフィールドの値が継承されます。 これにより、image引数のみを指定してパイプラインを呼び出す場合でも、高品質な予測が得られます。
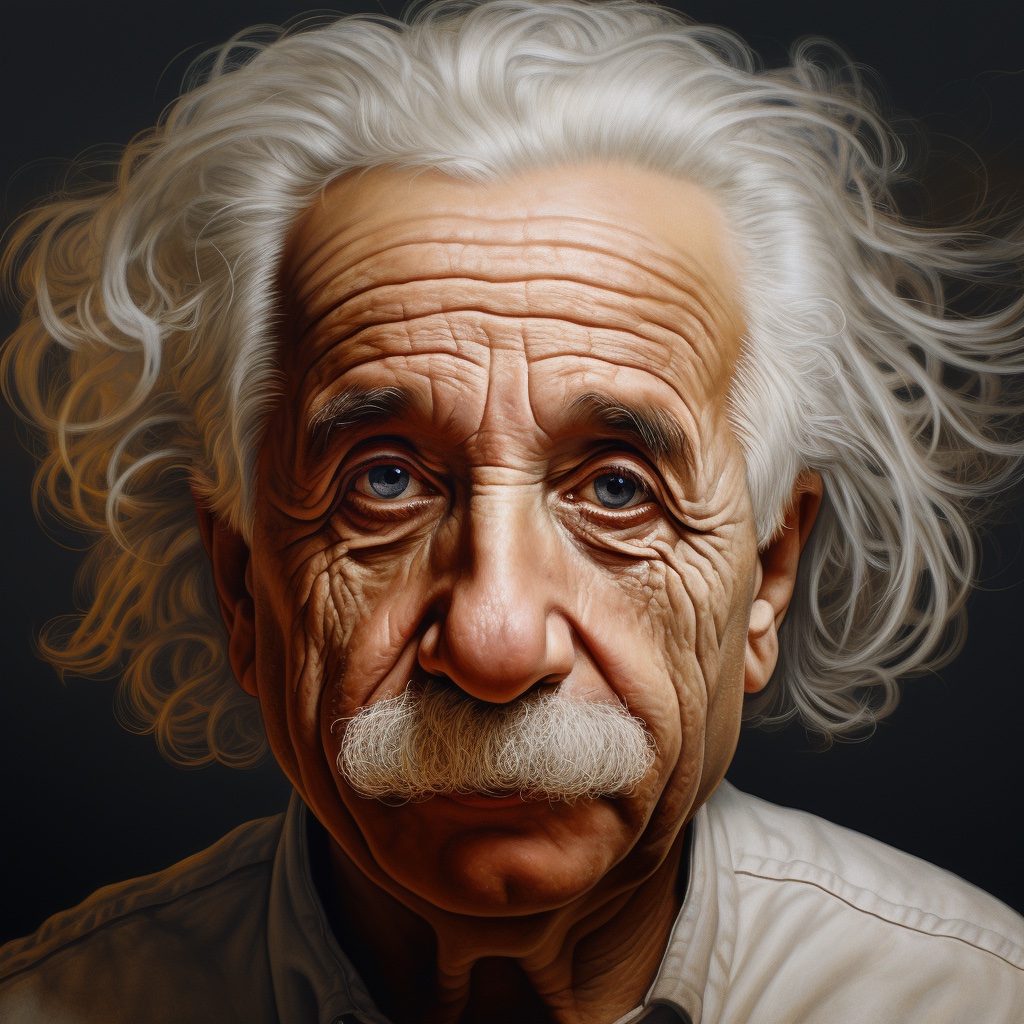
以下の例は主に深度予測について示されていますが、サポートされている他のモダリティにも普遍的に適用できます。 Midjourneyで生成したアルベルト・アインシュタインの同じ入力画像を用いて予測結果をデモします。 これにより、さまざまなモダリティとチェックポイント間の予測の可視化を比較しやすくなります。
深度予測
深度予測を取得するには、prs-eth/marigold-depth-v1-1 チェックポイントを MarigoldDepthPipeline に読み込み、画像をパイプラインに通し、予測結果を保存します。
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
visualize_depth() 関数は、matplotlib のカラーマップ(デフォルトは Spectral)を適用し、単一チャネルの [0, 1] 深度範囲の予測ピクセル値を RGB 画像にマッピングします。
Spectral カラーマップでは、深度が近いピクセルは赤、遠いピクセルは青で描画されます。
16 ビット PNG ファイルには、[0, 1] 範囲から [0, 65535] 範囲へ線形にマッピングされた単一チャネルの値が保存されます。
以下は、生データと可視化された予測結果です。
可視化では、暗く近い領域(ひげ)の方が区別しやすくなります。


法線推定
prs-eth/marigold-normals-v1-1 チェックポイントを MarigoldNormalsPipeline に読み込み、画像をパイプラインに通して、予測結果を保存します。
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
visualize_normals() は、ピクセル値が [-1, 1] の範囲にある3次元の予測をRGB画像に変換します。この可視化関数は、座標軸の反転をサポートしており、他の基準系との互換性を確保できます。概念的には、各ピクセルは基準系における表面法線ベクトルに基づいて描画され、X 軸は右を、Y 軸は上を、Z 軸は視聴者側を指します。以下は可視化された予測です。

この例では、鼻先にはほぼ確実に表面に点があり、その表面法線ベクトルは視聴者に向かってまっすぐ指しています。つまり、その座標は[0, 0, 1]です。
このベクトルはRGBの[128, 128, 255]にマッピングされ、これは紫がかった青色に対応します。
同様に、画像の右側の頬にある表面法線は大きなX成分を持ち、赤みが強くなります。
肩の上向きで大きなY成分を持つ点は、緑がかった色を促します。
固有画像分解
Marigold は、Intrinsic Image Decomposition (IID) 用の 2 つのモデル、「Appearance」と「Lighting」を提供しています。 それぞれのモデルは、Albedo マップを生成します。これらは、それぞれ InteriorVerse と Hypersim のアノテーションから導出されています。
- 「Appearance」モデルは、RoughnessとMetallicityというMaterialプロパティも推定します。
- “Lighting”モデルは、Diffuse ShadingとNon-diffuse Residualを生成します。
以下は、“Appearance”モデルによる予測結果を保存するサンプルコードです:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
“Lighting”モデルによる予測を示す別の例:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
両方のモデルは同じパイプラインを共有しつつ、異なる分解タイプをサポートしています。
正確な分解のパラメータ化(例: sRGB空間と線形空間)は、visualize_intrinsics()関数に渡されるpipe.target_properties辞書に格納されています。
以下は、予測された分解出力を示すいくつかの例です。 すべてのモダリティは、Intrinsic Image Decomposition Space で確認できます。


推論の高速化
上記のクイックスタートのスニペットは、品質と速度の両面ですでに最適化されており、チェックポイントを読み込み、fp16の重みと計算のバリアントを利用し、デノイジング拡散ステップのデフォルト数(4回)を実行します。
予測品質を犠牲にして推論を高速化する最初のステップは、デノイジング拡散ステップを最小限に減らすことです:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)この変更により、pipe の呼び出しは RTX 3090 GPU 上で 280ms で完了します。
内部では、入力画像がまず Stable Diffusion の VAE エンコーダーによってエンコードされ、その後 U-Net によって 1 ステップのデノイジングが行われます。
最後に、予測された潜在変数が VAE デコーダーによってピクセル空間にデコードされます。
この設定では、3 つのモジュール呼び出しのうち 2 つが、LDM のピクセル空間と潜在空間の相互変換に費やされています。
Marigold の潜在空間は Stable Diffusion 2.0 と互換性があるため、軽量な SD VAE の代替 を使用することで、推論を 3 倍以上高速化し、RTX 3090 での呼び出し時間を 85ms に短縮できます。
軽量な VAE を使用すると、予測の視覚的な品質がわずかに低下する可能性があることに注意してください。
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
これまで、拡散ステップ数とモデルコンポーネントを最適化してきました。自己注意(self-attention)操作は計算量の大部分を占めています。より効率的なアテンションプロセッサを使用することで、これらを高速化できます。
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image, num_inference_steps=1)最後に、最適化で提案されているように、torch.compileを有効にすると、対象ハードウェアに応じてパフォーマンスをさらに向上させることができます。
ただし、コンパイルには最初のパイプライン呼び出し時に大きなオーバーヘッドが発生するため、ループ内のように同じパイプラインインスタンスが繰り返し呼び出される場合にのみ有効です。
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
精度の最大化とアンサンブル
Marigoldのパイプラインには、異なるランダムな潜在変数からの複数の予測を組み合わせる組み込みのアンサンブル機構があります。
これは拡散モデルの生成特性を活かして予測の精度を向上させる、強引な手法です。
ensemble_size引数が3以上である場合、アンサンブル処理が自動的に有効になります。
最大限の精度を追求する場合、num_inference_stepsとensemble_sizeを同時に調整するのが理にかなっています。
推奨値はチェックポイントによって異なりますが、主にスケジューラーの種類に依存します。
アンサンブルの効果は、サーフェスノーマルにおいて特に顕著に現れます:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 
ご覧のとおり、髪などの細粒度の構造を持つ領域では、より保守的かつ平均的に正確な予測が得られました。 このような結果は、3D再構築など、精度に敏感な下流タスクにより適しています。
時間的一整合性を保ちたフレーム単位の動画処理
Marigoldは生成モデルであるため、各予測は一意であり、潜在変数の初期化のためにサンプリングされるランダムノイズによって定義されます。 これは、以下の動画に示されるように、従来のエンドツーエンドの密集型回帰ネットワークと比較して、明白な欠点となります。


この問題を解決するために、パイプラインにlatents引数を渡すことができます。この引数は拡散の開始点を定義します。
経験的に、同じ開始点のノイズ潜在変数と、前フレームの予測に対応する潜在変数の凸結合を用いることで、十分に滑らかな結果が得られることが確認されています。以下のスニペットにその実装を示します。
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
ここでは、拡散プロセスは与えられた計算済み潜在変数から開始されます。
パイプラインはoutput_latent=Trueを設定してout.latentにアクセスし、次のフレームの潜在変数の初期化への寄与を計算します。
その結果、はるかに安定した出力が得られるようになりました:

ControlNet 用の Marigold
拡散モデルによる深度予測の非常に一般的な応用として、ControlNetとの併用があります。 ControlNetから高品質な結果を得るためには、深度の鮮明さが重要な役割を果たします。 上記の他の手法との比較に見られるように、Marigoldはこのタスクで優れた性能を発揮します。 以下のスニペットは、画像を読み込み、深度を計算し、互換性のある形式でControlNetに渡す方法を示しています。
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")


定量的評価
Marigold を標準的なリーダーボードやベンチマーク(NYU、KITTI、その他のデータセットなど)で定量的に評価するには、論文に示された評価プロトコルに従ってください。フルプレシションの fp32 モデルを読み込み、num_inference_steps と ensemble_size に適切な値を設定します。再現性を確保するために、乱数のシードを指定することもできます。batch_size を最大化することで、デバイスの利用率を最大限に高めることができます。
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
予測的不確実性の使用
Marigold パイプラインに組み込まれたアンサンブル機構は、異なるランダムな潜在変数から得られた複数の予測を組み合わせます。
副次的な効果として、認識論的不確実性(モデルの不確実性)を定量化するために使用できます。
ensemble_size を 3 以上とし、output_uncertainty=True を設定するだけです。
得られた不確実性は、出力の uncertainty フィールドで利用できます。
以下のように可視化できます:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")


不確実性の解釈は簡単です。高い値(白)は、モデルが一貫した予測を行うのが困難なピクセルに対応します。
- 深度モデルは、物体の深度が急激に変化する不連続点の周辺で、最も不確実性が高くなります。
- サーフェスノーマルモデルは、髪のような細かな構造や、襟元のような暗い領域では最も信頼度が低くなります。
- アルベドの不確実性は、深度や表面法線とは異なり、各カラーチャネルごとに独立して不確実性を捉えるため、RGB画像として表現されます。また、影の落ちた領域や不連続点付近では、不確実性が高くなります。
Marigold Depth Prediction API
class diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
パラメータ
- unet (
UNet2DConditionModel) — 画像の潜在変数に条件付けられ、深度の潜在変数のノイズ除去を行う条件付き U-Net です。 - vae (
AutoencoderKL) — 画像と予測を潜在表現にエンコードおよびデコードするための変分オートエンコーダ (VAE) モデル。 - scheduler (
DDIMSchedulerまたはLCMScheduler) —unetと組み合わせて、エンコードされた画像の潜在変数からノイズを除去するために使用するスケジューラです。 - text_encoder (
CLIPTextModel) — 空のテキスト埋め込み用のテキストエンコーダー。 - tokenizer (
CLIPTokenizer) — CLIPのトークナイザーです。 - prediction_type (
str、任意) — モデルが生成する予測の種類。 - scale_invariant (
bool, 省略可) — 予測された深度マップがスケール不変であるかどうかを指定するモデルのプロパティです。この値はモデルの config に設定する必要があります。shift_invariant=Trueフラグと併せて使用する場合、そのモデルは「アフィン不変」とも呼ばれます。なお、この値の上書きはサポートされていません。 - shift_invariant (
bool, 任意) — 予測された深度マップがシフト不変であるかどうかを指定するモデルのプロパティです。この値はモデルの config に設定する必要があります。scale_invariant=Trueフラグと組み合わせて使用する場合、そのモデルは「アフィン不変」とも呼ばれます。なお、この値の上書きはサポートされていません。 - default_denoising_steps (
int, 任意) — 指定されたモデルで、適切な品質の予測を生成するために必要な最小のデノイジング拡散ステップ数です。この値はモデルの設定で設定する必要があります。パイプラインを呼び出す際にnum_inference_stepsが明示的に設定されていない場合、このデフォルト値が使用されます。これにより、非常に短いデノイジングスケジュールに依存するLCMSchedulerや、完全な拡散スケジュールを持つDDIMSchedulerなど、パイプラインと互換性のあるさまざまなモデルバリエーションで、適切な結果が得られることが保証されます。 - default_processing_resolution (
int, 省略可) — パイプラインのprocessing_resolutionパラメータの推奨値です。この値はモデルの config に設定する必要があります。パイプラインを呼び出す際にprocessing_resolutionを明示的に設定しない場合、デフォルト値が使用されます。これは、最適な処理解像度が異なる各種モデルのバリエーションで、適切な結果を得るために必要です。
Marigold手法を用いた単眼深度推定のためのPipeline: https://marigoldmonodepth.github.io。
このモデルは DiffusionPipeline を継承しています。すべてのパイプラインに対してライブラリが実装している汎用的なメソッド(ダウンロードや保存、特定のデバイスでの実行など)については、スーパークラスのドキュメントを参照してください。
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
パラメータ
- image (
PIL.Image.Image、np.ndarray、torch.Tensor、list[PIL.Image.Image]、list[np.ndarray]、list[torch.Tensor]): 深度推定タスクの入力として使用する画像または画像のリストです。配列やテンソルの場合、想定される値の範囲は[0, 1]です。4次元の配列またはテンソルを渡すことで、画像のバッチを渡すことができます。また、2次元または3次元の配列またはテンソルからなる画像のリストを渡すことも可能です。後者の場合、リストのすべての要素は同じ幅と高さを有する必要があります。 - num_inference_steps (
int、任意、デフォルトはNone) — 推論時のデノイジング拡散ステップ数です。デフォルト値Noneの場合、自動的に選択されます。 - ensemble_size (
int、デフォルトは1) — アンサンブル予測の数です。値を大きくすると、測定可能な性能向上と視覚的な劣化が同時に生じます。 - processing_resolution (
int、任意、デフォルトはNone) — 実際の処理解像度です。0に設定すると、入力画像の大きい方の寸法に一致します。これにより予測がより鮮明になりますが、全体コンテキストの喪失につながる可能性もあります。デフォルト値Noneは、モデル設定から最適な値に解決されます。 - match_input_resolution (
bool、省略可能、デフォルトはTrue) — 有効にすると、出力予測は入力サイズに合わせてリサイズされます。無効にすると、出力の長い辺はprocessing_resolutionと等しくなります。 - resample_method_input (
str、任意、デフォルトは"bilinear") —processing_resolutionに入力画像をリサイズするために使用されるリサンプリング手法です。受け入れられる値は、"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - resample_method_output (
str、任意、デフォルトは"bilinear") — 出力予測をインプットの解像度に合わせるために使用されるリサンプリング手法です。受け入れられる値は"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - batch_size (
int、任意、デフォルトは1) — バッチサイズ。ensemble_sizeを設定する場合、または画像のテンソルを渡す場合にのみ関連します。 - ensembling_kwargs (
dict, 省略可, デフォルトはNone) — アンサンブルの制御を精密に行うための引数を格納した追加の辞書。利用可能なオプションは以下の通りです:- reduction (
str、任意、デフォルトは"median"): 各ピクセル位置に適用されるアンサンブル関数を定義します。"median"または"mean"のいずれかを指定できます。 - regularizer_strength (
float、任意、デフォルトは0.02): 整列された予測を 0 から 1 の単位範囲に引き寄せる正則化の強さ。 - max_iter (
int、任意、デフォルトは2): アライメントソルバーのステップ数の最大値。scipy.optimize.minimize関数のoptions引数を参照してください。 - tol (
float、任意、デフォルトは1e-3): アライメントソルバーの許容誤差。許容誤差に達すると、ソルバーは停止します。 - max_res (
int、任意、デフォルトはNone): アライメントを実行する解像度。Noneの場合、processing_resolutionに一致します。
- reduction (
- latents (
torch.Tensorまたはlist[torch.Tensor]、任意、デフォルトはNone) — ランダム初期化に置き換えるための潜在ノイズテンソルです。これらは、直前の関数呼び出しの出力から取得できます。 - generator (
torch.Generator、またはlist[torch.Generator]、任意、デフォルトはNone) — 再現性を確保するための乱数生成器オブジェクト。 - output_type (
str、任意、デフォルトは"np") — 出力のpredictionおよび任意のuncertaintyフィールドの推奨フォーマット。受け入れられる値は、"np"(numpy 配列)または"pt"(torch テンソル)です。 - output_uncertainty (
bool、任意、デフォルトはFalse) — 有効にすると、ensemble_size引数が 2 より大きい値に設定されている場合、出力のuncertaintyフィールドに予測不確実性マップが含まれます。 - output_latent (
bool、任意、デフォルトはFalse) — 有効にすると、出力のlatentフィールドには、アンサンブル内の予測に対応する潜在コードが含まれます。これらのコードは保存・変更でき、latents引数を用いた後続の呼び出しに使用できます。 - return_dict (
bool、省略可、デフォルトはTrue) —Trueの場合、通常のタプルではなく MarigoldDepthOutput を返します。
戻り値
MarigoldDepthOutput または tuple
return_dict が True の場合、MarigoldDepthOutput が返され、それ以外の場合は tuple が返されます。このとき、最初の要素は予測値、2番目の要素は不確実性(または None)、3番目の要素は潜在変数(または None)です。
パイプラインを呼び出したときに実行される関数。
例:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
class diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
パラメータ
- prediction (
np.ndarray,torch.Tensor) — 値が [0, 1] の範囲にある予測深度マップ。torch.Tensorの場合はnumimages × 1 × height × width、np.ndarrayの場合はnumimages × height × width × 1の形状です。 - uncertainty (
None、np.ndarray、torch.Tensor) — アンサンブルから計算された不確実性マップで、値の範囲は [0, 1] です。torch.Tensorの場合は形状がnumimages × 1 × height × width、np.ndarrayの場合はnumimages × height × width × 1になります。 - latent (
None,torch.Tensor) — 予測に対応する潜在特徴量です。パイプラインのlatents引数と互換性があります。 形状はnumimages * numensemble × 4 × latentheight × latentwidthです。
Marigold単眼深度推定パイプライン用の出力クラス。
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
パラメータ
MarigoldDepthPipelineの予測値などの深度マップを可視化します。
Returns: 深度マップの可視化を含むlist[PIL.Image.Image]。
Marigold Normals Estimation API
class diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
パラメータ
- unet (
UNet2DConditionModel) — 画像の潜在変数に条件付け、ノーマルの潜在変数のノイズ除去を行う条件付き U-Net です。 - vae (
AutoencoderKL) — 画像と予測を潜在表現にエンコードおよびデコードするための変分オートエンコーダ (VAE) モデル。 - scheduler (
DDIMSchedulerまたはLCMScheduler) —unetと組み合わせて、エンコードされた画像の潜在変数からノイズを除去するために使用するスケジューラです。 - text_encoder (
CLIPTextModel) — 空のテキスト埋め込み用のテキストエンコーダー。 - tokenizer (
CLIPTokenizer) — CLIPのトークナイザーです。 - prediction_type (
str、任意) — モデルが生成する予測の種類。 - use_full_z_range (
bool, 任意) — このモデルが予測する法線が、Z 次元の全範囲を利用するか、正の半分のみを利用するかを指定します。 - default_denoising_steps (
int, 任意) — 指定されたモデルで、適切な品質の予測を生成するために必要な最小のデノイジング拡散ステップ数です。この値はモデルの設定で設定する必要があります。パイプラインを呼び出す際にnum_inference_stepsが明示的に設定されていない場合、このデフォルト値が使用されます。これにより、非常に短いデノイジングスケジュールに依存するLCMSchedulerや、完全な拡散スケジュールを持つDDIMSchedulerなど、パイプラインと互換性のあるさまざまなモデルバリエーションで、適切な結果が得られることが保証されます。 - default_processing_resolution (
int, 省略可) — パイプラインのprocessing_resolutionパラメータの推奨値です。この値はモデルの config に設定する必要があります。パイプラインを呼び出す際にprocessing_resolutionを明示的に設定しない場合、デフォルト値が使用されます。これは、最適な処理解像度が異なる各種モデルのバリエーションで、適切な結果を得るために必要です。
Marigold手法を用いた単眼法線推定のパイプライン: https://marigoldmonodepth.github.io。
このモデルは DiffusionPipeline を継承しています。すべてのパイプラインに対してライブラリが実装している汎用的なメソッド(ダウンロードや保存、特定のデバイスでの実行など)については、スーパークラスのドキュメントを参照してください。
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
パラメータ
- image (
PIL.Image.Image、np.ndarray、torch.Tensor、list[PIL.Image.Image]、list[np.ndarray]、list[torch.Tensor]): 法線推定タスクの入力として使用する画像または画像のリストです。配列やテンソルの場合、想定される値の範囲は[0, 1]です。4次元の配列またはテンソルを渡すことで、画像のバッチを渡すことができます。また、2次元または3次元の配列またはテンソルからなる画像のリストを渡すことも可能です。後者の場合、リストのすべての要素は同じ幅と高さを有する必要があります。 - num_inference_steps (
int、任意、デフォルトはNone) — 推論時のデノイジング拡散ステップ数です。デフォルト値Noneの場合、自動的に選択されます。 - ensemble_size (
int、デフォルトは1) — アンサンブル予測の数です。値を大きくすると、測定可能な性能向上と視覚的な劣化が同時に生じます。 - processing_resolution (
int、任意、デフォルトはNone) — 実際の処理解像度です。0に設定すると、入力画像の大きい方の寸法に一致します。これにより予測がより鮮明になりますが、全体コンテキストの喪失につながる可能性もあります。デフォルト値Noneは、モデル設定から最適な値に解決されます。 - match_input_resolution (
bool、省略可能、デフォルトはTrue) — 有効にすると、出力予測は入力サイズに合わせてリサイズされます。無効にすると、出力の長い辺はprocessing_resolutionと等しくなります。 - resample_method_input (
str、任意、デフォルトは"bilinear") —processing_resolutionに入力画像をリサイズするために使用されるリサンプリング手法です。受け入れられる値は、"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - resample_method_output (
str、任意、デフォルトは"bilinear") — 出力予測をインプットの解像度に合わせるために使用されるリサンプリング手法です。受け入れられる値は"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - batch_size (
int、任意、デフォルトは1) — バッチサイズ。ensemble_sizeを設定する場合、または画像のテンソルを渡す場合にのみ関連します。 - ensembling_kwargs (
dict, 省略可, デフォルトはNone) — アンサンブルの制御を精密に行うための引数を含む追加の辞書。利用可能なオプションは以下の通りです:- reduction (
str、任意、デフォルトは"closest"): 各ピクセル位置に適用されるアンサンブル関数を定義します。"closest"または"mean"のいずれかを指定できます。
- reduction (
- latents (
torch.Tensor、任意、デフォルトはNone) — ランダム初期化に置き換えるための潜在ノイズテンソルです。これらは、直前の関数呼び出しの出力から取得できます。 - generator (
torch.Generator、またはlist[torch.Generator]、任意、デフォルトはNone) — 再現性を確保するための乱数生成器オブジェクト。 - output_type (
str、任意、デフォルトは"np") — 出力のpredictionおよび任意のuncertaintyフィールドの推奨フォーマット。受け入れられる値は、"np"(numpy 配列)または"pt"(torch テンソル)です。 - output_uncertainty (
bool、任意、デフォルトはFalse) — 有効にすると、ensemble_size引数が 2 より大きい値に設定されている場合、出力のuncertaintyフィールドに予測不確実性マップが含まれます。 - output_latent (
bool、任意、デフォルトはFalse) — 有効にすると、出力のlatentフィールドには、アンサンブル内の予測に対応する潜在コードが含まれます。これらのコードは保存・変更でき、latents引数を用いた後続の呼び出しに使用できます。 - return_dict (
bool、任意、デフォルトはTrue) —Trueの場合、通常のタプルではなく MarigoldNormalsOutput を返します。
戻り値
MarigoldNormalsOutput または tuple
return_dict が True の場合、MarigoldNormalsOutput が返され、それ以外の場合は tuple が返されます。このとき、最初の要素は予測値、2番目の要素は不確実性(または None)、3番目の要素は潜在変数(または None)です。
パイプラインを呼び出したときに実行される関数。
例:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
class diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
パラメータ
- prediction (
np.ndarray,torch.Tensor) — 値が [-1, 1] の範囲にある予測された法線ベクトル。torch.Tensorの場合はnumimages × 3 × height × width、np.ndarrayの場合はnumimages × height × width × 3の形状です。 - uncertainty (
None、np.ndarray、torch.Tensor) — アンサンブルから計算された不確実性マップで、値の範囲は [0, 1] です。torch.Tensorの場合は形状がnumimages × 1 × height × width、np.ndarrayの場合はnumimages × height × width × 1になります。 - latent (
None,torch.Tensor) — 予測に対応する潜在特徴量です。パイプラインのlatents引数と互換性があります。 形状はnumimages * numensemble × 4 × latentheight × latentwidthです。
Marigold単眼法線予測パイプライン用の出力クラス。
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
MarigoldNormalsPipeline の予測値などの法線ベクトルを可視化します。
戻り値: list[PIL.Image.Image] 表面法線の可視化を含むリスト。
Marigold 固有画像分解 API
class diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
パラメータ
- unet (
UNet2DConditionModel) — 画像の潜在変数に条件付けられ、ターゲットの潜在変数からノイズを除去するための条件付き U-Net です。 - vae (
AutoencoderKL) — 画像と予測を潜在表現にエンコードおよびデコードするための変分オートエンコーダ (VAE) モデル。 - scheduler (
DDIMSchedulerまたはLCMScheduler) —unetと組み合わせて、エンコードされた画像の潜在変数からノイズを除去するために使用するスケジューラです。 - text_encoder (
CLIPTextModel) — 空のテキスト埋め込み用のテキストエンコーダー。 - tokenizer (
CLIPTokenizer) — CLIPのトークナイザーです。 - prediction_type (
str、任意) — モデルが生成する予測の種類。 - target_properties (
dict[str, Any], 省略可) — 予測されるモーダリティの属性です。target_names(予測されるモーダリティの数、順序、名前を定義するために使用されるlist[str])や、予測結果を解釈するために必要なその他のメタデータなどが含まれます。 - default_denoising_steps (
int, 任意) — 指定されたモデルで、適切な品質の予測を生成するために必要な最小のデノイジング拡散ステップ数です。この値はモデルの設定で設定する必要があります。パイプラインを呼び出す際にnum_inference_stepsが明示的に設定されていない場合、このデフォルト値が使用されます。これにより、非常に短いデノイジングスケジュールに依存するLCMSchedulerや、完全な拡散スケジュールを持つDDIMSchedulerなど、パイプラインと互換性のあるさまざまなモデルバリエーションで、適切な結果が得られることが保証されます。 - default_processing_resolution (
int, 省略可) — パイプラインのprocessing_resolutionパラメータの推奨値です。この値はモデルの config に設定する必要があります。パイプラインを呼び出す際にprocessing_resolutionを明示的に設定しない場合、デフォルト値が使用されます。これは、最適な処理解像度が異なる各種モデルのバリエーションで、適切な結果を得るために必要です。
Marigold手法を用いた固有画像分解(IID)のパイプライン: https://marigoldcomputervision.github.io。
このモデルは DiffusionPipeline を継承しています。すべてのパイプラインに対してライブラリが実装している汎用的なメソッド(ダウンロードや保存、特定のデバイスでの実行など)については、スーパークラスのドキュメントを参照してください。
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
パラメータ
- image (
PIL.Image.Image、np.ndarray、torch.Tensor、list[PIL.Image.Image]、list[np.ndarray]、list[torch.Tensor]): 固有成分分解タスクの入力として使用する画像または画像のリストです。 配列やテンソルの場合、想定される値の範囲は[0, 1]です。4次元の配列またはテンソルを渡すことで、画像のバッチを渡すことができます。 また、2次元または3次元の配列またはテンソルからなる画像のリストを渡すことも可能です。後者の場合、リストのすべての要素は同じ幅と高さを有する必要があります。 - num_inference_steps (
int、任意、デフォルトはNone) — 推論時のデノイジング拡散ステップ数です。デフォルト値Noneの場合、自動的に選択されます。 - ensemble_size (
int、デフォルトは1) — アンサンブル予測の数です。値を大きくすると、測定可能な性能向上と視覚的な劣化が同時に生じます。 - processing_resolution (
int、任意、デフォルトはNone) — 実際の処理解像度です。0に設定すると、入力画像の大きい方の寸法に一致します。これにより予測がより鮮明になりますが、全体コンテキストの喪失につながる可能性もあります。デフォルト値Noneは、モデル設定から最適な値に解決されます。 - match_input_resolution (
bool、省略可能、デフォルトはTrue) — 有効にすると、出力予測は入力サイズに合わせてリサイズされます。無効にすると、出力の長い辺はprocessing_resolutionと等しくなります。 - resample_method_input (
str、任意、デフォルトは"bilinear") —processing_resolutionに入力画像をリサイズするために使用されるリサンプリング手法です。受け入れられる値は、"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - resample_method_output (
str、任意、デフォルトは"bilinear") — 出力予測をインプットの解像度に合わせるために使用されるリサンプリング手法です。受け入れられる値は"nearest"、"nearest-exact"、"bilinear"、"bicubic"、または"area"です。 - batch_size (
int、任意、デフォルトは1) — バッチサイズ。ensemble_sizeを設定する場合、または画像のテンソルを渡す場合にのみ関連します。 - ensembling_kwargs (
dict, 省略可, デフォルトはNone) — アンサンブルの制御を精密に行うための引数を含む追加の辞書。利用可能なオプションは以下の通りです:- reduction (
str、任意、デフォルトは"median"): 各ピクセル位置に適用されるアンサンブル関数を定義します。"median"または"mean"のいずれかを指定できます。
- reduction (
- latents (
torch.Tensor、任意、デフォルトはNone) — ランダム初期化に置き換えるための潜在ノイズテンソルです。これらは、直前の関数呼び出しの出力から取得できます。 - generator (
torch.Generator、またはlist[torch.Generator]、任意、デフォルトはNone) — 再現性を確保するための乱数生成器オブジェクト。 - output_type (
str、任意、デフォルトは"np") — 出力のpredictionおよび任意のuncertaintyフィールドの推奨フォーマット。受け入れられる値は、"np"(numpy 配列)または"pt"(torch テンソル)です。 - output_uncertainty (
bool、任意、デフォルトはFalse) — 有効にすると、ensemble_size引数が 2 より大きい値に設定されている場合、出力のuncertaintyフィールドに予測不確実性マップが含まれます。 - output_latent (
bool、任意、デフォルトはFalse) — 有効にすると、出力のlatentフィールドには、アンサンブル内の予測に対応する潜在コードが含まれます。これらのコードは保存・変更でき、latents引数を用いた後続の呼び出しに使用できます。 - return_dict (
bool、省略可能、デフォルトはTrue) —Trueの場合、通常のタプルではなく MarigoldIntrinsicsOutput を返します。
戻り値
MarigoldIntrinsicsOutput または tuple
return_dict が True の場合、MarigoldIntrinsicsOutput が返され、それ以外の場合は tuple が返されます。このとき、最初の要素は予測値、2番目の要素は不確実性(または None)、3番目の要素は潜在変数(または None)です。
パイプラインを呼び出したときに実行される関数。
例:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")class diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
パラメータ
- prediction (
np.ndarray、torch.Tensor) — 値が [0, 1] の範囲にある予測された画像の固有特性です。torch.Tensorの場合は(numimages * numtargets) × 3 × height × width、np.ndarrayの場合は(numimages * numtargets) × height × width × 3であり、numtargetsは固有画像分解の予測対象モダリティの数に対応します。 - uncertainty (
None,np.ndarray,torch.Tensor) — アンサンブルから計算された不確実性マップで、値の範囲は [0, 1] です。torch.Tensorの場合は形状が(numimages * numtargets) × 3 × height × width、np.ndarrayの場合は(numimages * numtargets) × height × width × 3になります。 - latent (
None,torch.Tensor) — 予測に対応する潜在特徴量です。パイプラインのlatents引数と互換性があります。 形状は(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidthです。
Marigold Intrinsic Image Decomposition パイプライン用の出力クラスです。
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dictcolor_map: str | dict[str, str] = 'binary' )
パラメータ
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — 固有画像分解。 - target_properties (
dict[str, Any]) — 分解プロパティ。期待されるエントリ:target_names: list[str]および、キーがprediction_space: str、sub_target_names: list[str | Null](3つのエントリが必要で、欠損モードは null)、up_to_scale: boolである辞書。各ターゲットおよびサブターゲットごとに1つ。 - color_map (
str | dict[str, str]、任意、デフォルトは"Spectral") — 単一チャネルの予測をカラー表現に変換するために使用されるカラーマップです。辞書が渡された場合、各モダリティを独自のカラーマップで色付けできます。
MarigoldIntrinsicsPipeline の予測など、固有画像分解を可視化します。
Returns: 固有画像分解の可視化を含むlist[dict[str, PIL.Image.Image]]