
Diffusers documentation
OmniGen
OmniGen
OmniGen: Unified Image Generation dari BAAI, oleh Shitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu.
Abstrak dari makalah tersebut adalah:
Kemunculan Large Language Models (LLMs) telah menyatukan tugas-tugas generasi bahasa dan merevolusi interaksi manusia-mesin. Namun, dalam ranah generasi gambar, model terpadu yang mampu menangani berbagai tugas dalam satu kerangka kerja masih belum banyak dieksplorasi. Dalam karya ini, kami memperkenalkan OmniGen, sebuah model difusi baru untuk generasi gambar terpadu. OmniGen dicirikan oleh fitur-fitur berikut: 1) Penyatuan: OmniGen tidak hanya menunjukkan kemampuan generasi teks-ke-gambar, tetapi juga secara inheren mendukung berbagai tugas turunan, seperti pengeditan gambar, generasi yang digerakkan oleh subjek, dan generasi kondisional visual. 2) Kesederhanaan: Arsitektur OmniGen sangat disederhanakan, menghilangkan kebutuhan akan plugin tambahan. Selain itu, dibandingkan dengan model difusi yang ada, model ini lebih ramah pengguna dan dapat menyelesaikan tugas kompleks secara end-to-end melalui instruksi tanpa memerlukan langkah-langkah perantara tambahan, sehingga sangat menyederhanakan alur kerja generasi gambar. 3) Transfer Pengetahuan: Berkat pembelajaran dalam format terpadu, OmniGen secara efektif mentransfer pengetahuan antar tugas yang berbeda, mengelola tugas dan domain yang belum pernah dilihat, serta menunjukkan kemampuan baru. Kami juga mengeksplorasi kemampuan penalaran model dan potensi aplikasi mekanisme chain-of-thought. Karya ini merupakan upaya pertama untuk model generasi gambar serbaguna, dan kami akan merilis sumber daya kami di https://github.com/VectorSpaceLab/OmniGen untuk mendorong kemajuan di masa depan.
Pastikan untuk melihat panduan Schedulers untuk mempelajari cara mengeksplorasi tradeoff antara kecepatan dan kualitas scheduler, serta lihat bagian reuse components across pipelines untuk mempelajari cara memuat komponen yang sama secara efisien ke dalam beberapa pipeline.
Pipeline ini disumbangkan oleh staoxiao. Basis kode aslinya dapat ditemukan di sini. Bobot aslinya dapat ditemukan di bawah hf.co/shitao.
Muat checkpoint model
Bobot model mungkin disimpan di subfolder terpisah di Hub atau secara lokal, dalam hal ini, Anda harus menggunakan metode from_pretrained().
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", dtype=torch.bfloat16)
Teks-ke-gambar
Untuk teks-ke-gambar, berikan prompt teks. Secara default, OmniGen menghasilkan gambar berukuran 1024x1024.
Anda dapat mencoba mengatur parameter height dan width untuk menghasilkan gambar dengan ukuran yang berbeda.
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Realistic photo. A young woman sits on a sofa, holding a book and facing the camera. She wears delicate silver hoop earrings adorned with tiny, sparkling diamonds that catch the light, with her long chestnut hair cascading over her shoulders. Her eyes are focused and gentle, framed by long, dark lashes. She is dressed in a cozy cream sweater, which complements her warm, inviting smile. Behind her, there is a table with a cup of water in a sleek, minimalist blue mug. The background is a serene indoor setting with soft natural light filtering through a window, adorned with tasteful art and flowers, creating a cozy and peaceful ambiance. 4K, HD."
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=3,
    generator=torch.Generator(device="cpu").manual_seed(111),
).images[0]
image.save("output.png")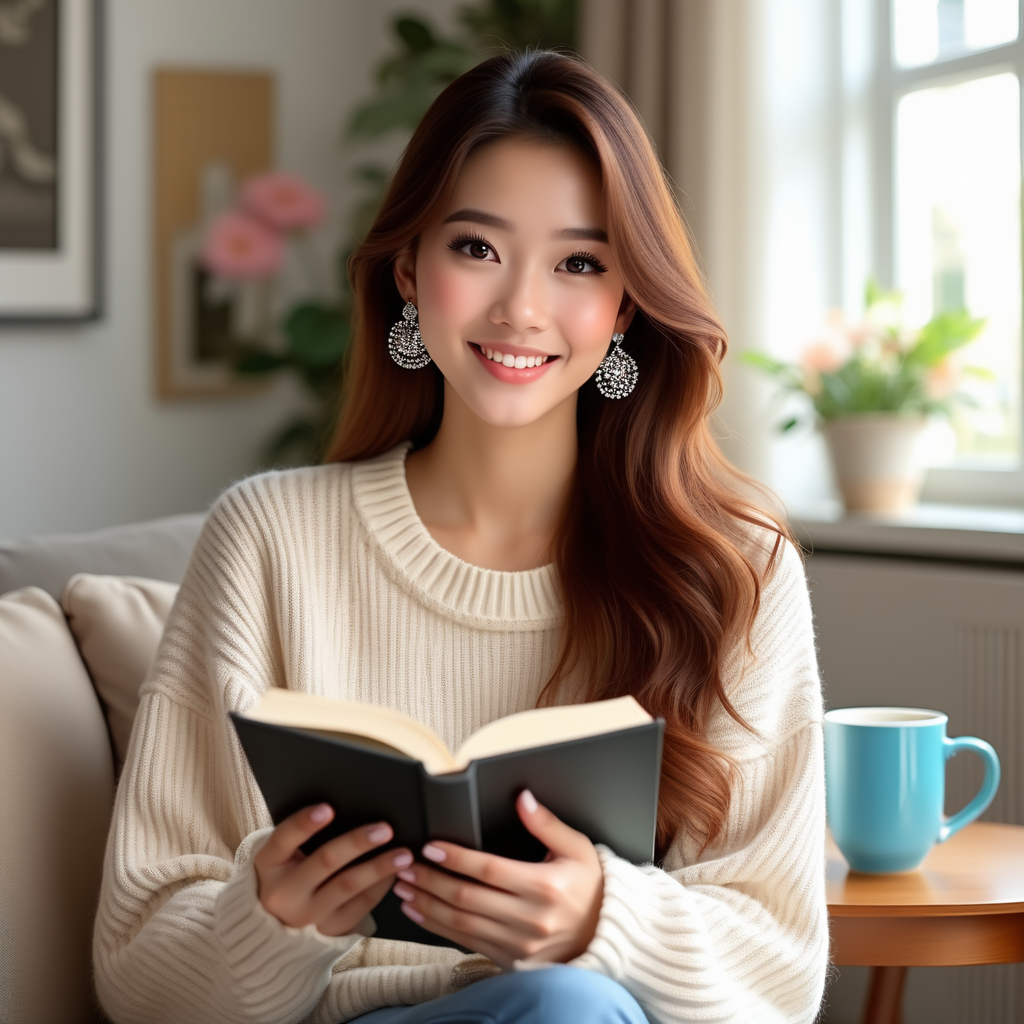
Edit gambar
OmniGen mendukung input multimodal.
Ketika input mencakup gambar, Anda perlu menambahkan placeholder <img><|image_1|></img> dalam prompt teks untuk mewakili gambar tersebut.
Disarankan untuk mengaktifkan use_input_image_size_as_output agar ukuran gambar yang diedit tetap sama dengan ukuran gambar aslinya.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="<img><|image_1|></img> Remove the woman's earrings. Replace the mug with a clear glass filled with sparkling iced cola."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/t2i_woman_with_book.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(222)
).images[0]
image.save("output.png") 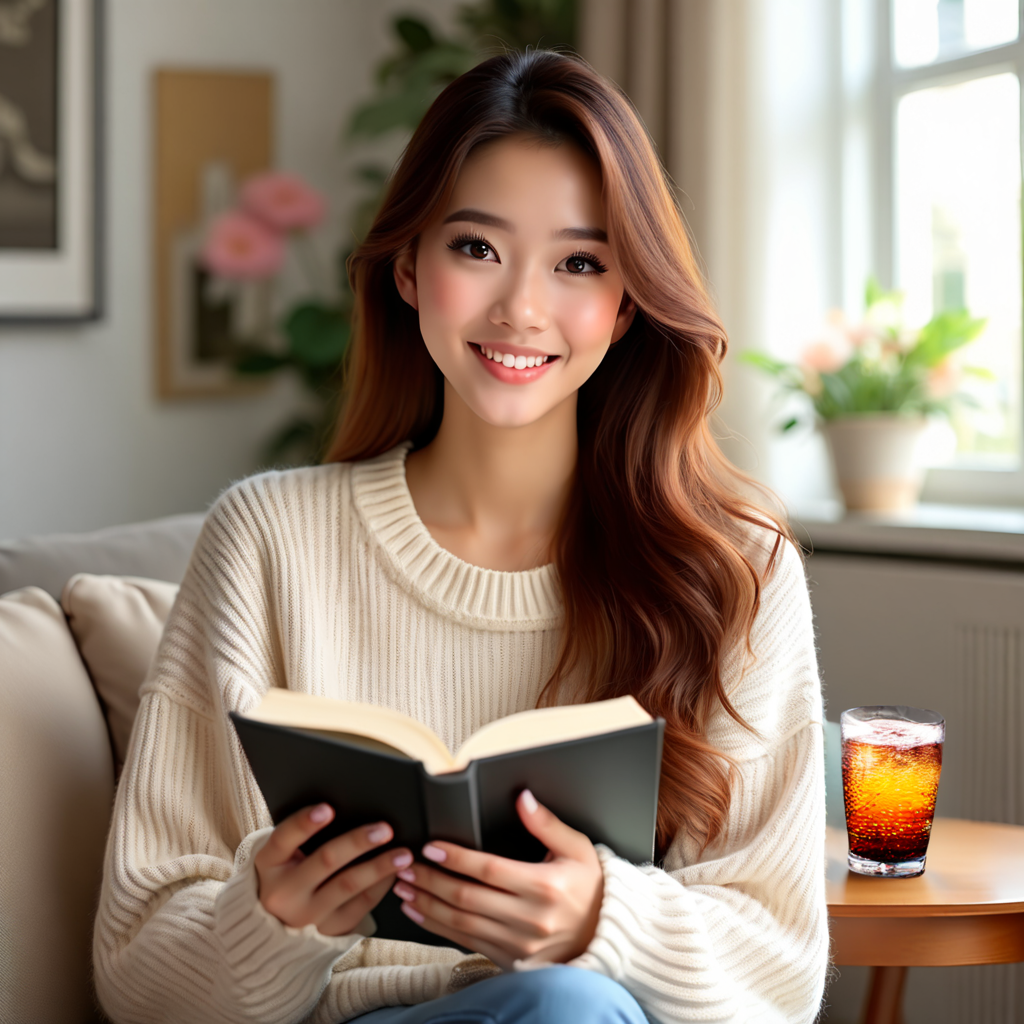
OmniGen memiliki beberapa fitur menarik, seperti penalaran visual, seperti yang ditunjukkan pada contoh di bawah ini.
prompt="If the woman is thirsty, what should she take? Find it in the image and highlight it in blue. <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")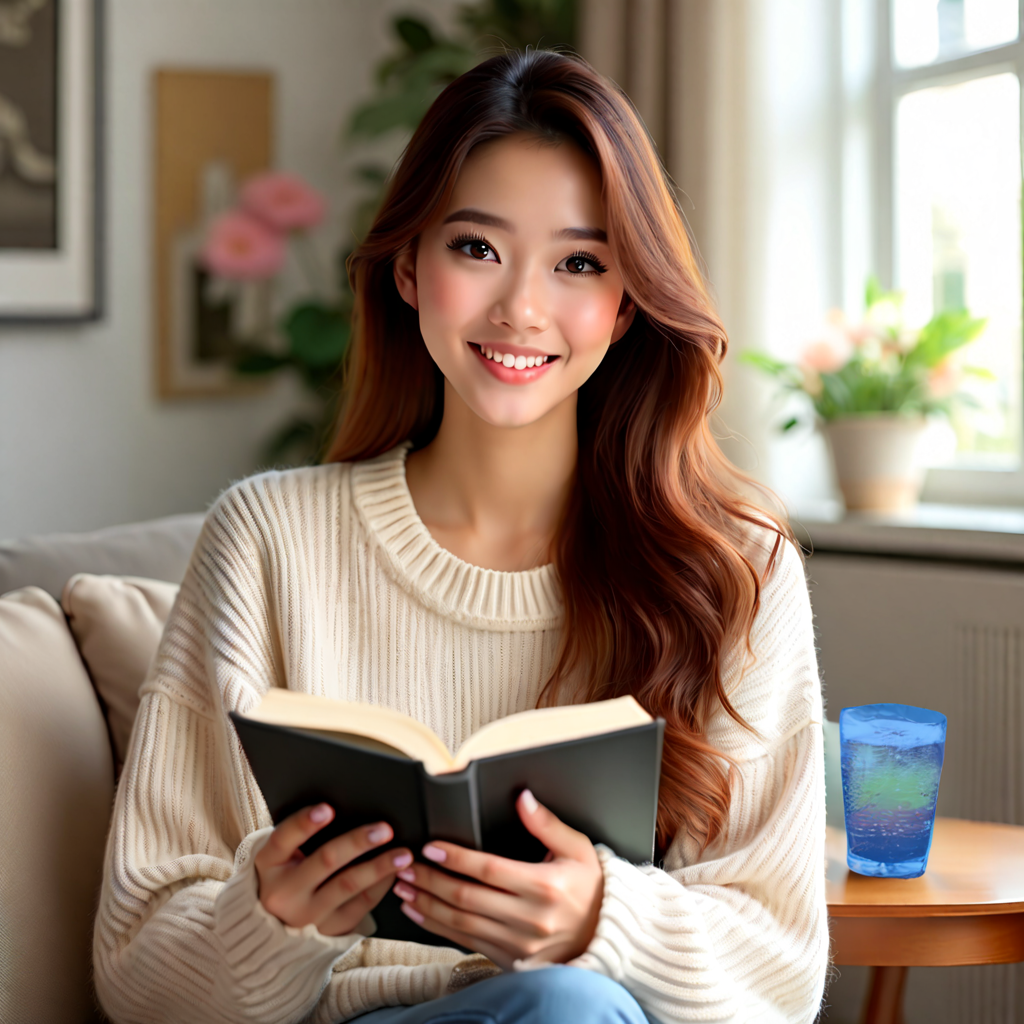
Generasi yang dapat dikendalikan
OmniGen dapat menangani beberapa tugas computer vision klasik. Seperti yang ditunjukkan di bawah, OmniGen dapat mendeteksi kerangka manusia pada gambar input, yang dapat digunakan sebagai kondisi kontrol untuk menghasilkan gambar baru.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Detect the skeleton of human in this image: <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image1 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image1.save("image1.png")

prompt="Generate a new photo using the following picture and text as conditions: <img><|image_1|></img>\n A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/skeletal.png")]
image2 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image2.save("image2.png") 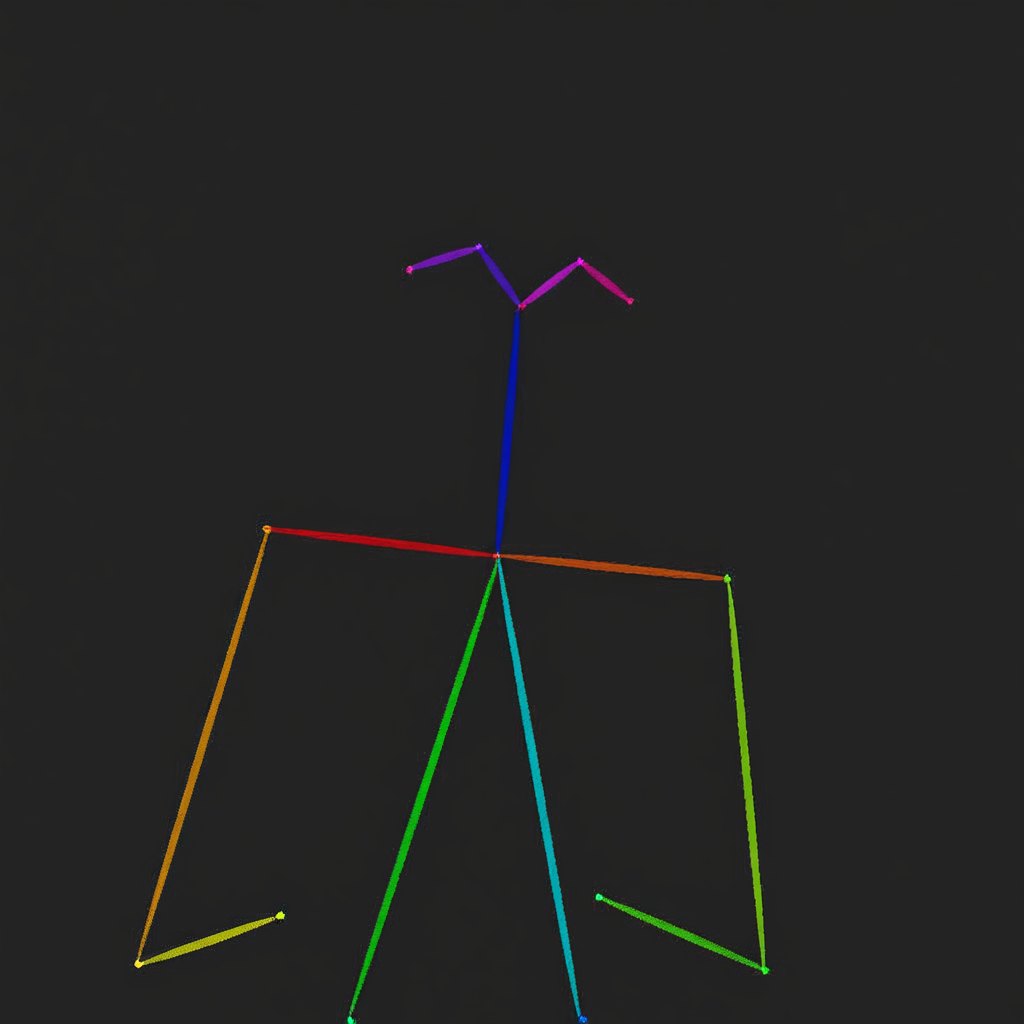
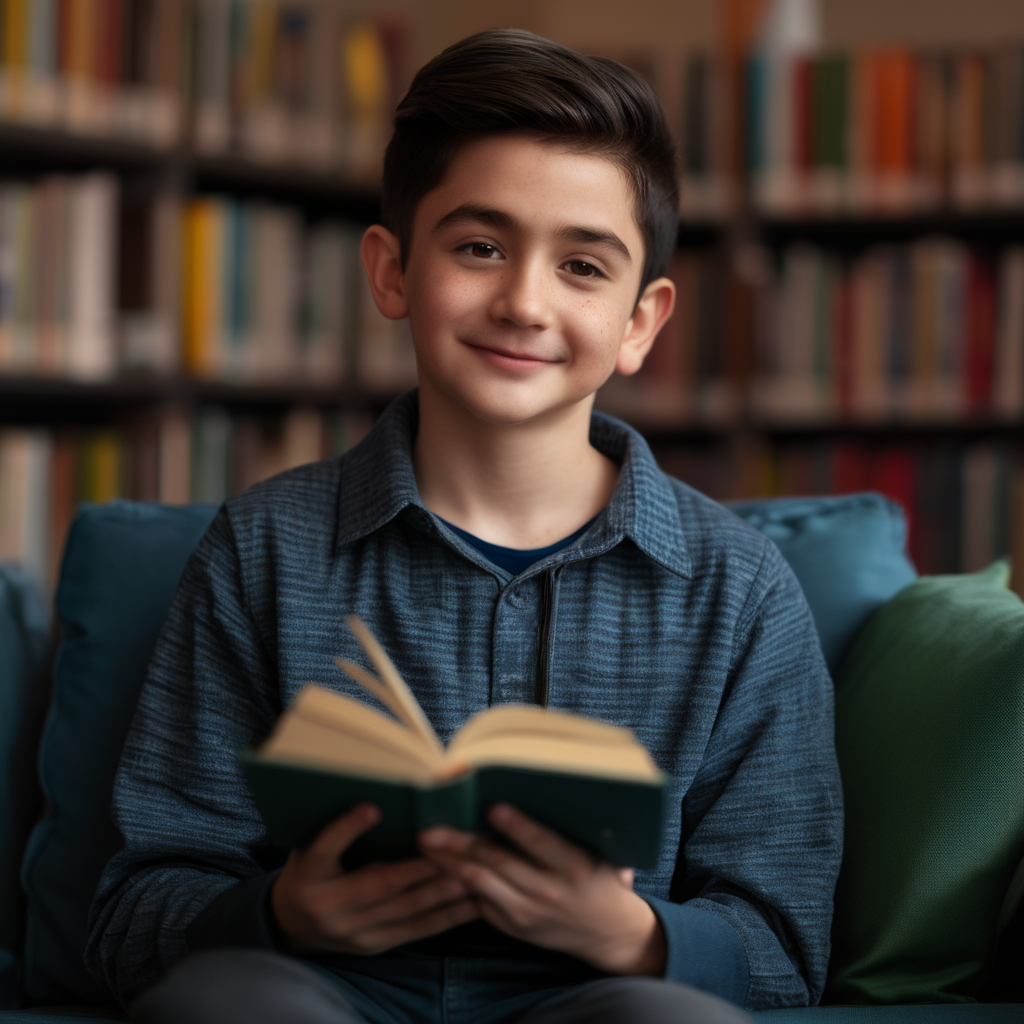
OmniGen juga dapat langsung menggunakan informasi relevan dari gambar input untuk menghasilkan gambar baru.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Following the pose of this image <img><|image_1|></img>, generate a new photo: A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")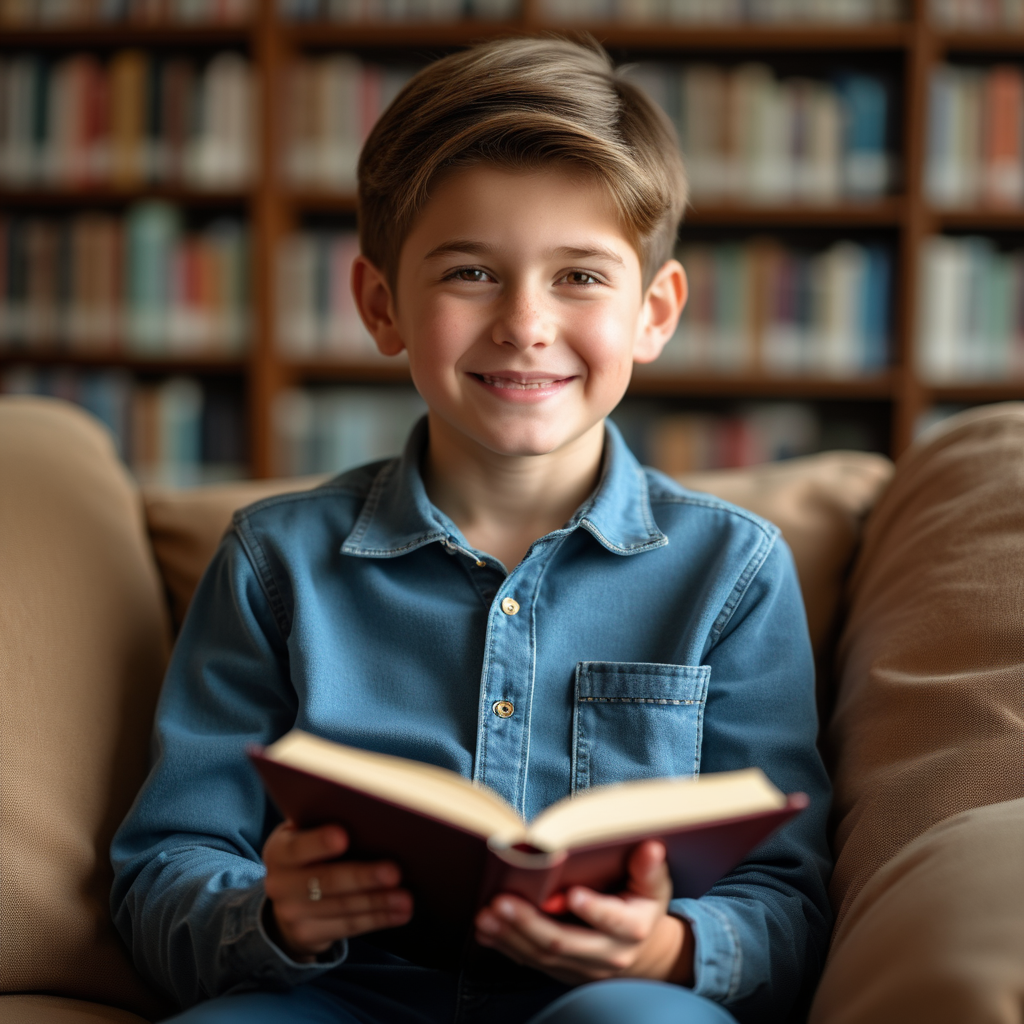
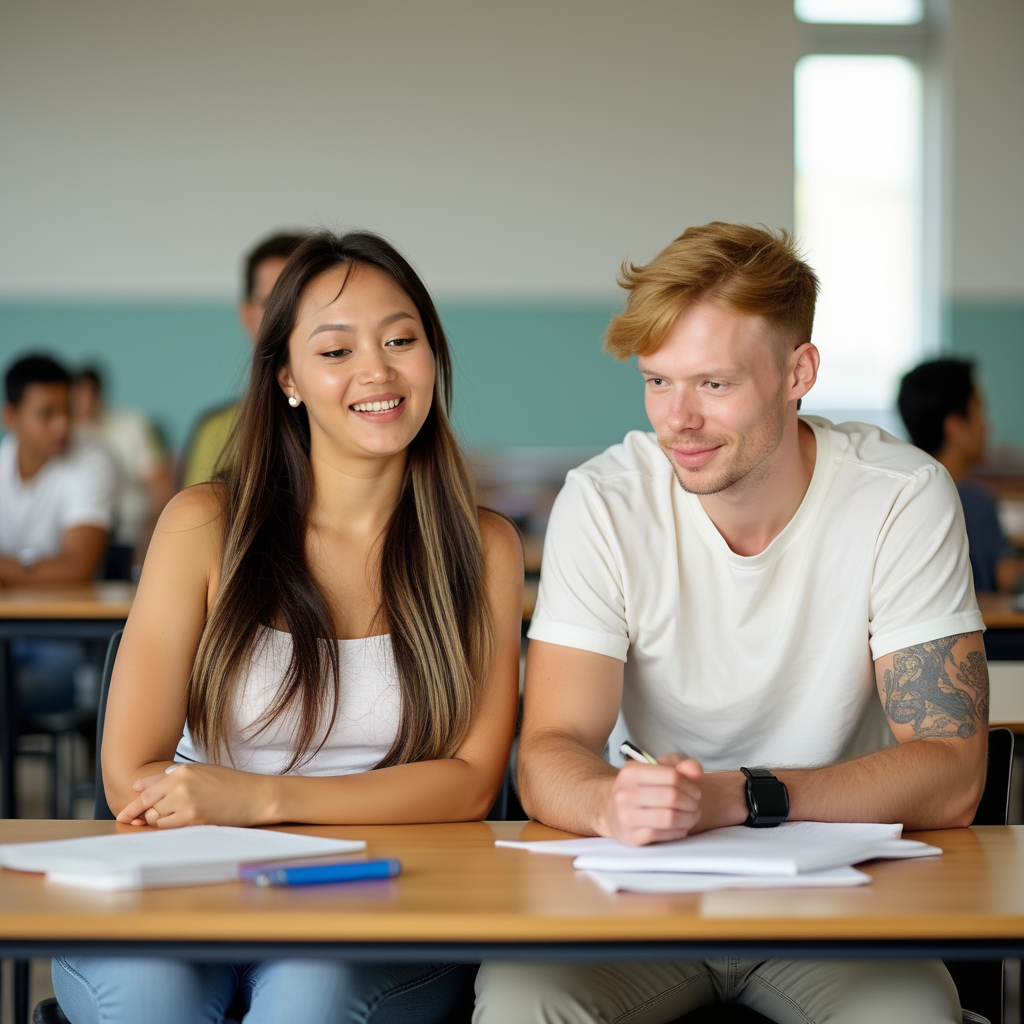
ID dan objek yang dipertahankan
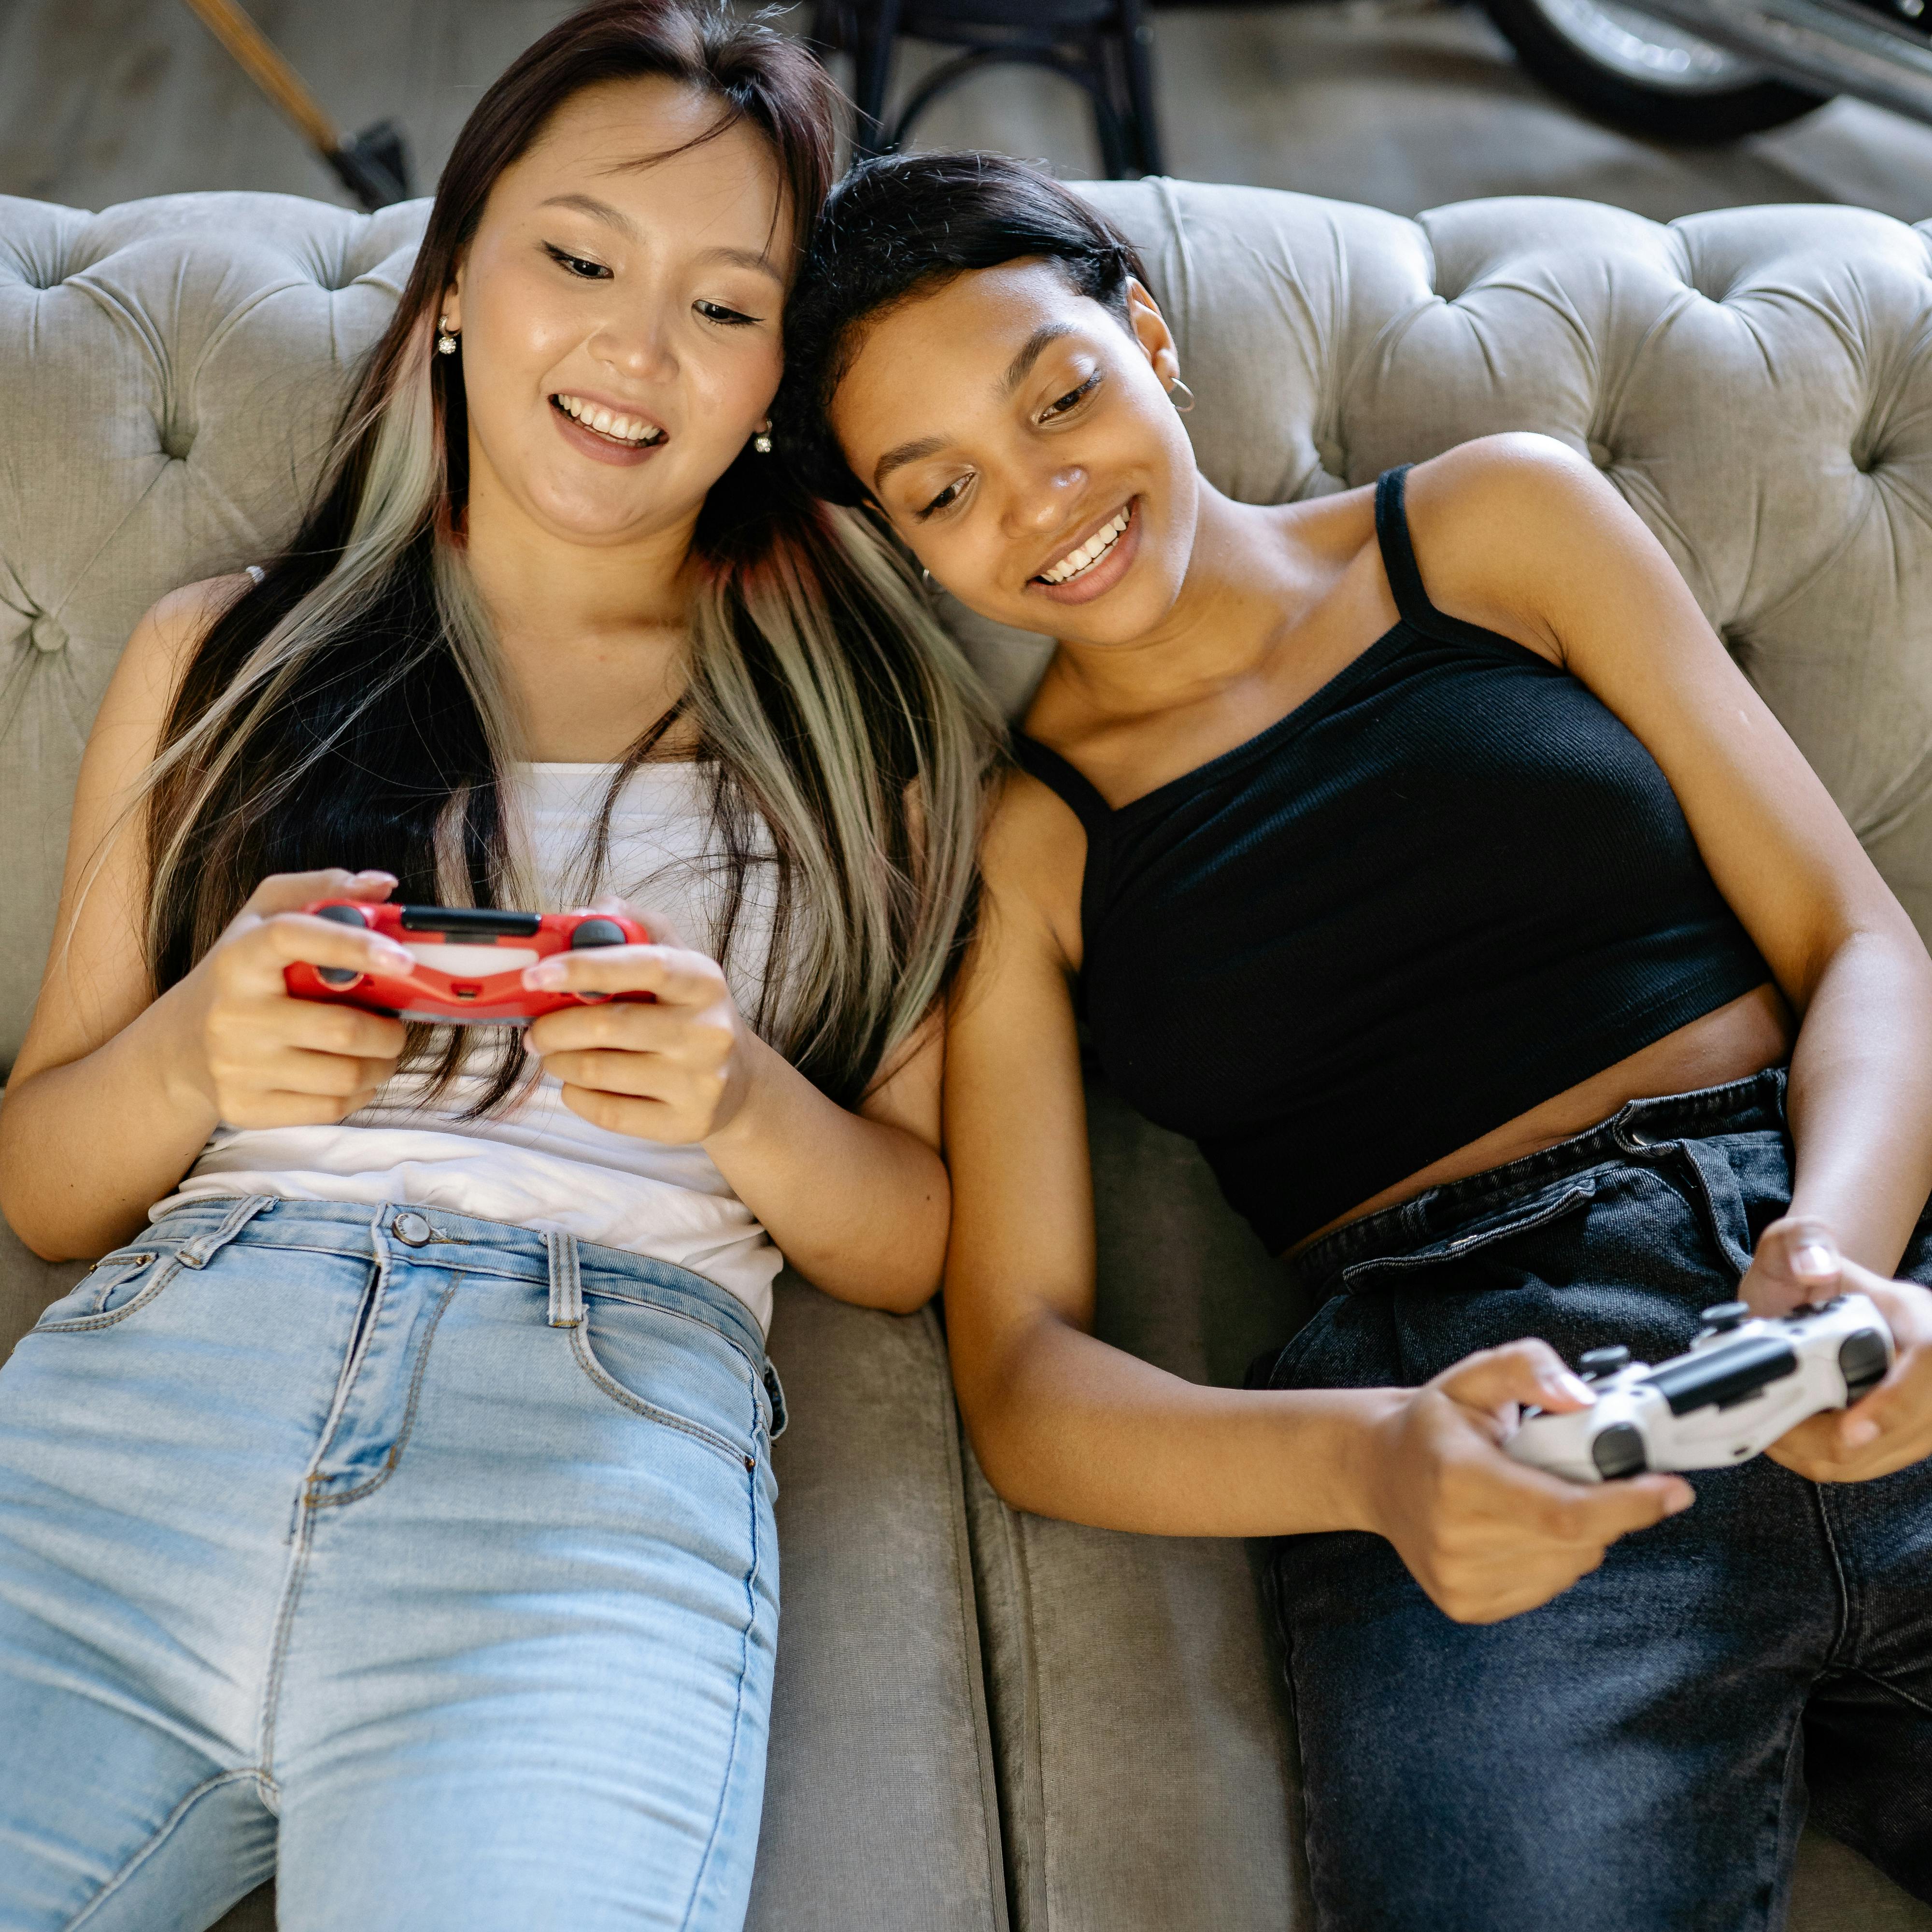
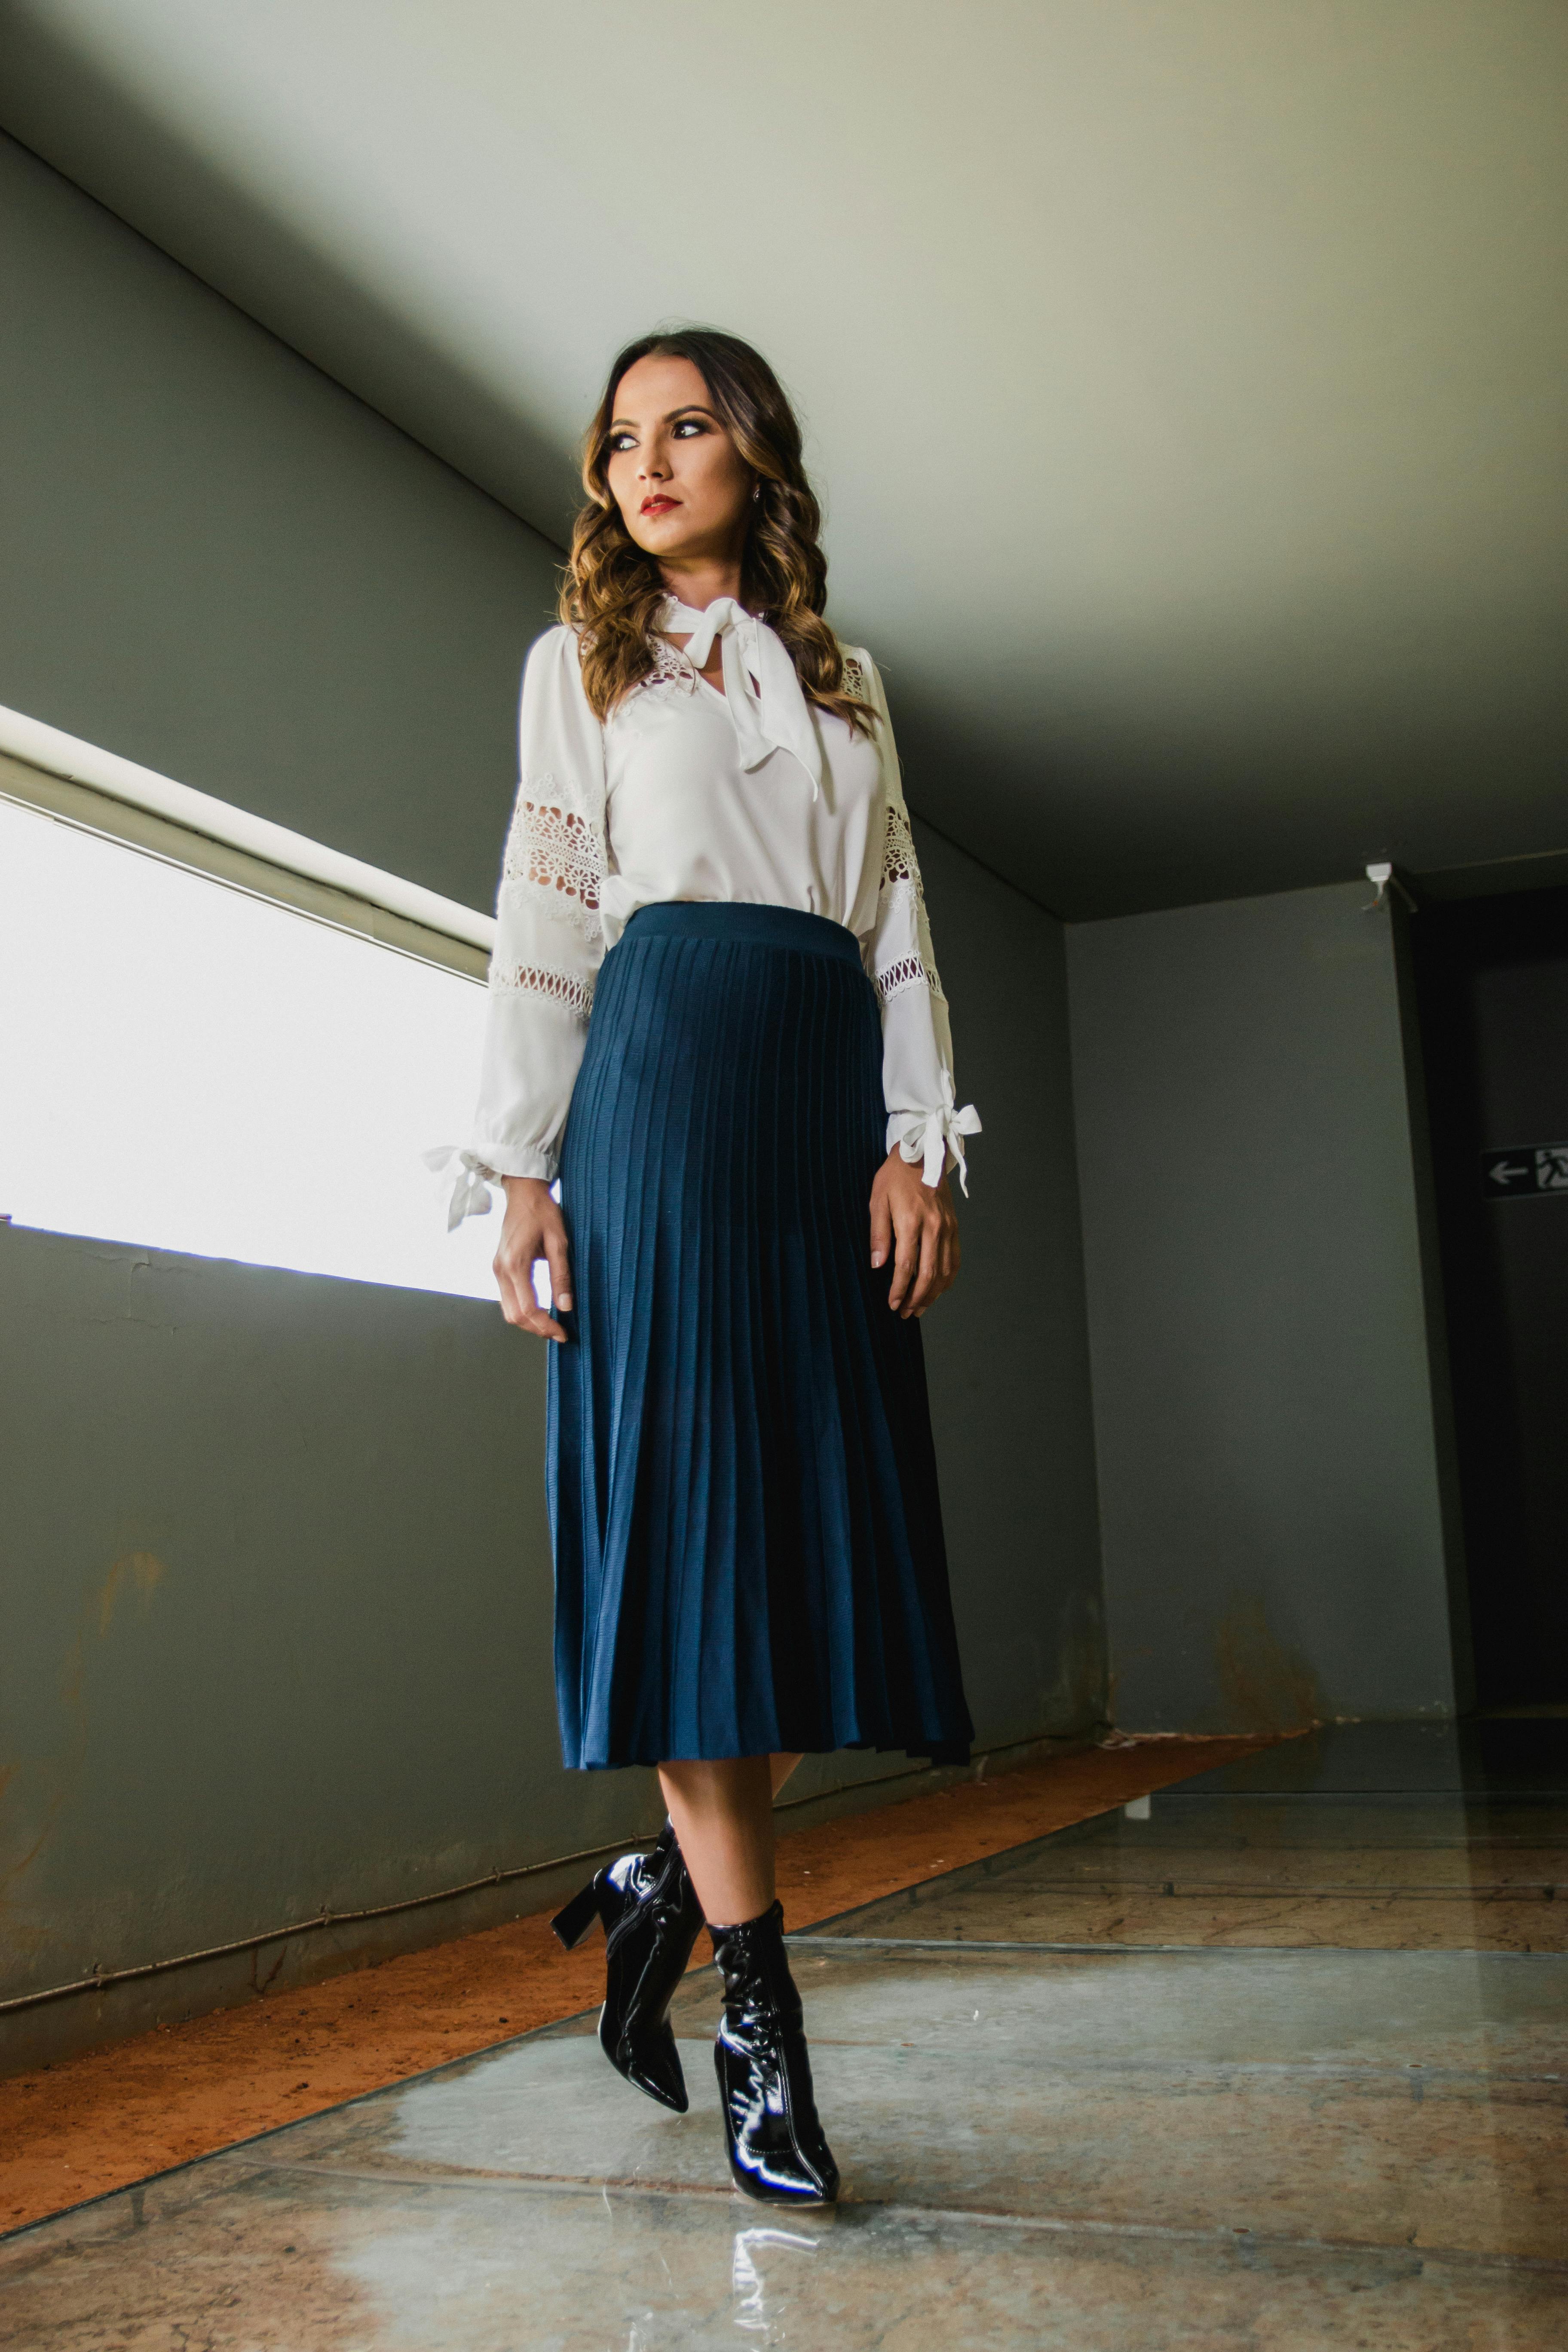
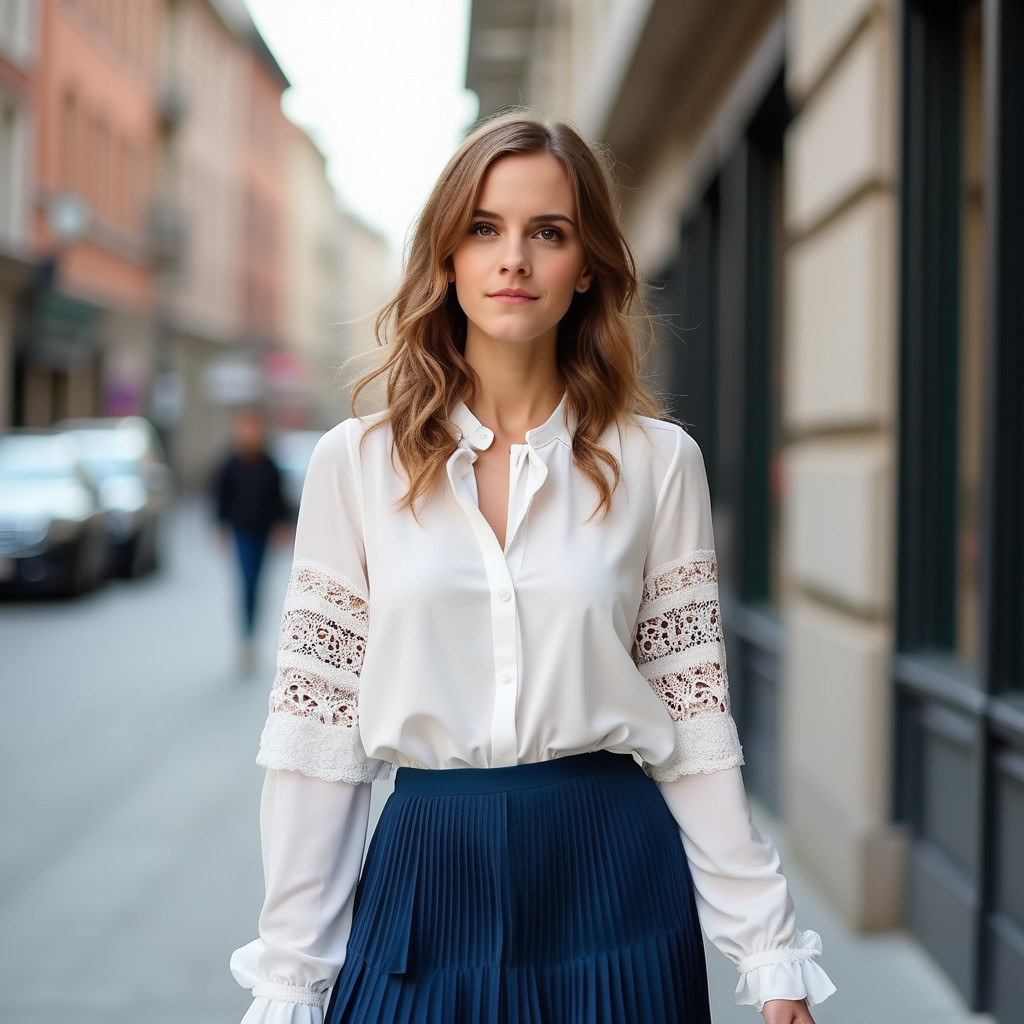
OmniGen dapat menghasilkan beberapa gambar berdasarkan orang dan objek dalam gambar input serta mendukung input beberapa gambar secara bersamaan. Selain itu, OmniGen dapat mengekstrak objek yang diinginkan dari gambar yang berisi beberapa objek berdasarkan instruksi.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>"
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/3.png")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/4.png")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")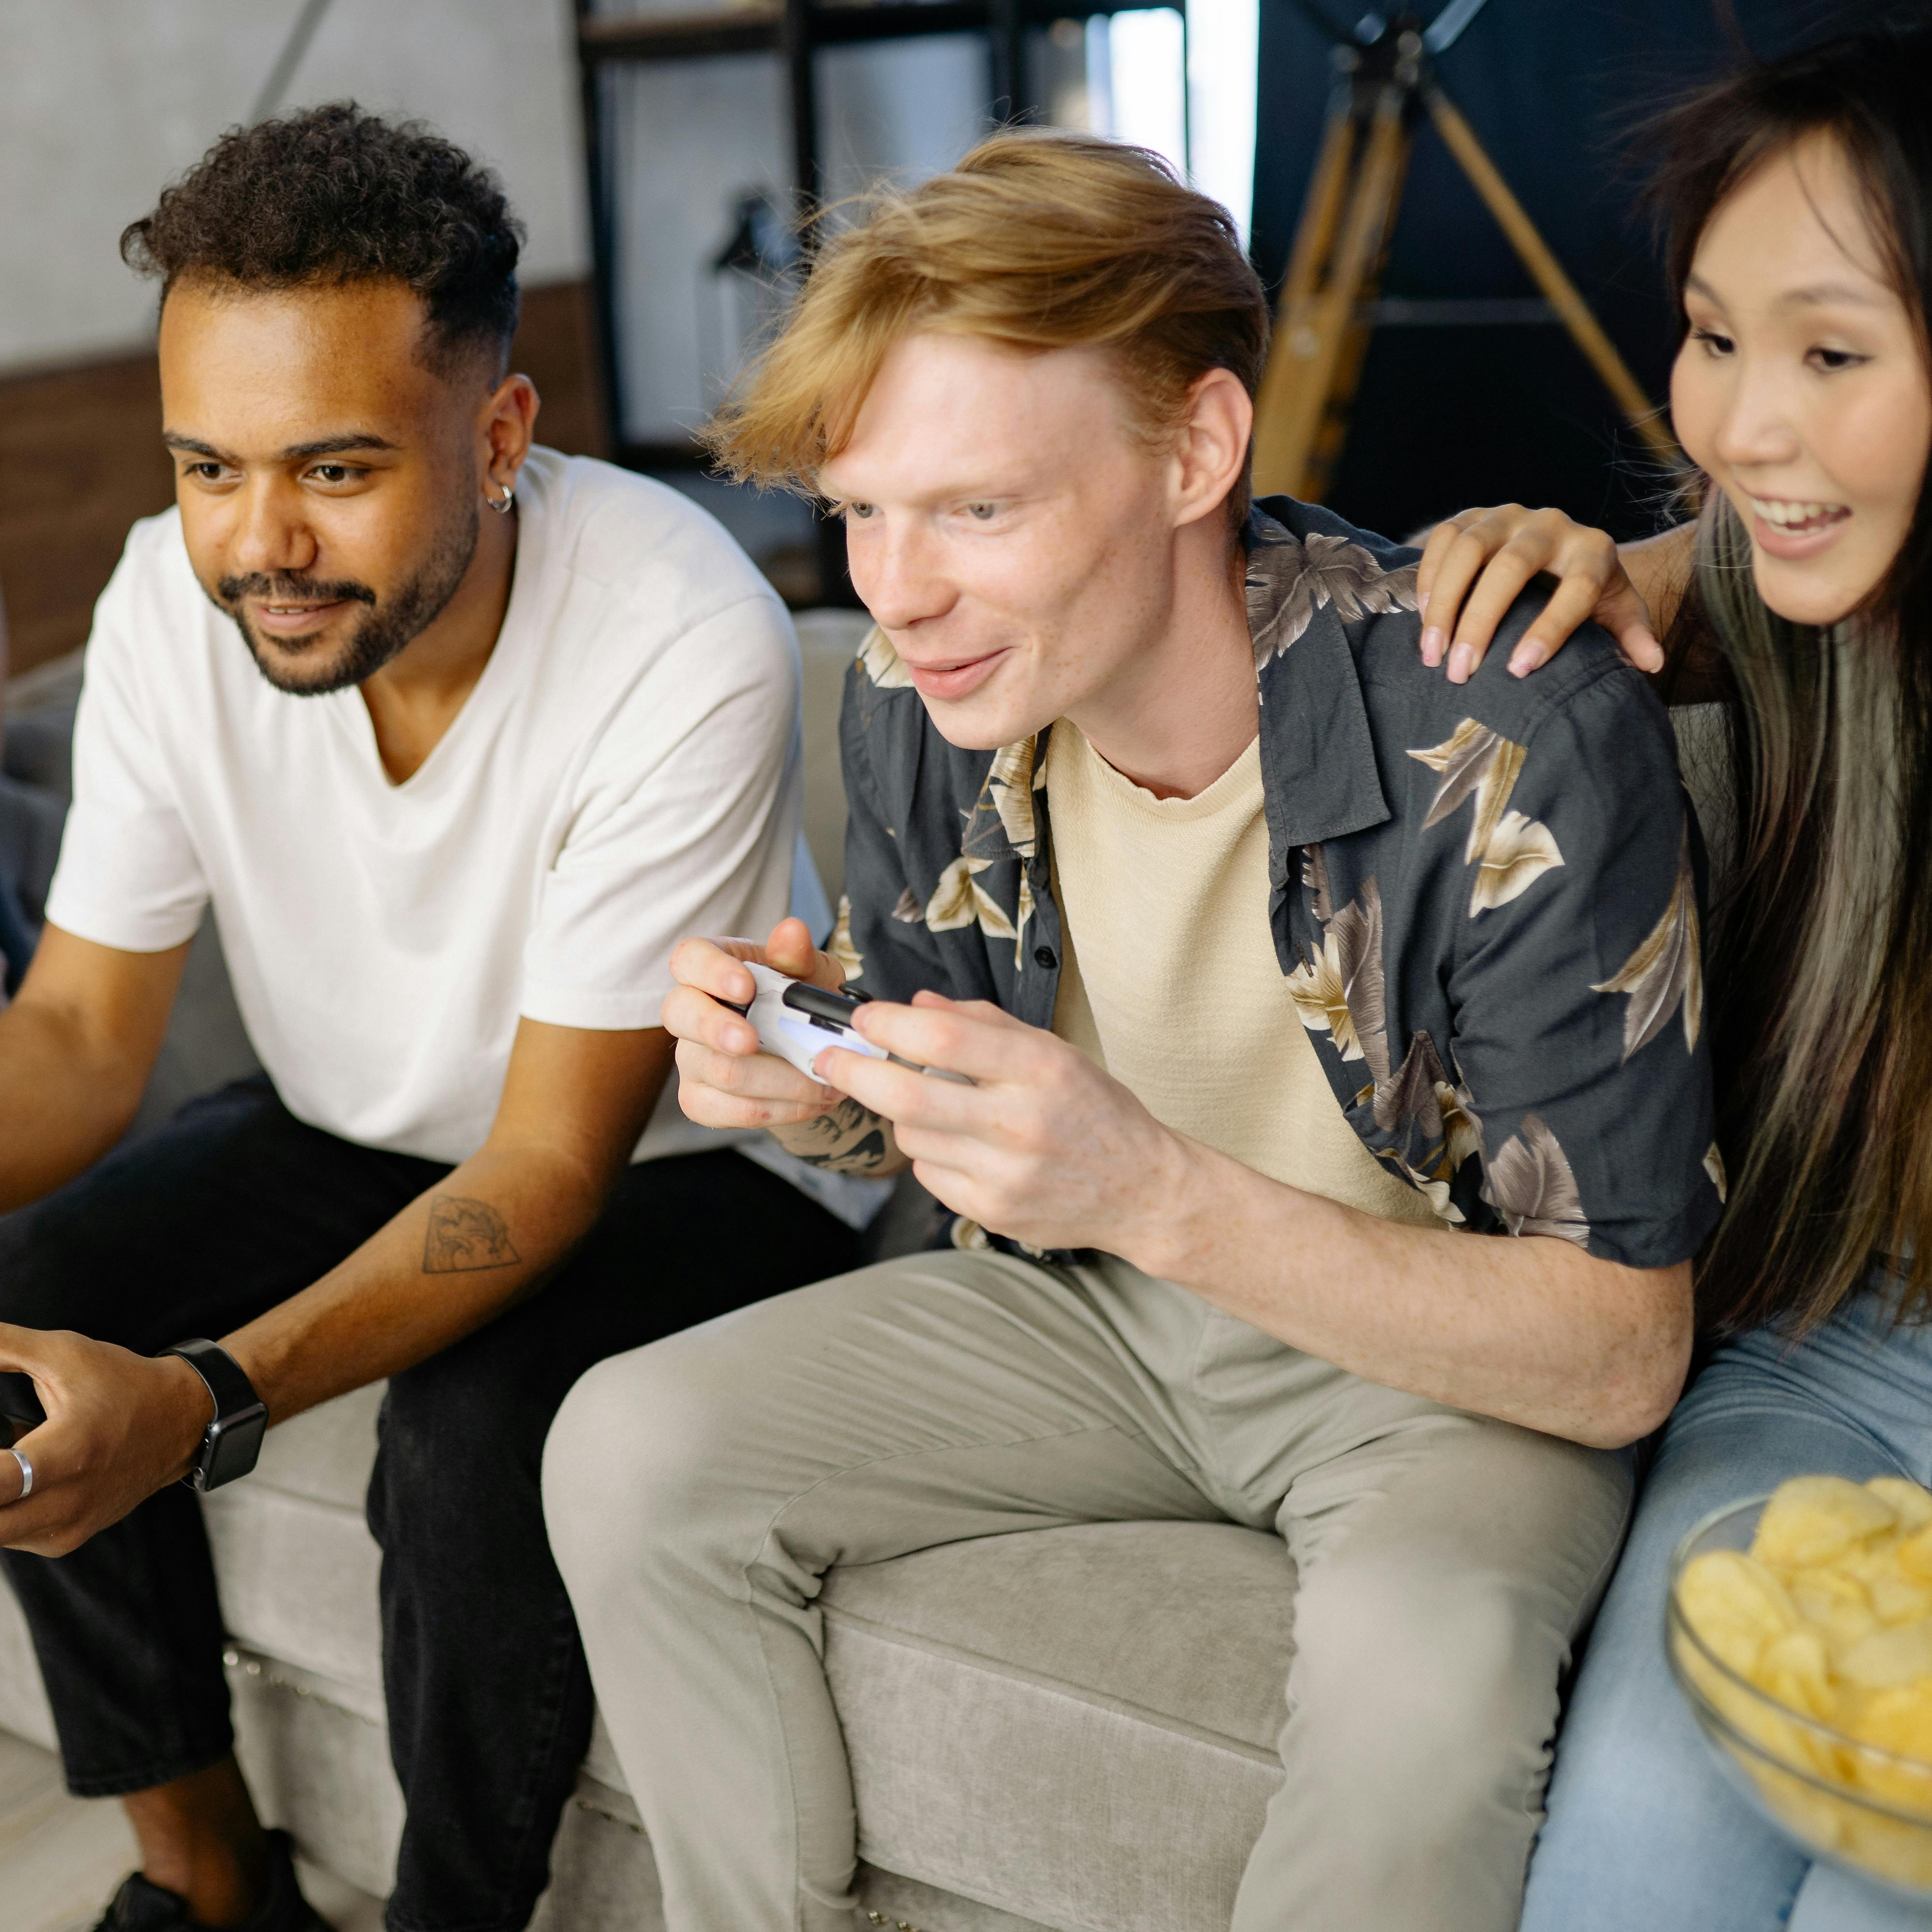
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="A woman is walking down the street, wearing a white long-sleeve blouse with lace details on the sleeves, paired with a blue pleated skirt. The woman is <img><|image_1|></img>. The long-sleeve blouse and a pleated skirt are <img><|image_2|></img>."
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/emma.jpeg")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/dress.jpg")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")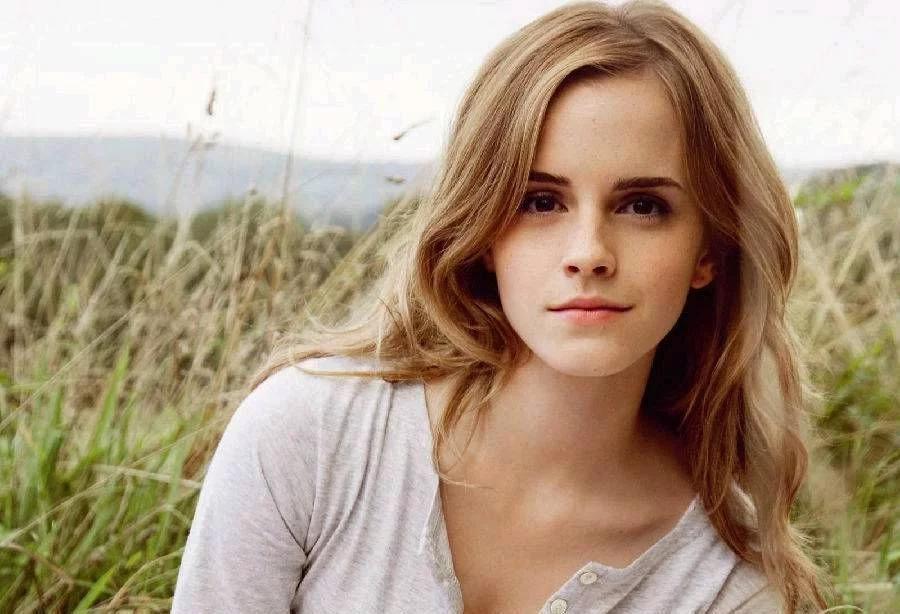
Optimasi saat menggunakan beberapa gambar
Untuk tugas teks-ke-gambar, OmniGen membutuhkan biaya memori dan waktu yang minimal (9GB memori dan 31 detik untuk gambar 1024x1024 pada GPU A800). Namun, saat menggunakan gambar sebagai input, biaya komputasi meningkat.
Berikut adalah beberapa pedoman untuk membantu Anda mengurangi biaya komputasi saat menggunakan beberapa gambar. Eksperimen dilakukan pada GPU A800 dengan dua gambar input.
Seperti pipeline lainnya, Anda dapat mengurangi penggunaan memori dengan melakukan offload model: pipe.enable_model_cpu_offload() atau pipe.enable_sequential_cpu_offload().
Di OmniGen, Anda juga dapat mengurangi overhead komputasi dengan mengurangi max_input_image_size.
Konsumsi memori untuk berbagai ukuran gambar ditunjukkan pada tabel di bawah:
| Metode | Penggunaan Memori |
|---|---|
| max_input_image_size=1024 | 40GB |
| max_input_image_size=512 | 17GB |
| max_input_image_size=256 | 14GB |
OmniGenPipeline
kelas diffusers.OmniGenPipeline
< source >( transformer: OmniGenTransformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtokenizer: LlamaTokenizer )
Parameter
- transformer (OmniGenTransformer2DModel) — Arsitektur Transformer autoregressive untuk OmniGen.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Scheduler yang digunakan bersama
transformeruntuk menghilangkan noise pada latens gambar yang telah dikodekan. - vae (AutoencoderKL) — Model Variational Auto-Encoder (VAE) untuk mengodekan dan mendekodekan gambar ke dan dari representasi laten.
- tokenizer (
LlamaTokenizer) — Tokenizer teks dari kelas LlamaTokenizer.
Pipeline OmniGen untuk generasi dari multimodal ke gambar.
Referensi: https://huggingface.co/papers/2409.11340
__call__
< source >( prompt: str | list[str]input_images: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50max_input_image_size: int = 1024timesteps: list = Noneguidance_scale: float = 2.5img_guidance_scale: float = 1.6use_input_image_size_as_output: bool = Falsenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents'] ) → ImagePipelineOutput or tuple
Parameter
- prompt (
strataulist[str], opsional) — Prompt atau prompt-prompt untuk memandu generasi gambar. Jika input mencakup gambar, perlu menambahkan placeholder<img><|image_i|></img>dalam prompt untuk menunjukkan posisi gambar ke-i. - input_images (
PipelineImageInputataulist[PipelineImageInput], opsional) — Daftar gambar input. Kami akan mengganti ”<|image_i|>” dalam prompt dengan gambar ke-i dalam daftar. - height (
int, opsional, defaultnya self.unet.config.sample_size * self.vae_scale_factor) — Tinggi gambar yang dihasilkan dalam piksel. Nilai ini secara default diatur ke 1024 untuk hasil terbaik. - width (
int, opsional, defaultnya self.unet.config.sample_size * self.vae_scale_factor) — Lebar gambar yang dihasilkan dalam piksel. Ini diatur ke 1024 secara default untuk hasil terbaik. - num_inference_steps (
int, opsional, default 50) — Jumlah langkah denoising. Semakin banyak langkah denoising, biasanya menghasilkan gambar dengan kualitas lebih tinggi, namun dengan biaya inferensi yang lebih lambat. - max_input_image_size (
int, opsional, default 1024) — ukuran maksimum gambar input, yang akan digunakan untuk memotong gambar input ke ukuran maksimum - timesteps (
list[int], opsional) — Timesteps kustom untuk digunakan dalam proses denoising dengan scheduler yang mendukung argumentimestepsdi metodeset_timestepsmereka. Jika tidak didefinisikan, perilaku default saatnum_inference_stepsdilewatkan akan digunakan. Harus dalam urutan menurun. - guidance_scale (
float, opsional, default 2.5) — Skala panduan seperti yang didefinisikan dalam Classifier-Free Diffusion Guidance.guidance_scaledidefinisikan sebagaiwdari persamaan 2. dari Imagen Paper. Skala panduan diaktifkan dengan mengaturguidance_scale > 1. Skala panduan yang lebih tinggi mendorong generasi gambar yang sangat terkait denganpromptteks, biasanya dengan mengorbankan kualitas gambar yang lebih rendah. - img_guidance_scale (
float, opsional, default 1.6) — Didefinisikan sebagai persamaan 3 dalam Instrucpix2pix. - use_input_image_size_as_output (bool, defaultnya False) — apakah akan menggunakan ukuran gambar input sebagai ukuran gambar output, yang dapat digunakan untuk input gambar tunggal, misalnya, tugas pengeditan gambar
- num_images_per_prompt (
int, opsional, default 1) — Jumlah gambar yang akan dihasilkan per prompt. - generator (
torch.Generatorataulist[torch.Generator], opsional) — Satu atau daftar generator torch untuk membuat proses generasi menjadi deterministik. - latents (
torch.Tensor, opsional) — Latents berisik yang telah dibuat sebelumnya, diambil dari distribusi Gaussian, untuk digunakan sebagai input untuk generasi gambar. Dapat digunakan untuk menyesuaikan generasi yang sama dengan prompt yang berbeda. Jika tidak disediakan, tensor latents akan dibuat dengan pengambilan sampel menggunakangeneratoracak yang diberikan. - output_type (
str, opsional, defaultnya"pil") — Format output dari generate image. Pilih antara PIL:PIL.Image.Imageataunp.array. - return_dict (
bool, opsional, defaultTrue) — Apakah akan mengembalikan~pipelines.flux.FluxPipelineOutputalih-alih tuple biasa. - callback_on_step_end (
Callable, opsional) — Fungsi yang dipanggil di akhir setiap langkah denoising selama inferensi. Fungsi ini dipanggil dengan argumen berikut:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsakan berisi daftar semua tensor sesuai yang ditentukan olehcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opsional) — Daftar input tensor untuk fungsicallback_on_step_end. Tensor yang ditentukan dalam daftar akan diteruskan sebagai argumencallback_kwargs. Anda hanya dapat menyertakan variabel yang tercantum dalam atribut._callback_tensor_inputsdari kelas pipeline Anda.
Mengembalikan
ImagePipelineOutput atau tuple
ImagePipelineOutput jika return_dict bernilai True,
sebaliknya berupa tuple. Saat mengembalikan tuple, elemen pertama adalah daftar berisi gambar yang dihasilkan.
Fungsi yang dipanggil saat memanggil pipeline untuk generasi.
Contoh:
>>> import torch
>>> from diffusers import OmniGenPipeline

>>> pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")

>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=50, guidance_scale=2.5).images[0]
>>> image.save("output.png")
Mengembalikan: ImagePipelineOutput atau tuple:
Jika return_dict adalah True, ImagePipelineOutput dikembalikan, selain itu sebuah tuple dikembalikan
di mana elemen pertama adalah daftar dengan gambar yang dihasilkan.
encode_input_images
< source >( input_pixel_values: listdevice: typing.Optional[torch.device] = Nonedtype: typing.Optional[torch.dtype] = None )
mendapatkan embedding lanjutan dari gambar input oleh VAE
Mengembalikan: torch.Tensor