# LeViT
## Genel Bakış
LeViT modeli, Ben Graham, Alaaeldin El-Nouby, Hugo Touvron, Pierre Stock, Armand Joulin, Hervé Jégou ve Matthijs Douze tarafından [LeViT: Introducing Convolutions to Vision Transformers](https://huggingface.co/papers/2104.01136) makalesinde önerilmiştir. LeViT, Transformers içinde azalan çözünürlüklere sahip aktivasyon haritaları ve konumsal bilgiyi entegre etmek için dikkat sapmasının (attention bias) tanıtılması gibi birkaç mimari farklılık sayesinde [Vision Transformer (ViT)](vit)'ın performansını ve verimliliğini artırır.
Makalenin özeti aşağıdaki gibidir:
*Yüksek hız rejiminde doğruluk ve verimlilik arasındaki ödünleşimi optimize eden bir görüntü sınıflandırma mimarileri ailesi tasarlıyoruz. Çalışmamız, yüksek derecede paralel işlem donanımlarında rekabetçi olan dikkat tabanlı mimarilerdeki son bulguları kullanıyor. Geniş konvolüsyonel sinir ağları literatüründeki ilkeleri, özellikle azalan çözünürlüklere sahip aktivasyon haritalarıyla birlikte, transformer'lara uygulamak için yeniden inceliyoruz. Ayrıca, görme transformer'larında konumsal bilgiyi entegre etmenin yeni bir yolu olan dikkat sapmasını (attention bias) tanıtıyoruz. Sonuç olarak, hızlı çıkarım görüntü sınıflandırması için hibrit bir sinir ağı olan LeVIT'i öneriyoruz. Geniş bir uygulama senaryosu yelpazesini en iyi şekilde yansıtmak amacıyla, farklı donanım platformlarında verimliliğin farklı ölçülerini dikkate alıyoruz. Kapsamlı deneylerimiz, teknik seçimlerimizi ampirik olarak doğruluyor ve bunların çoğu mimari için uygun olduğunu gösteriyor. Genel olarak, LeViT, hız/doğruluk ödünleşimi açısından mevcut konvnet'leri ve görme transformer'larını önemli ölçüde geride bırakıyor. Örneğin, %80 ImageNet top-1 doğruluğunda LeViT, CPU üzerinde EfficientNet'den 5 kat daha hızlıdır.*
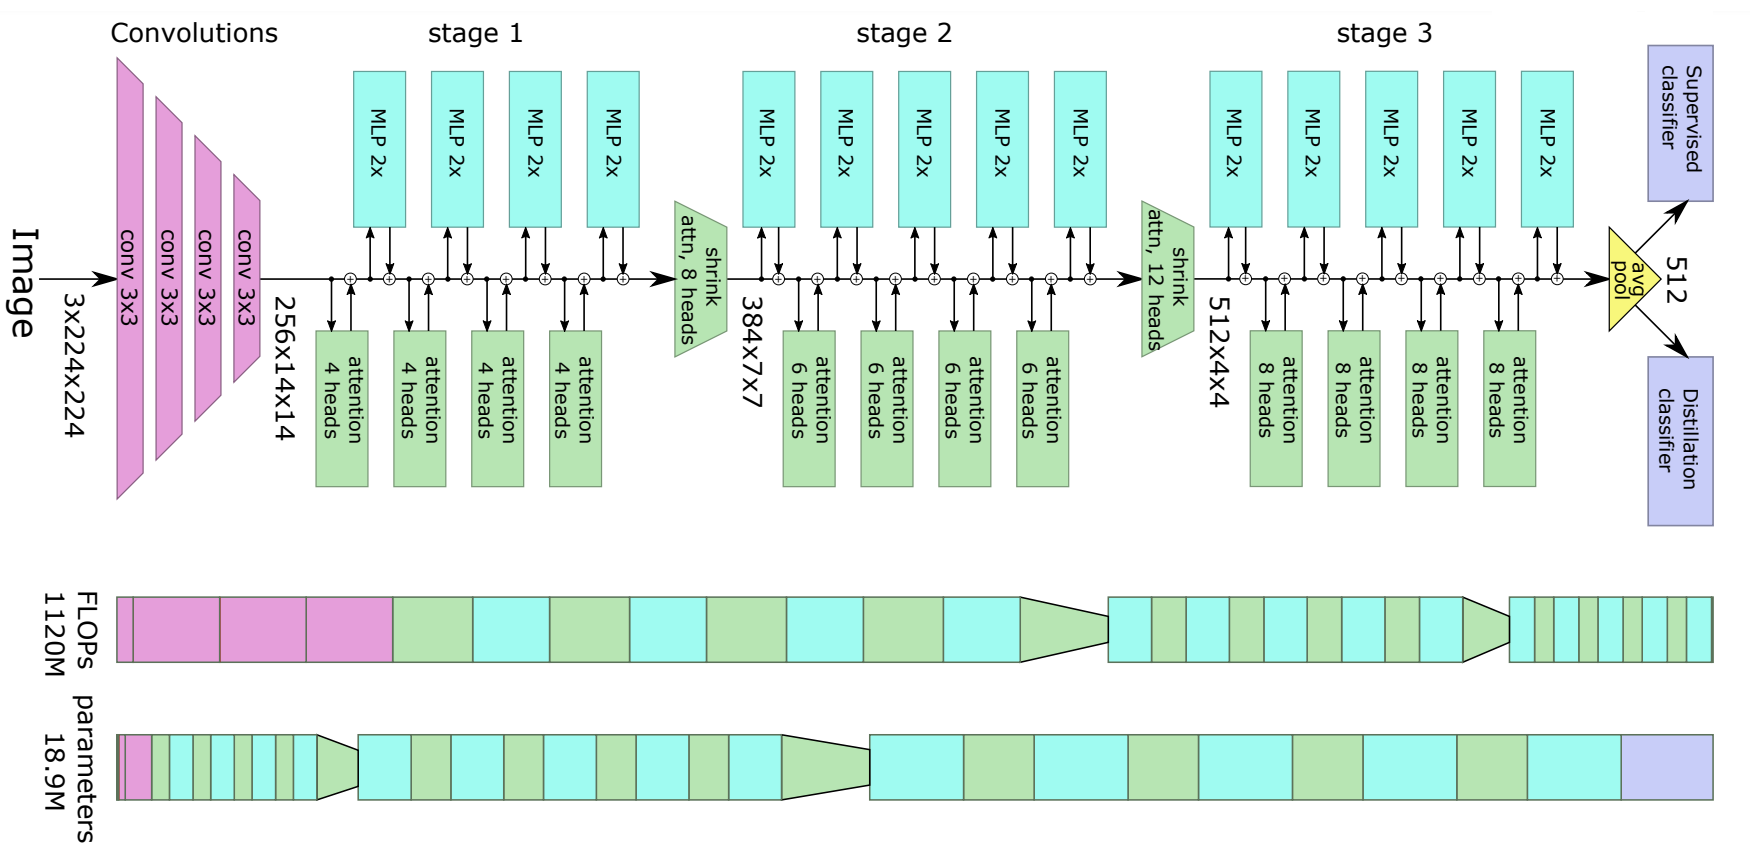 LeViT Mimarisi. Orijinal makaleden alınmıştır.
Bu model [anugunj](https://huggingface.co/anugunj) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/facebookresearch/LeViT) bulunabilir.
## Kullanım ipuçları
- ViT ile karşılaştırıldığında, LeViT modelleri, bir öğretmenden (LeViT makalesinde bu, ResNet benzeri bir modeldir) etkili bir şekilde öğrenmek için ek bir damıtma başlığı kullanır. Damıtma başlığı, ResNet benzeri bir modelin gözetiminde geri yayılım yoluyla öğrenilir. Ayrıca, verimliliği artırmak için azalan çözünürlüklere sahip aktivasyon haritaları kullanmak üzere konvolüsyonel sinir ağlarından ilham alırlar.
- Damıtılmış modelleri ince ayar yapmak için 2 yol vardır: (1) klasik yöntem, yani son gizli durumun üzerine yalnızca bir tahmin kafası yerleştirilir ve damıtma kafası kullanılmaz; veya (2) son gizli durumun üzerine hem bir tahmin kafası hem de bir damıtma kafası yerleştirilir. Bu durumda, tahmin kafası, kafanın tahmini ile doğru etiket arasındaki normal çapraz entropi kullanılarak eğitilirken, damıtma tahmin kafası sert damıtma (damıtma kafasının tahmini ile öğretmenin tahmin ettiği etiket arasındaki çapraz entropi) kullanılarak eğitilir. Çıkarım sırasında, son tahmin olarak her iki kafanın tahminlerinin ortalaması alınır. (2) yöntemi, aşağı akış veri setinde zaten ince ayarı yapılmış bir öğretmene dayanıldığı için "damıtma ile ince ayar" olarak da adlandırılır. Modeller açısından, (1) [LevitForImageClassification](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassification) ile, (2) ise [LevitForImageClassificationWithTeacher](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) ile eşleşir.
- Yayınlanan tüm kontrol noktaları yalnızca [ImageNet-1k](https://huggingface.co/datasets/ILSVRC/imagenet-1k) (aynı zamanda ILSVRC 2012 olarak da bilinir, 1,3 milyon görüntü ve 1.000 sınıf içeren bir koleksiyon) üzerinde ön eğitilmiş ve ince ayarlanmıştır. Harici veri kullanılmamıştır. Bu, ön eğitim için JFT-300M veri seti/Imagenet-21k gibi harici veriler kullanan orijinal ViT modelinden farklıdır.
- LeViT'nin yazarları, [LevitModel](/docs/transformers/main/tr/model_doc/levit#transformers.LevitModel) veya [LevitForImageClassification](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassification) içine doğrudan yerleştirilebilecek 5 eğitilmiş LeViT modeli yayımladı. Veri artırma, optimizasyon ve düzenleme gibi teknikler, yalnızca ön eğitim için ImageNet-1k kullanılırken çok daha büyük bir veri setinde eğitim yapmayı simüle etmek amacıyla kullanıldı. Kullanılabilir 5 varyant (tümü 224x224 boyutundaki görüntülerde eğitildi): *facebook/levit-128S*, *facebook/levit-128*, *facebook/levit-192*, *facebook/levit-256* ve *facebook/levit-384*. Model için görüntüleri hazırlamak üzere [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanılması gerektiğini unutmayın.
- [LevitForImageClassificationWithTeacher](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) şu anda yalnızca çıkarımı (inference) destekler; eğitim veya ince ayar (fine-tuning) desteklenmez.
- Ön çıkarım ve özel verilerde ince ayar ile ilgili demo defterlerine [buradan](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) erişebilirsiniz ([ViTImageProcessor](/docs/transformers/main/tr/model_doc/vit#transformers.ViTImageProcessor) yerine [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) ve [ViTForImageClassification](/docs/transformers/main/tr/model_doc/vit#transformers.ViTForImageClassification) yerine [LevitForImageClassification](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassification) veya [LevitForImageClassificationWithTeacher](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) kullanmanız yeterlidir).
## Kaynaklar
LeViT ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- [LevitForImageClassification](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassification), bu [defter](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) tarafından desteklenmektedir.
- Bkz: [Görsel sınıflandırma görevi kılavuzu](../tasks/image_classification)
Buraya bir kaynak eklemek isterseniz, lütfen bir Pull Request açmaktan çekinmeyin; inceleyeceğiz! Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şeyi göstermesi beklenir.
## LevitConfig[[transformers.LevitConfig]]
#### transformers.LevitConfig[[transformers.LevitConfig]]
```python
transformers.LevitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, num_channels: int = 3, kernel_size: int = 3, stride: int = 2, padding: int = 1, patch_size: int | list[int] | tuple[int, int] = 16, hidden_sizes: list[int] | tuple[int, ...] = (128, 256, 384), num_attention_heads: list[int] | tuple[int, ...] = (4, 8, 12), depths: list[int] | tuple[int, ...] = (4, 4, 4), key_dim: list[int] | tuple[int, ...] = (16, 16, 16), drop_path_rate: int = 0, mlp_ratio: list[int] | tuple[int, ...] = (2, 2, 2), attention_ratio: list[int] | tuple[int, ...] = (2, 2, 2), initializer_range: float = 0.02)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/configuration_levit.py#L24)
**Parametreler:**
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `224`) : Her bir görüntünün boyutu (çözünürlüğü).
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
kernel_size (`int`, *isteğe bağlı*, varsayılan `3`) : Konvolüsyon çekirdeğinin boyutu.
stride (`int`, *opsiyonel*, varsayılan 2) : Yama gömme (patch embedding) için başlangıçtaki konvolüsyon katmanlarının adım (stride) boyutu.
padding (`int`, *opsiyonel*, varsayılan 1) : Yama gömme (patch embedding) için başlangıçtaki konvolüsyon katmanlarının dolgu (padding) boyutu.
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *isteğe bağlı*, varsayılan `(128, 256, 384)`) : Modelin her aşamasındaki boyut (gizli boyut).
num_attention_heads (`Union[list[int], tuple[int, ...]]`, *isteğe bağlı*, varsayılan `(4, 8, 12)`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
depths (`Union[list[int], tuple[int, ...]]`, *isteğe bağlı*, varsayılan `(4, 4, 4)`) : Transformer'daki her katmanın derinliği.
key_dim (`list[int]`, *isteğe bağlı*, varsayılan `[16, 16, 16]`) : Her kodlayıcı bloğundaki anahtarın boyutu.
drop_path_rate (`int`, *opsiyonel*, varsayılan `0`) : Yama füzyonu için drop path oranı.
mlp_ratio (`Union[list[int], tuple[int, ...]]`, *isteğe bağlı*, varsayılan `(2, 2, 2)`) : MLP gizli boyutunun gömme boyutuna oranı.
attention_ratio (`list[int]`, *isteğe bağlı*, varsayılan `[2, 2, 2]`) : Dikkat katmanlarında çıktı boyutunun giriş boyutuna oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
Bu, bir LevitModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Levit modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [facebook/levit-128S](https://huggingface.co/facebook/levit-128S) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import LevitConfig, LevitModel
>>> # Initializing a LeViT levit-128S style configuration
>>> configuration = LevitConfig()
>>> # Initializing a model (with random weights) from the levit-128S style configuration
>>> model = LevitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LevitImageProcessor[[transformers.LevitImageProcessor]]
#### transformers.LevitImageProcessor[[transformers.LevitImageProcessor]]
```python
transformers.LevitImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_levit.py#L33)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `None`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
LevitImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.LevitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
#### transformers.LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
```python
transformers.LevitImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_pil_levit.py#L32)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `None`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
LevitImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.LevitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## LevitModel[[transformers.LevitModel]]
#### transformers.LevitModel[[transformers.LevitModel]]
```python
transformers.LevitModel(config: LevitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L489)
**Parametreler:**
config ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumları (hidden-states) üreten çıplak Levit Modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.LevitModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L498)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LevitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanır).
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/main/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
**Dönüş:** `BaseModelOutputWithPoolingAndNoAttention` veya `tuple(torch.Tensor)`
A `BaseModelOutputWithPoolingAndNoAttention` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[LevitModel](/docs/transformers/main/tr/model_doc/levit#transformers.LevitModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, num_channels, height, width)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Uzamsal boyutlar üzerinde bir havuzlama işlemi uygulandıktan sonraki son katman gizli durumu.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, num_channels, height, width)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
Örnek:
```python
```
## LevitForImageClassification[[transformers.LevitForImageClassification]]
#### transformers.LevitForImageClassification[[transformers.LevitForImageClassification]]
```python
transformers.LevitForImageClassification(config: LevitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L542)
**Parametreler:**
config ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üstünde bir görüntü sınıflandırma kafası (toplanmış özelliklerin üzerinde doğrusal bir katman) bulunan Levit Modeli, örneğin ImageNet için.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.LevitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L559)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LevitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanır).
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Görüntü sınıflandırma/geri dönüşüm kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels == 1` ise bir geri dönüşüm kaybı (Ortalama Kare kaybı) hesaplanır, `config.num_labels > 1` ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/main/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
**Dönüş:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) veya `tuple(torch.Tensor)`
[ImageClassifierOutputWithNoAttention](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[LevitForImageClassification](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassification) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her aşamanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, num_channels, height, width)`. Modelin her aşamanın çıktısındaki gizli durumları (aynı zamanda özellik haritaları olarak da adlandırılır).
Örnek:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassification.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
#### transformers.LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
```python
transformers.LevitForImageClassificationWithTeacher(config: LevitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L599)
**Parametreler:**
config ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
LeViT Model, en üstte görüntü sınıflandırma başlıkları (son gizli durumun üstünde doğrusal bir katman ve damıtma jetonunun son gizli durumunun üstünde doğrusal bir katman) ile birlikte, örneğin ImageNet için. .. warning:: Bu model yalnızca çıkarımı (inference) destekler. Damıtma ile ince ayar (yani bir öğretmenle) henüz desteklenmemektedir.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.LevitForImageClassificationWithTeacher.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L621)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LevitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [LevitImageProcessor](/docs/transformers/main/tr/model_doc/levit#transformers.LevitImageProcessor) kullanır).
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/main/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
**Dönüş:** `LevitForImageClassificationWithTeacherOutput` veya `tuple(torch.Tensor)`
`LevitForImageClassificationWithTeacherOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([LevitConfig](/docs/transformers/main/tr/model_doc/levit#transformers.LevitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[LevitForImageClassificationWithTeacher](/docs/transformers/main/tr/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- `cls_logits` ve `distillation_logits` değerlerinin ortalaması olarak tahmin puanları.
- **cls_logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma başlığının tahmin puanları (yani sınıf jetonunun son gizli durumu üzerindeki doğrusal katman).
- **distillation_logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Damıtma başlığının tahmin puanları (yani damıtma jetonunun son gizli durumu üzerindeki doğrusal katman).
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
Örnek:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassificationWithTeacher
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassificationWithTeacher.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```