# CLIPSeg
## Ikhtisar
Model CLIPSeg diusulkan dalam [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) oleh Timo Lüddecke dan Alexander Ecker. CLIPSeg menambahkan decoder minimal di atas model [CLIP](clip) yang dibekukan untuk segmentasi gambar zero-shot dan one-shot.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Segmentasi citra biasanya ditangani dengan melatih model untuk set kelas objek yang tetap. Menambahkan kelas tambahan atau kueri yang lebih kompleks kemudian menjadi mahal karena memerlukan pelatihan ulang model pada dataset yang mencakup ekspresi-ekspresi tersebut. Di sini, kami mengusulkan sistem yang dapat menghasilkan segmentasi citra berdasarkan prompt arbitrer pada saat pengujian. Prompt dapat berupa teks atau citra. Pendekatan ini memungkinkan kami untuk membuat model terpadu (dilatih sekali) untuk tiga tugas segmentasi umum, yang masing-masing memiliki tantangan yang berbeda: segmentasi ekspresi merujuk, segmentasi zero-shot, dan segmentasi one-shot. Kami membangun di atas model CLIP sebagai backbone yang kami kembangkan dengan decoder berbasis transformer yang memungkinkan prediksi padat. Setelah pelatihan pada versi yang diperluas dari dataset PhraseCut, sistem kami menghasilkan peta segmentasi biner untuk sebuah citra berdasarkan prompt teks bebas atau berdasarkan citra tambahan yang mengekspresikan kueri. Kami menganalisis berbagai varian prompt berbasis citra yang terakhir secara detail. Input hibrida yang baru ini memungkinkan adaptasi dinamis tidak hanya untuk tiga tugas segmentasi yang disebutkan di atas, tetapi untuk tugas segmentasi biner apa pun di mana kueri teks atau citra dapat dirumuskan. Terakhir, kami menemukan bahwa sistem kami beradaptasi dengan baik untuk kueri umum yang melibatkan affordances atau properti*
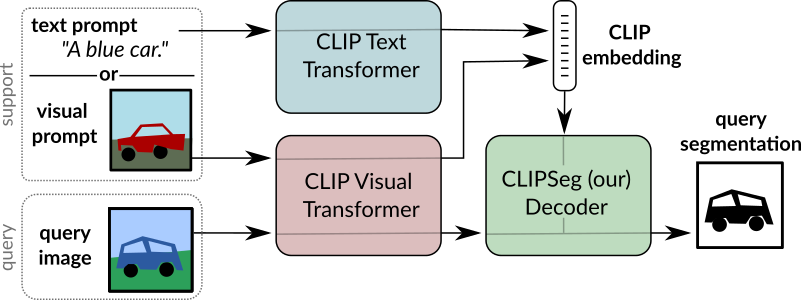 Ikhtisar CLIPSeg. Diambil dari makalah aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/timojl/clipseg).
## Tips penggunaan
- [CLIPSegForImageSegmentation](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) menambahkan decoder di atas [CLIPSegModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegModel). Yang terakhir ini identik dengan [CLIPModel](/docs/transformers/main/id/model_doc/clip#transformers.CLIPModel).
- [CLIPSegForImageSegmentation](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) dapat menghasilkan segmentasi gambar berdasarkan prompt arbitrer pada saat pengujian. Prompt dapat berupa teks
(disediakan ke model sebagai `input_ids`) atau gambar (disediakan ke model sebagai `conditional_pixel_values`). Anda juga dapat menyediakan embedding kondisional kustom (disediakan ke model sebagai `conditional_embeddings`).
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan CLIPSeg. Jika Anda tertarik untuk mengirimkan sumber agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber yang sudah ada.
- Notebook yang mengilustrasikan [segmentasi gambar zero-shot dengan CLIPSeg](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb).
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**Parameter:**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *opsional*) : Objek config atau dictionary dari text backbone.
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *opsional*) : Objek config atau dictionary dari vision backbone.
projection_dim (`int`, *opsional*, defaultnya `512`) : Dimensi dari lapisan proyeksi teks dan visi.
logit_scale_init_value (`Union[float, int]`, *opsional*, defaultnya `2.6592`) : Nilai awal dari parameter *logit_scale*.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
extract_layers (`list[int]`, *opsional*, defaultnya `[3, 6, 9]`) : Lapisan yang diekstrak saat meneruskan gambar kueri melalui tulang punggung visual beku dari CLIP.
reduce_dim (`int`, *opsional*, default 64) : Dimensi untuk mengurangi embedding visual CLIP.
decoder_num_attention_heads (`int`, *opsional*, defaultnya `4`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
decoder_attention_dropout (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
decoder_hidden_act (`str`, *opsional*, defaultnya `quick_gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
decoder_intermediate_size (`int`, *opsional*, defaultnya `2048`) : Dimensi dari representasi MLP.
conditional_layer (`int`, *opsional*, default 0) : Lapisan dari encoder Transformer yang aktivasinya akan digabungkan dengan embeddings kondisi menggunakan FiLM (Feature-wise Linear Modulation). Jika 0, lapisan terakhir yang digunakan.
use_complex_transposed_convolution (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan konvolusi transposed yang lebih kompleks di decoder, yang memungkinkan segmentasi yang lebih rinci.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari CLIPSegModel. Kelas ini digunakan untuk membuat instans model Clipseg berdasarkan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**Parameter:**
vocab_size (`int`, *opsional*, defaultnya `49408`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
hidden_size (`int`, *opsional*, defaultnya `512`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `2048`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `8`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
max_position_embeddings (`int`, *opsional*, defaultnya `77`) : Panjang maksimum urutan yang mungkin digunakan dengan model ini.
hidden_act (`str`, *opsional*, defaultnya `quick_gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-05`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
attention_dropout (`Union[int, float]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
pad_token_id (`int`, *opsional*, defaultnya `1`) : ID token yang digunakan untuk padding dalam kosakata.
bos_token_id (`int`, *opsional*, defaultnya `49406`) : ID token yang digunakan untuk awal aliran (beginning-of-stream) dalam kosakata.
eos_token_id (`Union[int, list[int]]`, *opsional*, defaultnya `49407`) : Token id yang digunakan untuk end-of-stream dalam kosakata.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari CLIPSegModel. Kelas ini digunakan untuk membuat instans model Clipseg berdasarkan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**Parameter:**
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `32`) : Ukuran (resolusi) dari setiap patch.
hidden_act (`str`, *opsional*, defaultnya `quick_gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-05`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
attention_dropout (`Union[int, float]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari CLIPSegModel. Kelas ini digunakan untuk membuat instans model Clipseg berdasarkan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/processing_clipseg.py#L24)
**Parameter:**
image_processor (`ViTImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`CLIPTokenizer`) : Tokenizer adalah input yang wajib.
Membangun CLIPSegProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[CLIPSegProcessor](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegProcessor) menyediakan semua fungsionalitas dari [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) dan [CLIPTokenizer](/docs/transformers/main/id/model_doc/clip#transformers.CLIPTokenizer). Lihat [~ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) dan [~CLIPTokenizer](/docs/transformers/main/id/model_doc/clip#transformers.CLIPTokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/processing_clipseg.py#L28)
**Parameter:**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`, `np.ndarray`, `torch.Tensor`, `list[PIL.Image.Image]`, `list[np.ndarray]`, `list[torch.Tensor]`) : Gambar prompt visual atau batch gambar yang akan disiapkan. Setiap gambar prompt visual dapat berupa gambar PIL, array NumPy, atau tensor PyTorch. Jika berupa array NumPy/tensor PyTorch, setiap gambar harus memiliki bentuk (C, H, W), di mana C adalah jumlah channel, dan H serta W adalah tinggi dan lebar gambar.
return_tensors (`str` atau [TensorType](/docs/transformers/main/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
**Mengembalikan:** [BatchEncoding](/docs/transformers/main/id/main_classes/tokenizer#transformers.BatchEncoding)
[BatchEncoding](/docs/transformers/main/id/main_classes/tokenizer#transformers.BatchEncoding) dengan bidang berikut:
- **input_ids** -- Daftar id token yang akan diberikan ke model. Dikembalikan ketika `text` bukan `None`.
- **attention_mask** -- Daftar indeks yang menentukan token mana yang harus diperhatikan oleh model (ketika `return_attention_mask=True` atau jika *"attention_mask"* ada di `self.model_input_names` dan jika `text` bukan `None`).
- **pixel_values** -- Nilai piksel yang akan diberikan ke model. Dikembalikan ketika `images` bukan `None`.
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**Parameter:**
config ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Clipseg polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([CLIPSegProcessor](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegProcessor) menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
return_loss (`bool`, *opsional*) : Apakah akan mengembalikan kerugian kontras (contrastive loss) atau tidak.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `True`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `CLIPSegOutput` atau `tuple(torch.Tensor)`
Sebuah `CLIPSegOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
Metode forward dari [CLIPSegModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `return_loss` bernilai `True`) -- Contrastive loss untuk kemiripan gambar-teks.
- **logits_per_image** (`torch.Tensor` dengan bentuk `(image_batch_size, text_batch_size)`) -- Skor hasil perkalian titik (dot product) yang telah diskalakan antara `image_embeds` dan `text_embeds`. Ini mewakili skor kemiripan antara gambar dan teks.
- **logits_per_text** (`torch.Tensor` dengan bentuk `(text_batch_size, image_batch_size)`) -- Skor hasil perkalian titik berskala antara `text_embeds` dan `image_embeds`. Ini mewakili skor kemiripan teks-gambar.
- **text_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding teks yang diperoleh dengan menerapkan lapisan proyeksi ke output terpool dari [CLIPSegTextModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding gambar yang diperoleh dengan menerapkan lapisan proyeksi ke output terpool dari [CLIPSegVisionModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [CLIPSegTextModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [CLIPSegVisionModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionModel).
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([CLIPSegProcessor](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegProcessor) menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `True`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**Parameter:**
config ([CLIPSegTextConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model teks dari CLIPSEG tanpa head atau proyeksi di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
Metode forward dari [CLIPSegTextModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**Parameter:**
config ([CLIPSegVisionConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model visi dari CLIPSEG tanpa head atau proyeksi di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([CLIPSegProcessor](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegProcessor) menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `True`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
Metode forward dari [CLIPSegVisionModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**Parameter:**
config ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model CLIPSeg dengan decoder berbasis Transformer di atasnya untuk segmentasi gambar zero-shot dan one-shot.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor). Lihat [ViTImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([CLIPSegProcessor](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegProcessor) menggunakan [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) untuk memproses gambar).
conditional_pixel_values (`torch.Tensor`, *opsional*) : Nilai piksel dari gambar kondisional.
conditional_embeddings (`torch.Tensor` dengan bentuk `(batch_size, config.projection_dim)`, *opsional*) : Embedding kondisional untuk gambar query. Jika disediakan, model akan menggunakan ini alih-alih menghitung embedding dari conditional_pixel_values.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
labels (`torch.Tensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Mask segmentasi ground truth, dengan nilai dalam `[0, 1]` dan ukuran spasial yang sama dengan `logits`. Loss binary cross-entropy dihitung antara logits prediksi dan mask ini.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `True`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `CLIPSegOutput` atau `tuple(torch.Tensor)`
Sebuah `CLIPSegOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([CLIPSegConfig](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegConfig)) dan input.
Metode forward dari [CLIPSegForImageSegmentation](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `return_loss` bernilai `True`) -- Contrastive loss untuk kemiripan gambar-teks.
- **logits_per_image** (`torch.Tensor` dengan bentuk `(image_batch_size, text_batch_size)`) -- Skor hasil perkalian titik (dot product) yang telah diskalakan antara `image_embeds` dan `text_embeds`. Ini mewakili skor kemiripan antara gambar dan teks.
- **logits_per_text** (`torch.Tensor` dengan bentuk `(text_batch_size, image_batch_size)`) -- Skor hasil perkalian titik berskala antara `text_embeds` dan `image_embeds`. Ini mewakili skor kemiripan teks-gambar.
- **text_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding teks yang diperoleh dengan menerapkan lapisan proyeksi ke output terpool dari [CLIPSegTextModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding gambar yang diperoleh dengan menerapkan lapisan proyeksi ke output terpool dari [CLIPSegVisionModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [CLIPSegTextModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [CLIPSegVisionModel](/docs/transformers/main/id/model_doc/clipseg#transformers.CLIPSegVisionModel).
Contoh:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```